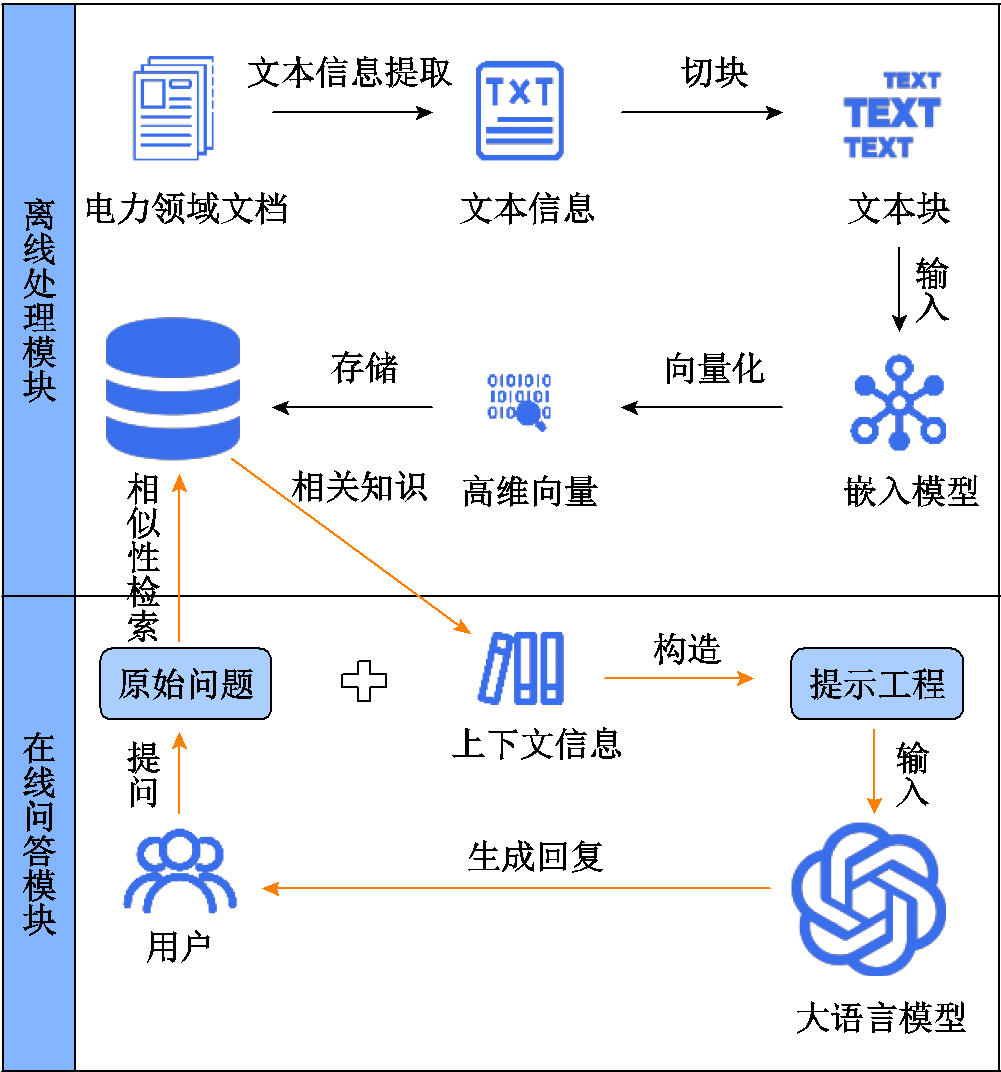
图1 基于检索增强生成的电力知识问答大模型框架
Fig.1 Power knowledge question-answering LLM framework based on retrieval-augmented generation
摘要 高效、准确地从海量电力领域信息中获取所需知识,是当前电力行业知识管理面临的重大挑战。大语言模型(LLMs)在自然语言理解和生成方面取得突破性进展,为知识问答提供了全新技术路径。但其在电力领域仍存在局限性,难以理解专业概念并容易产生知识“幻觉”。对此,该文提出一种基于大语言模型的电力领域知识问答方法,通过知识库增强与参数高效微调的双重机制,提升大语言模型在电力领域问答的准确性。首先,提出一种基于检索增强生成的电力领域知识问答大模型框架,包含离线知识库构建和在线问答推理两部分:离线模块负责对电力知识文档进行知识切分,并将其向量化存储以构建电力领域知识数据库;在线模块接收用户问题后从知识库中获取相关知识作为上下文,为大模型提供外部电力领域知识,缓解其专业知识不足的局限性。其次,提出基于样本增强与低秩矩阵分解(LoRA)微调的电力领域知识问答大模型优化方法,利用大语言模型的上下文理解与语义生成能力,生成电力领域知识的多样性表示;并且结合LoRA微调参数量少、计算成本低的优势,高效更新电力领域知识问答大模型,有效抑制“幻觉”问题。最后,以Qwen-7B模型为例,基于电力市场方向的真实问答集进行测试,实验结果表明应用该方法后可将其BERTScore指标的F1值从0.679提升至0.997,验证了所提方法的有效性。
关键词:大语言模型 电力知识问答 检索增强生成 样本扩充 参数高效微调
在“双碳”目标引领[1]与新型电力系统建设[2]的双重背景下,电力系统正加速推进数字化[3]、智能化[4]转型,海量的技术规范、设备手册、规章制度、研究报告等相关知识以指数级速度增长。如何高效、精准地从这些海量信息中获取所需知识,辅助电网人员进行问题定位和高效决策,已成为电力行业知识管理与应用面临的重大挑战。
传统的知识获取方式[5-6]主要基于关键词搜索、数据库查询等方法,这些方法虽然操作方式简单,但是在检索效率、全面性和精准性方面存在显著不足。例如,依赖关键词的精确匹配方式难以深入理解用户的真实意图,导致检索结果与用户需求匹配度差,用户需在大量冗余信息中不断筛选,费时费力、效率低下。近年来,以千问大模型(Qwen)[7]、深度求索(DeepSeek)[8]、百川大模型(BaiChuan)[9]、智谱清言(ChatGLM)[10]、GPT(Generative Pre-trained Transformer)[11]、BERT(Bidirectional Encoder Representations from Transformers)[12]等为代表的大语言模型(Large Language Models, LLMs)在自然语言理解和生成方面取得了突破性进展。大语言模型凭借其强大的语义理解、上下文学习和流畅的文本生成能力,在通用领域的知识问答[13]、文本摘要[14]、机器翻译[15]等方面展现出巨大潜力,为构建智能化的电力领域知识问答系统提供了新的技术途径[16]。
大语言模型虽然具备广泛的知识面,但是将其直接应用于电力这一高度专业化的垂直领域,仍存在明显的局限性[17]。它缺乏对电力领域专业知识的深入理解,容易产生“幻觉”问题[18],生成看似合理但实际上不准确甚至错误的信息。为了提升大语言模型在垂直领域的知识问答性能,现有方法主要分为两类:基于外部知识增强的方法和基于模型自身优化的方法。
在外部知识增强方面,利用检索增强生成(Retrieval-Augmented Generation, RAG)技术[19],从外部信息源中检索相关信息来增强LLMs的能力,从而提高生成内容的相关性和质量。RAG相较于微调(Fine-Tuning, FT)不需要对模型重新进行训练,仅通过更新外部知识库来适应知识的变化,节省了大量计算资源。目前,RAG的研究正处于快速发展阶段,主要集中在优化检索环节以提高捕获相关信息的精度和效率。其中,知识切分的质量是影响检索准确性的关键因素,常见的切分策略是将文档按照固定数量的词元(token)(如100、256、512)进行分割,这种方式难以保证知识块的语义完整性。为解决这一问题,文献[20]使用Small2Big模型,从细粒度的文本单元(如句子)开始检索,然后逐步扩大检索范围到更大的文本单元(如文本块)。文献[21]提出了一种元分块框架,该框架一方面识别最优分割点,另一方面保留全局信息,在细粒度和粗粒度文本分块之间取得了平衡。而文献[22]提出了一种不分块的上下文检索方法,将用户查询和长文档直接输入LLMs,通过预测token的概率来识别最相关的段落,但对计算资源的需求更高。此外,也有研究人员对初步检索后获取的大量候选知识进一步精炼,提高输入LLMs的上下文质量。文献[23-24]利用交叉编码器对初步召回的知识块再次进行相关性评分,将最相关的片段前移。文献[25]通过训练一个小型上下文过滤模型,基于词汇和信息论方法识别有用的上下文,缩短了输入LLMs的上下文长度。综上可见,RAG通过动态引入外部专业知识,能够有效缓解LLMs的“幻觉”问题,然而其性能依赖知识切分的语义完整性与被检索出上下文的精确度。因此,如何从版式复杂的电力文档中准确地提取信息,并将其切分为语义完整的知识片段以供检索,是RAG在电力领域应用前需要解决的关键问题。
在模型自身优化方面,则通过重新训练模型以适应特定领域,即微调大语言模型,从参数规模上可以分为全参数微调[26]和参数高效微调(Parameter-Efficient Fine-Tuning, PEFT)[27]。全参数微调的核心思想是通过下游任务数据集来更新LLMs的全部或绝大部分参数,这种方法能够最大限度地挖掘模型的潜力,使其深度融合领域知识,在特定任务上达到最优性能[28]。但由于LLMs参数量通常高达1011甚至1012级别,更新全部参数需要消耗极高的计算资源,且针对不同的下游任务进行微调都需要存储一份完整的模型权重副本,导致存储成本高昂。PEFT方法通过仅更新或引入少量参数对LLMs进行微调,在显著降低计算和存储开销的同时,达到与全参数微调相近的性能。目前,研究人员探索了多种不同的参数高效微调方式,主要包括向模型中插入小型适配器模块[29]、对模型的输入词元添加前缀参数[30]、仅微调部分层[31]以及通过低秩矩阵分解(Low-Rank Adaptation, LoRA)[32]等方法实现参数更新。在众多PEFT方法中,LoRA因其可在保证性能的同时大幅降低计算与存储负担,被广泛应用于多种垂直领域任务[33]。但在电力领域中,其效果因训练样本数量稀缺而受到限制,因此,有必要基于LoRA方法进一步探索电力领域知识问答大模型的微调方法。
综上可见,尽管LLMs的相关研究已十分丰富,但基于LLMs实现电力领域的知识问答[34]仍存在挑战:一是针对电力领域中的标准、规程等非结构化文档,如何进行有效的知识提取和表示,建立电力领域知识库,并与RAG机制进行有效融合;二是电力领域高质量问答样本获取成本高、数量少,限制了微调的效果,如何构建高质量的问答微调数据集,并基于LoRA方法对大语言模型进行微调。
针对上述挑战,本文提出基于大语言模型的电力领域知识问答方法,通过外部知识库增强与内部参数高效微调的双重机制,有效缓解大语言模型的“幻觉”问题。具体贡献如下:
1)提出了一种基于检索增强生成(RAG)的电力领域知识问答大模型框架。该框架首先设计了一种基于大语言模型的电力文本信息自适应提取方法,能够高效地对电力文档进行版面解析并提取其文本信息;其次,依据文档的标题层级结构对其进行递归切分,确保知识块切分的语义完整性,并构建高质量的电力领域知识库;最后,在此基础上,通过设计提示词引导大语言模型充分理解和利用这些电力领域知识,显著提升大语言模型问答的准确性。
2)提出了一种基于样本增强与LoRA微调的电力领域知识问答大模型优化方法。该方法首先利用大语言模型强大的文本生成能力对原始问答对样本进行扩充,改变原始文本信息的文字表述而不改变其语义,通过这种方法规模化地扩充训练样本,能够有效解决电力领域问答对数据稀缺的问题;然后,将问题与检索到的相关知识相结合并作为训练样本的输入,构建与检索增强机制实际输入结构一致的样本结构;最后,在基于LoRA微调训练大语言模型理解电力领域知识的同时,也增强其利用外部检索信息生成准确回复的能力。
本节构建了一个基于检索增强生成的电力领域知识问答大模型框架,如图1所示。该框架通过引入外部电力专业知识库提升大语言模型在电力领域的知识问答效果,将原始的非结构化文档转换为易于检索和理解的知识片段,并存储到向量数据库中,当接收到用户输入的问题后,在知识库中检索出相关知识,协助大语言模型进行推理。
图1 基于检索增强生成的电力知识问答大模型框架
Fig.1 Power knowledge question-answering LLM framework based on retrieval-augmented generation
针对电力领域知识问答对准确性、专业性及可追溯性要求高的特点,本文构建了一个适用于电力领域知识问答的检索增强生成框架(PowerRetrieval-Augmented Generation, P-RAG)。该框架由离线处理模块和在线问答模块两部分构成。
离线处理模块首先使用基于大语言模型的自适应文本信息提取方法对相关电力文档进行版面解析与文本信息提取,进而依据文本中的标题层级结构(如章、节、条)进行知识切分,并将切分得到的文本知识块编码为向量,存储到向量数据库中以构建电力领域向量知识库。这一过程旨在将非结构化的电力文档转换为易于检索的知识片段。
在线问答模块接收到用户输入的问题时,首先在离线阶段构建的知识库中检索与用户问题最相关的知识块,随后将用户问题与检索到的知识块作为上下文,构造提示词输入大语言模型,大语言模型基于提供的上下文进行推理,输出对用户问题的回复。
该框架的核心在于将外部的电力领域知识与大语言模型强大的自然语言理解和生成能力相结合,有效地应对通用大语言模型在电力领域专业知识不足和易产生“幻觉”的问题。
向量知识库是整个知识问答的基础,其质量直接影响在线问答模块的检索精度与生成效果。构建电力领域向量知识库是从原始的非结构化电力领域文档到结构化、可计算的向量表示的转换过程。具体而言,电力领域向量知识库构建包括三个核心环节:首先,采用自适应文本信息提取方法对电力文档进行版面解析与文本信息抽取;其次,基于文档的标题层级结构的知识分块策略,将长篇文本切分为长度适中、语义完整的知识单元;最后,通过文本向量化技术将知识块映射为高维语义向量并存储到向量数据库中,为后续的智能问答任务奠定基础。
1.2.1 自适应文本信息提取方法
电力行业的标准、报告、论文等文档是重要的知识载体,且格式多样,包含大量非结构化文本、公式及特定的版式元素。在处理这些复杂文档时,常面临公式识别困难、冗余信息干扰及跨页内容整合不便等问题。为解决这些挑战,本文借助大语言模型进行自适应文本信息提取,通过设计合理的提示词使大语言模型对文档进行版面解析并提取其文本信息,本文设计了如下提示词:
“你是一个文本信息智能抽取专家,擅长从PDF或图像文件中提取核心文本信息并进行规范化处理。请严格按照以下要求对上传的文档进行处理:
①准确识别文档每页中的正文、标题、公式、图表注释等有效信息;
②自动识别并剔除所有页眉、页脚、页码等非正文内容;
③将上下结构的分式公式规范为“分子/分母”格式表示,必要时添加括号以确保表达清晰、准确;
④保留文档的核心排版结构,例如标题层级、段落划分等;
⑤将处理后的各页内容按文档原顺序合并,输出为完整的连续文本。
请直接输出结果内容,无需生成额外的解释。”
借助大语言模型进行文本信息提取,能够显著提高文本处理的效率与规范性,从而为后续的知识分块和向量化奠定基础。
1.2.2 知识分块
提取出整篇文档的文本信息后,需要将其分割成大小适中、语义完整的知识块,以便于向量化模型高效捕捉其语义信息,并适应大语言模型处理上下文的长度限制。传统的固定长度分块或按段落、句子分块的方法,容易割裂完整的语义单元,影响信息检索精度和问答效果。为此,本节提出基于文档标题层级结构的知识分块策略,流程如图2所示。
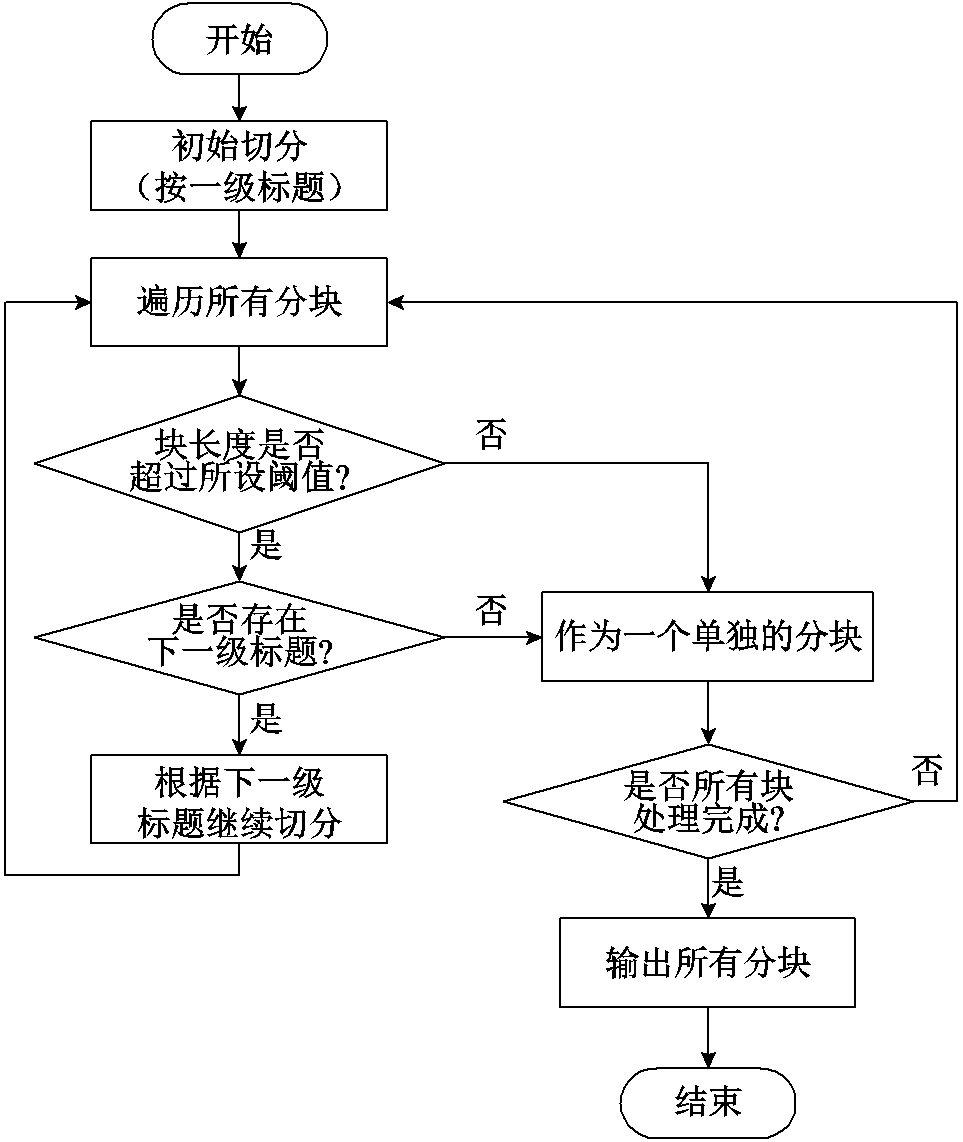
图2 基于文档标题层级结构的知识分块策略流程
Fig.2 Flow chart of knowledge blocking strategy based on the hierarchical structure of document titles
基于文档标题层级结构的知识分块策略步骤如下:
1)初始化分块。首先依据文档中的最高层级标题(一级标题如“第1章”“1.”等)对整个文档进行初步分割,形成一组粒度较粗的知识块。
2)长度校验。对每个知识块先判断其长度是否超过预设的最大阈值,如果未超过,则将该知识块直接纳入最终的分块结果集合,否则进一步切分。
3)递归切分。判断步骤2)中长度超出阈值的知识块是否存在下级标题,若存在,则依据下级标题将该块细分为更小的子块,并将子块返回步骤2)进行校验;若不存在,为最大限度地保证其语义完整性,该知识块亦被纳入最终的分块结果集合。
4)输出结果。所有知识块及其子块均处理完毕后,即得到最终的知识分块结果集合。
该分块策略的核心优势在于尊重文档本来的结构,避免了跨主题内容的强行切分,生成的知识块语义完整性更好,有利于提升后续向量表示的质量。
1.2.3 向量数据库构建
向量数据库的构建包括文本信息的向量化和存储。向量化是将文本知识块通过向量化模型映射到高维向量空间中,并以向量表示该文本知识块,语义相近的文本在向量空间中距离更近。考虑到本文处理的电力文本以中文为主,且包含大量专业术语和复杂的句式,因此本文选择m3e(Moka Massive Mixed Embedding)模型进行知识块向量化。m3e模型是近年来在中文文本处理任务中表现突出的嵌入模型之一,它通过大规模中文语料上的优化,能够更有效地捕捉中文的细微语义差别。将知识块输入m3e模型中计算,即可得到其对应的高维嵌入向量。
本文采用FAISS(Facebook AI Similarity Search)向量数据库来存储电力知识的向量表示。FAISS是一个由Facebook AI研究院开发的专为稠密向量相似性搜索和聚类的开源数据库,其核心优势在于高效的性能优化:针对大规模向量数据集提供了高度优化的算法实现,即使在1010级别的向量规模下也能实现ms级的检索响应。通过采用m3e模型进行文本信息向量化,并利用高性能的FAISS库进行存储,最终构建了一个结构化、可高效检索的电力领域知识向量数据库,为后续对用户的查询内容进行相关信息检索提供了坚实可靠的数据基础。
1.3.1 检索策略
在线问答阶段,当用户输入一个问题Q时,需要从电力领域向量知识库中快速检索到与之最相关的知识块,本文使用基于向量相似性的搜索方法来实现这一目的。首先,使用m3e模型将用户问题Q转换为向量vQ,然后在电力领域向量知识库中执行相似性搜索,找到与vQ相似度分数最高的前K个向量,并返回其对应的文本知识块。本文使用余弦相似度Scos作为量化两个向量va和vb相似性的标准,即
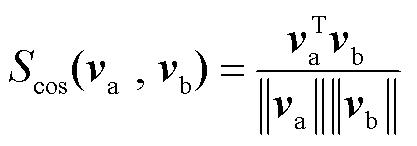 (1)
1.3.2 提示工程设计
提示工程是大语言模型执行特定任务的关键技术,其核心在于设计有效的提示词以引导大语言模型生成预期输出。在本文的P-RAG框架中,提示工程的作用是将用户问题与检索到的相关电力知识有效结合,构建提示词输入大语言模型,明确指示模型根据提供的电力知识生成准确的回复。本文设计的提示词包含以下关键要素。
1)系统提示词:为大语言模型设定一个特定的“角色”和行为规范。例如,可以设定大语言模型为一个“专业的电力领域知识问答助手”。此外,系统提示词还包含一些强制性的指令,例如,要求模型严格参考提供的上下文信息进行回答,以及如果上下文信息不足以回答问题,要明确指出并停止生成,不要自行编造信息。这些指令能够约束模型行为,减少“幻觉”现象。
2)上下文信息:检索出与用户问题最相关的前K个知识块的集合。为了将其与用户问题进行区分,本文使用特定的标记(如<上下文信息>和)将其包裹起来。
3)用户问题:用户输入的原始问题查询。同样可以使用标记(如<用户问题>和)将其与上下文信息进行区分。
4)最终指令:通常位于提示词末尾,用于向模型发出最终执行命令,例如,“请根据上面提供的上下文信息,回答用户问题”。
将上述关键要素组合起来,形成输入大语言模型的完整提示词,其基本构造模式如下:
“<系统提示词>
<上下文信息>
[检索到的知识块]
<用户问题>
[用户的原始查询]
<最终指令>”
1.3.3 在线推理
处理用户实时问答请求的流程如下:
1)从电力知识库中检索出与问题向量vQ最相关的前K个知识片段c1~cK,按相关性分数排序拼接成上下文C=c1Åc2Å…ÅcK(Å代表知识片段的文本拼接操作),需要注意的是,不是所有的知识片段都能够帮助模型回复问题,其中有的片段包含问题的正确答案,有的片段只是部分相关且包含冗余信息。
2)将用户问题Q和检索知识库得到的相关上下文C相结合,构造提示词输入大语言模型。
3)大语言模型要在这部分混杂着有效信息和冗余信息的知识中进行推理,模型需要真正理解问题,过滤无关的干扰内容,辨别出真正能够回答问题的关键信息,然后输出最终回复O。
4)将模型的输出O返回用户。
第1节构建的基于检索增强生成的电力领域知识问答大模型框架能够为大语言模型提供相关的电力领域知识,但模型最终回复的准确性取决于其对电力领域知识的理解深度和从冗余信息中提取关键点的能力。为了进一步提升大语言模型在电力领域知识问答任务上的表现,本节提出基于样本增强与LoRA微调的电力领域知识问答大模型优化方法,通过扩充高质量的微调样本集为模型微调提供丰富的训练资源,并构建与检索增强生成机制实际输入结构一致的样本结构,采用LoRA微调方法对大语言模型进行优化,详述如下。
微调是提升大语言模型在电力领域表现的关键技术,但是由于电力领域问答对数据稀缺,可用于微调的训练样本数量少,严重制约了微调的效果。为解决该问题,本文提出一种基于大语言模型的微调样本集扩充方法,利用大语言模型强大的文本理解和生成能力,对已有的高质量种子样本进行多样化改写,从而实现微调样本数量的规模化扩充。主要步骤如下。
1)构建高质量种子样本集。首先,通过人工标注的方式从现有的电力领域文档中构造一个规模相对较小的种子样本集Sseed={s1, s2,…, sm}。每个种子样本si(i=1,2, …,m)的形式为<问题Qi, 标准答案Zi>,标准答案Zi是对问题Qi的回答。
2)设计利用大语言模型进行样本改写的提示词,引导大语言模型对输入的种子样本进行文本表述的改写,提示词示例如下:
“你是一个专业的样本改写助手,擅长在不改变原始语义的前提下,对问答对样本进行多样化表达的改写。请你完成以下任务:
①对给定的原样本进行改写;
②改写后的样本须保持原样本的基本语义不变;
③改写后的内容长度应与原样本大致相同;
④请直接输出改写后的样本内容,无需包含说明。
原样本:{人工标注的种子样本}
改写后的样本:”
3)执行批量改写。将种子样本集Sseed中的每一个样本si作为输入,结合设计的样本改写提示词,调用大语言模型进行批量处理。
该方法有效地缓解了电力领域微调样本数量少的问题。此外,由于改写过程引入了文字、语序等方面的变化,增强了训练样本的多样性,使得模型在微调过程中能够接触到对同一查询意图的不同表达形式,从而提高了模型对用户查询语言变化的鲁棒性,使其在面对相同问题的不同表述时仍能准确理解语义并做出回答。
对使用P-RAG框架的问答方法而言,微调数据集的构造不仅需要包含电力领域知识本身,更重要的是训练模型理解“根据提供的上下文回答问题”这一特定任务。为此,本文采用“输入:问题Q+检索出的上下文C,输出:标准答案Z”的微调样本构造方式,其中上下文C是从电力领域知识库中根据问题Q检索到的相关知识。这种方式保证了微调样本与P-RAG框架实际输入结构的一致性,能够提高模型从用户问题及相关知识中提取关键信息并生成准确回复的能力。
通过2.1节的方法,本文获得了更丰富的微调样本集,为模型微调奠定了数据基础。考虑到大模型巨大的参数量以及全参数微调所需的高昂成本,本节将采用LoRA策略对大模型进行微调,使其更好地适应电力领域的知识问答任务。
LoRA微调示意图如图3所示,其核心思想在于冻结大语言模型的权重矩阵W0ÎRd×k,并在其旁
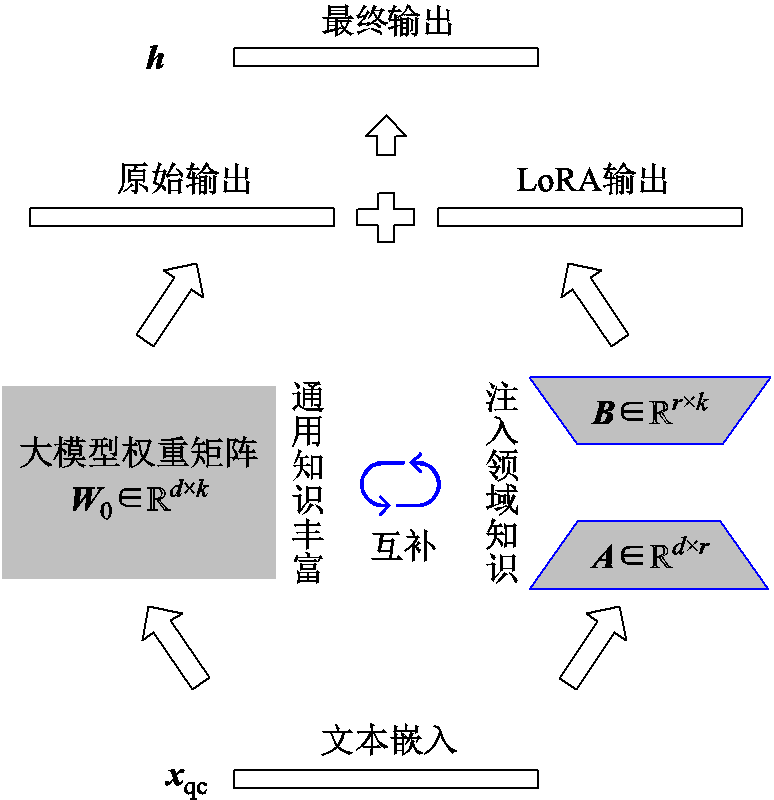
图3 LoRA微调示意图
Fig.3 LoRA fine-tuning diagram
边引入两个低秩矩阵AÎRd×r和BÎRr×k来模拟微调带来的权重矩阵变化ΔW=AB。其中,r为一个远小于min(d, k)的超参数,d和k为权重矩阵W0的维度。训练时,模型的原始权重矩阵W0保持不变,仅对LoRA旁支矩阵A和B进行参数更新,为大语言模型注入电力领域知识。
以电力领域的问答对作为训练样本,其输入文本被编码为d维的向量xqc,应用LoRA后的输出h为
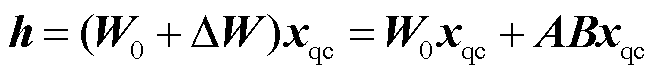 (2)
由式(2)可以看到,新增了一条计算路径ABxqc与原始路径W0xqc并行。W0xqc是经过大模型原始权重矩阵得到的输出,ABxqc是经过旁支矩阵得到的输出,两者相加得到经LoRA微调后的最终输出,既保留了大模型自身强大的自然语言理解能力,又引入了在训练中学习到的电力领域知识,实现了通用知识和电力领域知识的互补。
实际中,通常会对ABxqc乘以一个缩放因子α/r来平衡LoRA路径对原始模型输出的影响,此时应用LoRA后的最终输出h变为
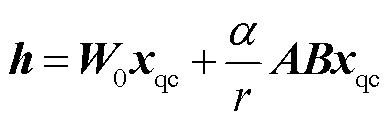 (3)
式中,α为一个可调节的超参数。
LoRA微调的目标是使模型预测的答案尽可能地接近真实答案。预测答案与真实答案之间的差异可以通过损失函数来计算,而交叉熵损失函数正是度量模型预测的概率分布与真实分布之间差异的标准方法。对于长度为T的答案序列Y={y1, y2,…, yT},在生成第t个词元yt时,其交叉熵损失Lt的形式为
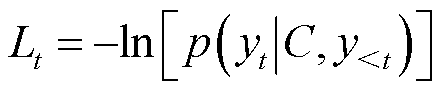 (4)
式中,p(yt|C, y<t)为模型在给定上下文信息C以及已生成的部分答案y<t的条件下,预测下一个词元为真实词元yt的概率。各词元位置对应损失的平均值便是整个答案序列Y的总损失L,表示为
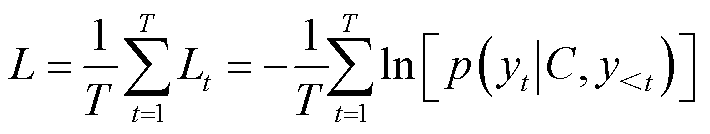 (5)
式中,L为在微调过程中需要最小化的损失函数。在训练过程中,根据该损失函数计算模型预测损失值,并通过反向传播机制更新LoRA旁支矩阵A和B中的参数。
训练完成后,仅需保存轻量级的LoRA适配器权重文件,即可用于后续的在线推理。相比于全参数微调需要更新W0共d´k个参数,LoRA仅需更新矩阵A和B的参数,总参数量为(d+k)´r,可极大地降低计算和存储成本。
为验证本文方法的有效性,面向真实电力场景进行查询问答。本文通过收集电力领域相关知识文档,经过人工标注构建高质量电力领域知识问答对。包含规章制度、安全管理、电力设备使用、电力市场等多方面的知识,共计100个问答对,主要用作测试集,以衡量不同模型和方法在实际电力问答任务中的表现。此外,为了对模型进行微调,本文根据2.1节提出的基于大语言模型的微调样本集扩充方法构建了1 016个微调训练样本。
目前问答任务常见的评估指标包括精确匹配率(Exact Match, EM)、双语替换评估(BilingualEvaluation Understudy, BLEU)、偏重召回率的摘要替换评估(Recall-Oriented Understudy for Gisting Evaluation, ROUGE)、精确度(Precision, P)、召回率(Recall, R)、调和平均值(F1-score)等。其中BLEU和ROUGE是基于严格的词汇匹配,EM更是要求完整文本的精确匹配。由于本文问答任务的标准答案均为文本段落,这些指标只考虑了词汇层面的一致性,而忽略了文本之间语义层面的一致性。因此,本文采用基于BERT的语义相似度评估指标(BERTScore)[35],它基于模型生成答案与标准答案的向量表示计算两者之间的相似度分数,优势在于可以有效地处理同义词和句式变换等情况,更适合本文的问答任务。
给定标准答案序列Z={z1, z2,…, zn}和模型生成答案序列O={o1, o2,…, ol},其中,n和l分别为两个序列中的词元个数,利用预训练模型BERT获得两者各词元对应的向量表示,分别记为zi和oj,并计算两者之间的语义相似度。BERTScore主要包含召回率R、精确度P和F1值三个指标,表达式分别为
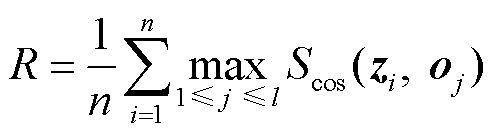 (6)
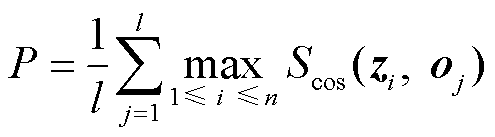 (7)
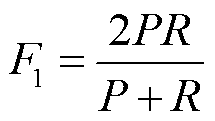 (8)
式中,R、P、F1分别为召回率、精确度和F1值;Scos(zi, oj)为标准答案中第i个词元的向量表示zi与模型输出答案中第j个词元的向量表示oj的余弦相似度。召回率表示计算模型生成答案中每个词元与标准答案中词元的最大相似度之和,并除以标准答案词元的总数。精确度表示计算标准答案中每个词元与模型生成答案中词元的最大相似度之和,并除以模型生成答案词元的总数。F1值则是精确度和召回率的调和平均数,它综合了二者的平衡。
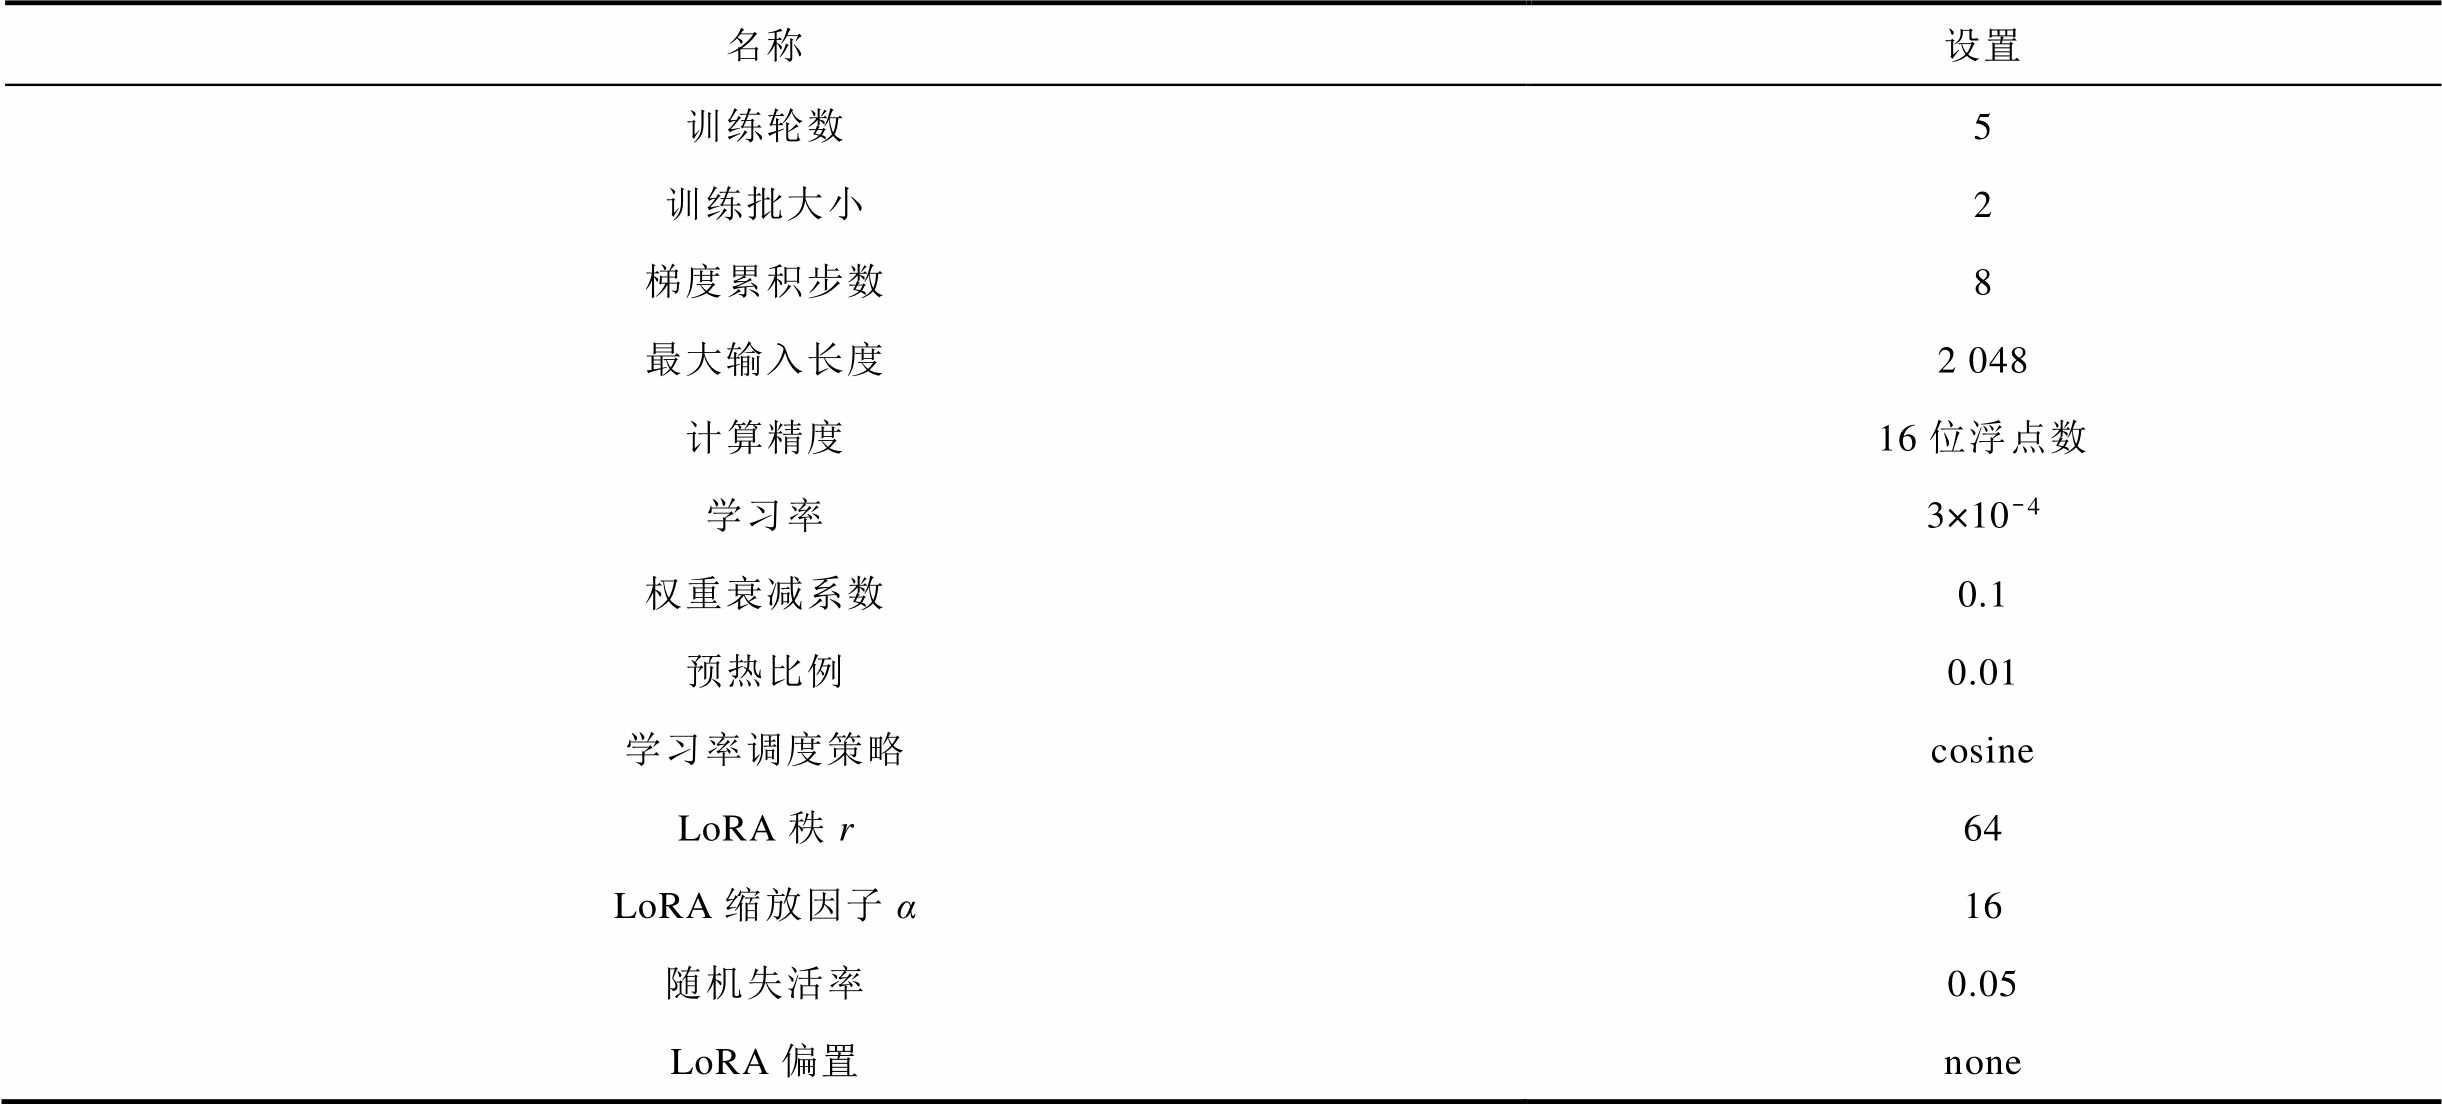
本文在Qwen系列(包括Qwen-1.8B和Qwen- 7B)模型和ChatGLM3-6B模型上采用LoRA方法进行参数高效微调,详细的训练参数配置见表1。
表1 LoRA微调设置
Tab.1 LoRA fine-tuning configuration
名称设置 训练轮数5 训练批大小2 梯度累积步数8 最大输入长度2 048 计算精度16位浮点数 学习率3×10⁻⁴ 权重衰减系数0.1 预热比例0.01 学习率调度策略cosine LoRA秩r64 LoRA缩放因子α16 随机失活率0.05 LoRA偏置none
本文中所有实验均在AutoDL的云服务器实例上完成测试。具体配置为:1张vGPU-32 GB显卡、Intel(R) Xeon(R) Platinum 8352V CPU @ 2.10 GHz、90 GB内存。
3.4.1 电力知识大模型问答框架的有效性验证
为验证本文P-RAG框架在不同大语言模型上的普遍有效性,本实验对一系列的大语言模型(BaiChuan2-7B、BlueLM-7B、Qwen-7B、ChatGLM3- 6B及DeepSeek-R1-Distill-Qwen-7B)进行了对比测试,评估原始模型直接回答问题和结合电力知识问答框架(P-RAG)回答问题的效果,具体情况见表2。
表2 不同大语言模型的问答性能对比
Tab.2 Comparison of question-answering performance among different LLMs

模型名称P-RAGBERTScore PRF1 BaiChuan2-7B×0.6790.6930.685 √0.9100.8800.894 BlueLM-7B×0.7170.6810.697 √0.9200.8230.866 ChatGLM3-6B×0.6710.6890.679 √0.9280.9080.917 Qwen-7B×0.7020.6600.679 √0.9480.8720.906 DeepSeek-R1-7B×0.6280.6890.656 √0.8160.8030.808
从表2中结果可以看出,所有参评模型结合P-RAG框架后的性能都在电力领域知识问答任务上取得了显著提升。以Qwen-7B模型为例,使用原始模型进行问答测试时,其F1值为0.679,而结合P-RAG后,F1值大幅提升至0.906,提升幅度高达0.227,其他模型也展现出类似的趋势,各参评模型结合P-RAG框架后,F1值提高0.152~0.238。实验结果验证了本文所提基于检索增强生成的电力领域知识问答大模型框架能够为通用大语言模型赋能,使其在无需进行电力领域微调的情况下,亦可显著提升模型在电力领域知识问答任务上的性能。
3.4.2 P-RAG框架各模块的有效性验证
为进一步验证所提P-RAG框架各模块的有效性,本实验使用结合框架后性能表现最佳的ChatGLM3-6B模型,并进行如下实验设置。
1)使用传统光学字符识别(Optical Character Recognition, OCR)技术代替本文的自适应文本信息提取方法,记为OCR。
2)采用固定长度(512 tokens)分块策略替代本文的基于文档标题层级结构的切分策略,记为Chunkfixed。
3)简化提示词,去除系统提示词和最终指令,只包含上下文信息和问题,记为Promptsimple。
4)本文所提基于检索增强的电力领域知识问答大模型框架,即P-RAG。
图4展示了不同设置下的实验结果,结果表明,将本文所提自适应文本信息提取方法替换为传统OCR技术时,F1值下降0.137,说明了高质量文本信息提取对后续处理的重要性。使用固定长度分块策略替代本文基于文档标题层级结构的切分策略时,F1值下降0.118,证明切分知识的语义完整性对于后续检索也至关重要。当简化提示词后,F1值也下降了0.074,这表明本文精心设计的提示词能有效地引导模型利用上下文生成准确回复。
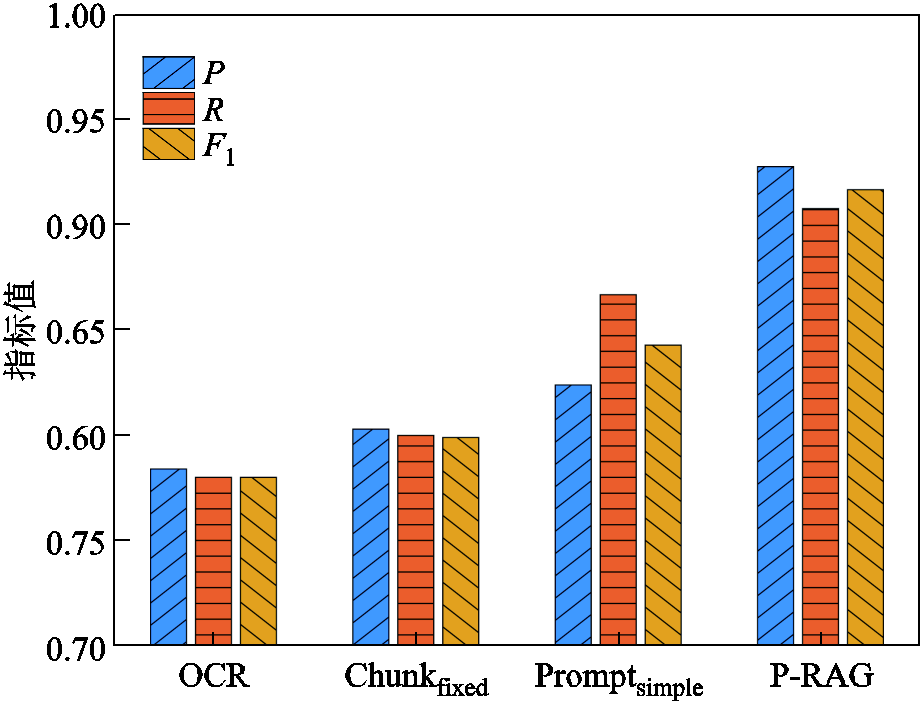
图4 P-RAG各模块消融实验
Fig.4 Ablation experiments of each module in P-RAG
3.4.3 大语言模型优化方法的有效性验证
为验证本文所提微调方法的有效性,本实验以Qwen(Qwen-1.8B和Qwen-7B)和ChatGLM3-6B模型为基础,对比了以下五种组合的问答性能。
C1:基础模型,用于参考模型的原始能力。
C2:使用传统的<问题, 标准答案>形式的微调样本,采用LoRA方法对基础模型进行微调。
C3:基础模型C1结合本文所提P-RAG框架。
C4:C2微调后的模型结合本文所提P-RAG框架。
C5:本文所提方法,使用<问题+检索出的上下文, 标准答案>形式的微调样本,采用LoRA方法对基础模型进行微调,并结合P-RAG框架。
表3展示了不同组合方式下的问答性能对比。从表3中结果可见,C2和C4分别是在C1和C3的基础上对模型进行了常规微调,性能均有所下降。本文分析导致这一现象的原因可能是训练样本的输入与实际推理时的输入形式不匹配。常规微调时训练样本的输入仅为“用户问题”,而应用P-RAG框架后的实际输入是“用户问题+相关上下文”,与训练时存在冲突。针对此,本文所提方法C5采用符合P-RAG框架实际输入结构<问题+上下文, 答案>的样本形式对模型进行微调,使问答性能进一步得到提升,各参评模型F1值提高0.024~0.124。
为进一步验证上述实验结果,图5中展示了ChatGLM3-6B、Qwen-7B和Qwen-1.8B三个模型在两种微调方法下的损失曲线(实线:本文微调方法C5,虚线:常规LoRA微调C2和C4)。对比同一模型的损失曲线,本文所提C5的损失值始终低于C2,证明了本文方法能够有效提升微调效果。在训练耗时方面,两种微调方法下的差异不大,ChatGLM3-6B、Qwen-7B和Qwen-1.8B三个模型耗时分别约为3、3、1.5 h,说明本文方法在提升微调性能的同时几乎没有增加训练时间成本。对比不同模型在C5下的损失曲线,Qwen-7B模型的收敛速度最快且最终损失值最低,优于另外两个模型。
表3 不同组合方式下的问答性能对比
Tab.3 Comparison of question-answering performance under different combinations

组合方式模型名称BERTScore PRF1 C1Qwen-1.8B0.6910.6750.682 Qwen-7B0.7020.6600.679 ChatGLM3-6B0.6710.6890.679 C2Qwen-1.8B0.6580.6900.672 Qwen-7B0.6700.6850.676 ChatGLM3-6B0.6620.6880.674 C3Qwen-1.8B0.9240.8320.873 Qwen-7B0.9480.8720.906 ChatGLM3-6B0.9280.9080.917 C4Qwen-1.8B0.8360.8210.826 Qwen-7B0.8840.8630.871 ChatGLM3-6B0.8270.8030.813 C5Qwen-1.8B0.9960.9970.997 Qwen-7B0.9970.9970.997 ChatGLM3-6B0.9420.9410.941
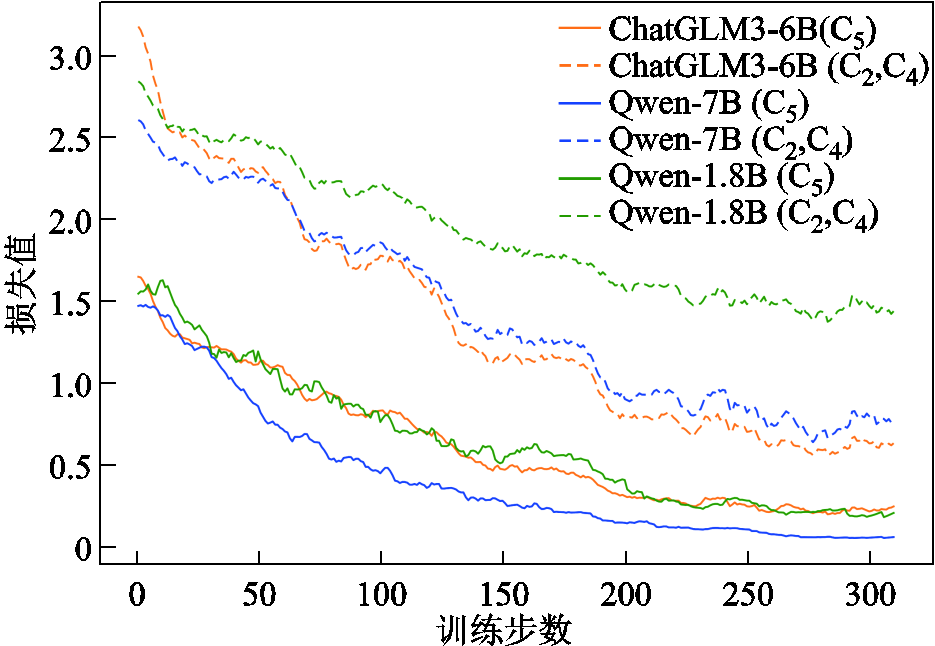
图5 不同模型微调过程中的损失函数变化曲线
Fig.5 Loss function curves during fine-tuning of different models
3.4.4 样本扩充对微调效果的有效性验证
本实验在相同的超参数配置下,分别使用未经过扩充的原始样本集(412个样本)和经大语言模型改写扩充后的样本集(1 016个样本)对Qwen-7B模型进行LoRA微调,并在相同测试集上进行评估,不同样本规模下的微调效果对比如图6所示。可以看到,当训练样本从412个增加到1 016个时,模型的各项性能指标均有较大提升。其中,F1值提升了0.039,召回率提升了0.055,精确率提升了0.020,可见采用本文所提样本扩充方法能有效提升模型微调的效果。
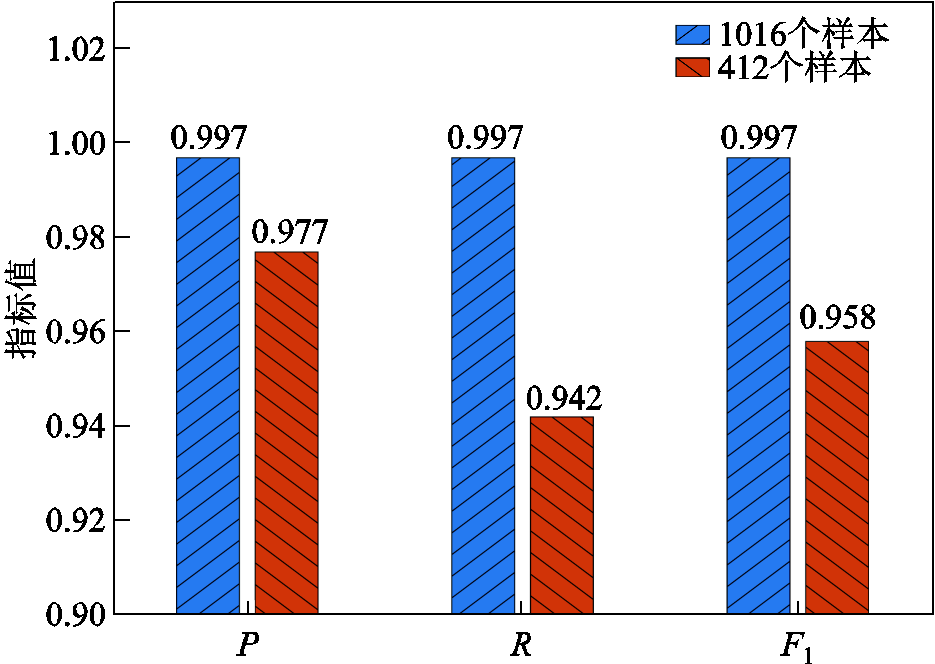
图6 不同样本规模下的微调效果对比
Fig.6 Comparison of fine-tuning effects under different sample sizes
3.4.5 微调参数量的影响分析
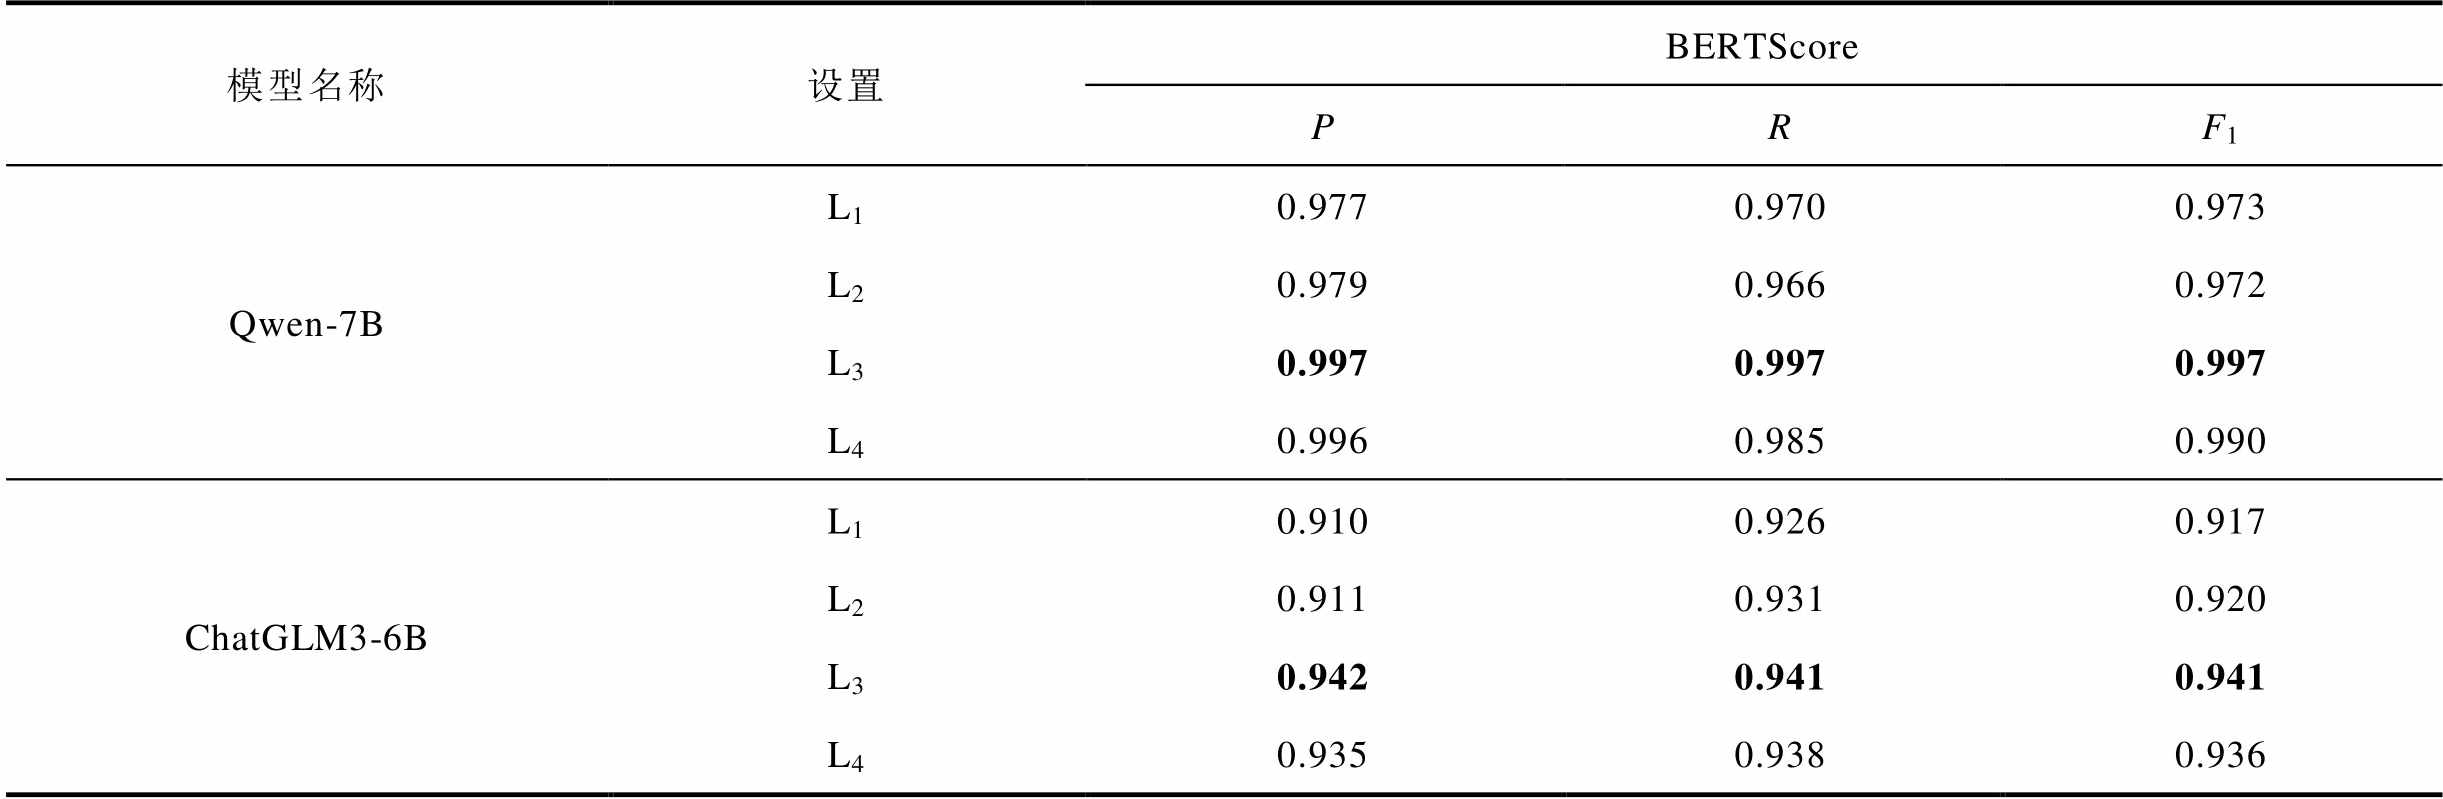
为对比分析不同微调参数量的影响,本文设计四种不同参数量的微调设置,实验结果见表4。
表4 不同参数量的微调效果对比
Tab.4 Comparison of fine-tuning effects with different parameter quantities
模型名称设置BERTScore PRF1 Qwen-7BL10.9770.9700.973 L20.9790.9660.972 L30.9970.9970.997 L40.9960.9850.990 ChatGLM3-6BL10.9100.9260.917 L20.9110.9310.920 L30.9420.9410.941 L40.9350.9380.936
L1:仅在注意力层的查询、键、值矩阵上应用LoRA(参数占比约为0.43%)。
L2:在L1的基础上,对注意力层的输出投影矩阵应用LoRA(参数占比约为1.04%)。
L3:在L2的基础上,对前馈神经网络的降维层应用LoRA(参数占比约为1.43%)。
L4:在L3的基础上,对前馈神经网络的输出投影矩阵应用LoRA(参数占比约为1.82%)。
从L1到L4逐步增加了微调参数的规模,由表4实验结果显示,当微调参数量从L1扩大到L2时,模型性能并未显著提升,Qwen模型的F1值甚至出现了微降。当参数量扩大到L3后,相比L2,Qwen和ChatGLM模型的F1值分别上升了0.025和0.021。当参数规模扩大到L4后,模型性能出现下降,说明不断地增加微调参数可能会导致过拟合。因此,本文最终采用L3作为微调设置。
为了更直观地展示本文所提方法在实际应用中的效果和用户体验,本文基于Gradio框架开发了一个“电力领域知识问答系统”。该系统集成了本文的P-RAG框架以及LoRA微调后的模型,能够有效地理解用户的问题,并生成逻辑清晰的回答,为用户提供流畅、直观的交互体验。图7中展示了本文电力领域知识问答系统的示例,图8和图9分别展示了使用DeepSeek与ChatGLM大模型的问答示例。当询问“在电气操作中发生什么情况时则构成事故?”这一问题时,本文模型给出的答案涵盖设备误操作和错误调度指挥层面的事故情形,展现了较高的专业度与准确性。相比之下,虽然DeepSeek与ChatGLM模型生成的答案更加流畅,但是明显存在信息遗漏,它们只列举了常见的误操作情形并解释了其危险后果,遗漏了“下达错误调度命令”“错误安排运行方式”等事故情形。

图7 电力领域知识问答系统示例
Fig.7 Question-answering example by the proposed method

图8 DeepSeek模型问答示例
Fig.8 Question-answering example by DeepSeek model

图9 ChatGLM模型问答示例
Fig.9 Question-answering example by ChatGLM model
本文针对难以从电力领域海量信息中高效获取所需知识,以及大语言模型在电力领域由于知识不足易导致“幻觉”问题,提出了一种基于大语言模型的电力领域知识问答方法,通过知识库增强与参数高效微调的双重机制,提升大语言模型在电力领域问答的准确性。首先构建了一个P-RAG框架,使用本文所提自适应文本信息提取方法与层级结构切分策略构建高质量电力知识库,并结合提示词设计引导模型生成准确的回复。在此基础上,利用大语言模型扩充微调样本集,构建与检索增强生成机制实际输入结构一致的训练样本,并使用LoRA微调进一步加强模型对电力专业知识的理解能力。实验结果表明,所有参评模型结合P-RAG框架后,其电力领域知识问答性能均提升了0.152~0.238,再使用本文所提微调方法对模型进行微调后,性能进一步提升0.024~0.124。本文所提方法为大语言模型在电力系统更复杂任务中的应用奠定了基础,未来有望辅助电网智能仿真和复杂故障诊断等场景,推动电力系统的智能化发展。未来的研究将进一步探索如何优化检索策略以提高捕获相关信息的精度,以及如何构建思维链处理更复杂的电力领域知识问答。
参考文献
[1] 国家发展改革委, 市场监管总局, 生态环境部. 关于进一步强化碳达峰碳中和标准计量体系建设行动方案(2024—2025年)的通知[EB/OL]. (2024-07-14)[2025-09-01].https://www.gov.cn/zhengce/zhengceku/ 202408/content_6967197.htm.
[2] 高洪超, 康重庆, 李嘉宇, 等. 新型电力系统下虚拟电厂的技术演进研判与运营挑战分析[J]. 电工技术学报, 2025, 40(19): 6057-6071. Gao Hongchao, Kang Chongqing, Li Jiayu, et al. Analysis of technological evolution and operational challenges for virtual power plants in new power systems[J]. Transactions of China Electrotechnical Society, 2025, 40(19): 6057-6071.
[3] 张思慧, 宋文胜, 唐涛, 等. 一种基于数字孪生的灰盒单相PWM整流器建模与健康参数监测方法[J]. 电工技术学报, 2025, 40(2): 463-476. Zhang Sihui, Song Wensheng, Tang Tao, et al. A gray-box single-phase PWM rectifier modeling and health parameter monitoring method based on digital twins[J]. Transactions of China Electrotechnical Society, 2025, 40(2): 463-476.
[4] 金亮, 苏浩展, 郭劭男, 等. 基于AI的电磁场计算建模研究综述[J]. 电工技术学报, 2025, 40(10): 3013-3029. Jin Liang, Su Haozhan, Guo Shaonan, et al. A review of AI-based computational modelling studies of electromagnetic fields[J]. Transactions of China Electrotechnical Society, 2025, 40(10): 3013-3029.
[5] 田萱, 吴志超. 基于信息检索的知识库问答综述[J]. 计算机研究与发展, 2025, 62(2): 314-335. Tian Xuan, Wu Zhichao. Review of knowledge base question answering based on information retrieval[J]. Journal of Computer Research and Development, 2025, 62(2): 314-335.
[6] 刘雨蒙, 赵怡婧, 王碧聪, 等. 结构化数据库查询语言智能合成技术研究进展[J]. 计算机科学, 2024, 51(7): 40-48. Liu Yumeng, Zhao Yijing, Wang Bicong, et al. Advances in SQL intelligent synthesis technology[J]. Computer Science, 2024, 51(7): 40-48.
[7] Chang Sijie, Wan Meng, Wang Jiaxiang, et al. Engineering material failure analysis report generation based on QWen and Llama2[J]. Results in Engineering, 2025, 26: 104532.
[8] Xiong Luolin, Wang Haofen, Chen Xi, et al. DeepSeek: paradigm shifts and technical evolution in large AI models[J]. IEEE/CAA Journal of Automatica Sinica, 2025, 12(5): 841-858.
[9] Ren Xinyuan, Song Yilin, Yan Chenwei, et al. CMed- baichuan: task explanation-enhanced prompt method onPromptCBLUE benchmark[C]//Health Information Processing: Evaluation Track Papers, 9th China Conference, CHIP 2023, Hangzhou, China, 2024: 31- 48.
[10] Zeng Zijian, Ratnavelu K. Deep learning-driven enhancement of chatbot interaction: a comprehensive study on ChatGLM[J]. WSEAS Transactions on Computer Research, 2024, 12: 377-383.
[11] Acharya K, Velasquez A, Song H H. A survey on symbolic knowledge distillation of large language models[J]. IEEE Transactions on Artificial Intelligence, 2024, 5(12): 5928-5948.
[12] Bai Ye, Yi Jiangyan, Tao Jianhua, et al. Fast end-to- end speech recognition via non-autoregressive models and cross-modal knowledge transferring from BERT [J]. IEEE/ACM Transactions on Audio, Speech, and Language Processing, 2021, 29: 1897-1911.
[13] 文森, 钱力, 胡懋地, 等. 基于大语言模型的问答技术研究进展综述[J]. 数据分析与知识发现, 2024, 8(6): 16-29. Wen Sen, Qian Li, Hu Maodi, et al. Review of research progress on question-answering techniques based on large language models[J]. Data Analysis and Knowledge Discovery, 2024, 8(6): 16-29.
[14] 黄君豪, 朱锦文, 向宗元, 等. 大语言模型引导的文本摘要技术与系统[J]. 计算机应用, 2024, 44(增刊1): 29-33. Huang Junhao, Zhu Jinwen, Xiang Zongyuan, et al. Large language model guided text summarization technology and system[J]. Journal of Computer Applications, 2024, 44(S1): 29-33.
[15] 孙光耀, 赵志枭, 沈思, 等. 基于大语言模型的人文社会科学汉英机器翻译研究[J]. 数据分析与知识发现, 2025, 9(4): 32-45. Sun Guangyao, Zhao Zhixiao, Shen Si, et al. Optimizing Chinese-English machine translation for humanities and social sciences via large language models[J]. Data Analysis and Knowledge Discovery, 2025, 9(4): 32-45.
[16] 蒲天骄, 赵琦, 王新迎. 电力人工智能技术研究框架、应用现状及展望[J]. 电网技术, 2025, 49(5): 1751-1770. Pu Tianjiao, Zhao Qi, Wang Xinying. Technology framework, application status and prospects on electric power artificial intelligence[J]. Power System Technology, 2025, 49(5): 1751-1770.
[17] 籍欣萌, 昝红英, 崔婷婷, 等. 大模型在垂直领域应用的现状与挑战[J]. 计算机工程与应用, 2025, 61(12): 1-11. Ji Xinmeng, Zan Hongying, Cui Tingting, et al. Status and challenges of large language models applications in vertical domains[J]. Computer Engineering and Applications, 2025, 61(12): 1-11.
[18] 牛泽原, 李嘉媚, 艾芊. 大语言模型在电力系统中的应用初探[J]. 电网技术, 2025, 49(4): 1327-1336. Niu Zeyuan, Li Jiamei, Ai Qian. Preliminary exploration of the application of large language models in power systems[J]. Power System Tech-nology, 2025, 49(4): 1327-1336.
[19] 刘雪颖, 云静, 李博, 等. 基于大型语言模型的检索增强生成综述[J]. 计算机工程与应用, 2025, 61(13): 1-25. Liu Xueying, Yun Jing, Li Bo, et al. Survey of retrieval-augmented generation based on large language models[J]. Computer Engineering and Applications, 2025, 61(13): 1-25.
[20] Wan Yuwei, Chen Zheyuan, Liu Ying, et al. Empowering LLMs by hybrid retrieval-augmented generation for domain-centric Q&A in smart manufacturing[J]. Advanced Engineering Informatics, 2025, 65: 103212.
[21] Boateng G O, Sami H, Alagha A, et al. A survey on large language models for communication, network, and service management: application insights, challenges, and future directions[J]. IEEE Communi- cations Surveys & Tutorials, 2026, 28: 527-566.
[22] Qian Hongjin, Liu Zheng, Mao Kelong, et al. Grounding language model with chunking-free in-context retrieval[C]//Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), Bangkok, Thailand, 2024: 1298-1311.
[23] Petrov A V, MacAvaney S, MacDonald C. Shallow cross-encoders forLow-latency retrieval[C]//Advances in Information Retrieval. Cham: Springer, 2024: 151-166.
[24] Islam S, Elmekki H, Elsebai A, et al. A comprehensive survey on applications of transformers for deep learning tasks[J]. Expert Systems with Applications, 2024, 241: 122666.
[25] Zhu Yutao, Yuan Huaying, Wang Shuting, et al. Large language models for information retrieval: a survey [J]. ACM Transactions on Information Systems, 2025, 44(1): 1-54.
[26] 张钦彤, 王昱超, 王鹤羲, 等. 大语言模型微调技术的研究综述[J]. 计算机工程与应用, 2024, 60(17): 17-33. Zhang Qintong, Wang Yuchao, Wang Hexi, et al. Comprehensive review of large language model fine- tuning[J]. Computer Engineering and Applications, 2024, 60(17): 17-33.
[27] 秦董洪, 李政韬, 白凤波, 等. 大语言模型参数高效微调技术综述[J]. 计算机工程与应用, 2025, 61(16): 38-63. Qin Donghong, Li Zhengtao, Bai Fengbo, et al. Review of parameter-efficient fine-tuning technology for large language models[J]. Computer Engineering and Applications, 2025, 61(16): 38-63.
[28] Chen Huiqiang, Zhu Tianqing, Liu Bo, et al. Fine- tuning a biased model for improving fairness[J]. IEEE Transactions on Big Data, 2025, 11(3): 1397-1410.
[29] Inoue N, Otake S, Hirose T, et al. ELP-adapters: parameter efficient adapter tuning for various speech processing tasks[J]. 2024, 32: 3867-3880.
[30] Mou Shangyang, Xue Qiang, Chen Xunquan, et al. Prefix tuning with prompt augmentation for efficient financial news summarization[J]. Journal of Compu-tational Social Science, 2024, 8(1): 19.
[31] Balasubramanian P, Liyana S, Sankaran H, et al. Generative AI for cyber threat intelligence: applications, challenges, and analysis of real-world case studies[J]. Artificial Intelligence Review, 2025, 58(11): 336.
[32] Liu Xiaoyang, Zhu Rongyi, Zha Daochen, et al. Differentially private low-rank adaptation of large language model using federated learning[J]. 2025, 16(2): 1-24.
[33] 丁俐夫, 陈颖, 肖谭南, 等. 基于大语言模型的新型电力系统生成式智能应用模式初探[J]. 电力系统自动化, 2024, 48(19): 1-13. Ding Lifu, Chen Ying, Xiao Tannan, et al. Exploration of generative intelligent application mode for new power systems based on large language models[J]. Automation of Electric Power Systems, 2024, 48(19): 1-13.
[34] Xia Shujun, Hua Qing, Mei Zihan, et al. Clinical application potential of large language model: a study based on thyroid nodules[J]. Endocrine, 2025, 87(1): 206-213.
[35] Zhang Tianyi, Kishore V, Wu F. BERTScore: evaluating text generation with BERT[C]//8th International Conference on Learning Representations, Addis Ababa, Ethiopia, 2020: 5333-5376.
Abstract Efficient and accurate acquisition of required knowledge from massive power field information sources poses a significant challenge to knowledge management in the power industry. Large language models (LLMs) have achieved breakthroughs in natural language understanding and generation, offering new avenues for knowledge question-answering. However, their application in the power field remains limited, as they struggle to comprehend specialized concepts and are prone to generating hallucinations. To address these issues, this paper proposes a knowledge question-answering method in the power field based on LLMs. This method improves the answer accuracy by integrating domain-specific knowledge bases with parameter-efficient fine-tuning optimization.
Firstly, this paper constructs a power field knowledge question-answering framework based on retrieval-augmented generation (P-RAG). This framework employs an adaptive text information extraction method based on LLMs to efficiently parse power document layouts and extract text. It then recursively segments the text based on hierarchical document titles to ensure semantic integrity, building a high-quality power field knowledge base. On this basis, prompt engineering guides the LLM to fully comprehend and utilize this power knowledge, thereby improving question-answering accuracy. Secondly, this paper proposes a model optimization method based on sample augmentation and LoRA fine-tuning. This method utilizes LLMs to rewrite and expand original question-answering pairs, diversifying textual expressions without altering the semantics, thereby effectively resolving the scarcity of fine-tuning samples. Meanwhile, the question and retrieved relevant knowledge are combined as the training input vector to construct a sample structure consistent with the actual input of the P-RAG framework. Through LoRA fine-tuning, the understanding of power field knowledge by LLMs and their ability to utilize external retrieved information are enhanced.
Comparative tests on a series of LLMs, including BaiChuan2-7B, BlueLM-7B, Qwen-7B, ChatGLM3-6B, and DeepSeek-R1-7B, show that after integration with the P-RAG framework, the performance of all participating models in power field knowledge question-answering tasks improved by 0.152 to 0.238. This verifies the universality and effectiveness of the P-RAG framework. Furthermore, based on Qwen-1.8B, Qwen-7B, and ChatGLM3-6B models, different fine-tuning optimization methods are compared. The results show that after standard LoRA fine-tuning optimization method, model performance decreased by approximately 0.035 to 0.104. In contrast, applying the proposed optimization method can improve the model performance by 0.024 to 0.124, validating the effectiveness of the proposed sample-augmentation fine-tuning optimization method.
The following conclusions can be drawn from the experimental analysis: (1) The proposed P-RAG framework provides external professional power knowledge for general LLMs, alleviating the hallucination problem of LLMs in the power field. (2) Compared with standard LoRA fine-tuning, the proposed model optimization method is more suitable for the P-RAG framework. Since the training sample input is consistent with the actual input of the P-RAG framework, it enhances the ability of LLMs to utilize external information and improves question-answering accuracy.
keywords:Large language models, power knowledge question-answering, retrieval-augmented generation, sample augmentation, parameter-efficient fine-tuning
DOI: 10.19595/j.cnki.1000-6753.tces.251675
中图分类号:TM73;TP39
国家电网有限公司科技项目资助(52090025001G-129-ZN)。
收稿日期 2025-09-28
改稿日期 2025-11-29
杨 燕 女,1995年生,讲师,硕士生导师,研究方向为人工智能、电力系统分析。E-mail:yanyang@cqupt.edu.cn(通信作者)
刘 豪 男,2000年生,硕士研究生,研究方向为大模型技术在电力系统中的应用。E-mail:s240201067@stu.cqupt.edu.cn