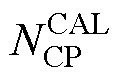 的校验集,
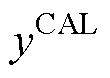 为校验集样本的真实值,
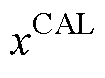 为校验集样本的输入特征,
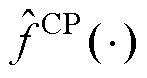 为预测映射函数,定义样本残差
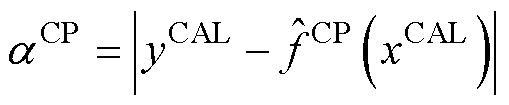 。在显著性水平
 下,从校准集残差中选取(
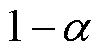 )(
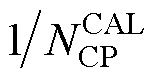 +1)分位数作为阈值
 ,对于测试集样本的输入特征
 ,其真实值的预测区间可表示为
摘要 针对共形分位数回归(CQR)在光伏功率短期区间预测中易出现区间偏移或跨度过大的问题,该文提出结合科尔莫戈洛夫-阿诺德网络(KAN)与多头注意力机制(MHA)的KAN-HMA模型和非对称共形分位数回归(ACQR)方法。分位数回归通过预测上下分位数以实现区间预测,但在模型拟合不足时,分位数预测结果往往偏离真实分布,导致区间整体偏移或跨度过大。为此,利用KAN的强大拟合能力并引入MHA增强时序特征提取,提升建模精度;同时针对传统CQR采用对称修正量易造成区间过宽的问题,采用ACQR对预测区间的上下界进行不对称修正,以获得更紧致的预测区间。实验结果表明,相较于卷积-双向长短时记忆神经网络、KAN等模型,KAN-HMA模型的分位数回归预测结果更加贴近样本分布,进一步结合所提ACQR方法,能够在满足置信度要求的情况下,获取比CQR方法更窄的预测区间。
关键词:光伏功率短期区间预测 Kolmogorov-Arnold网络 多头注意力机制 非对称共形分位数回归
随着全球能源结构的转型,太阳能作为一种清洁、可再生的能源,受到广泛关注。在应对气候变化、减少碳排放的背景下,光伏发电已经成为实现绿色低碳发展的重要途径[1]。光伏功率受多种因素的影响而具备随机性、波动性。准确预测光伏功率的变化,是提升电力系统可靠性、优化调度策略的关键[2]。
传统光伏功率预测方式以点预测为主,能够满足某些特定场景下的使用需求,但其固有的局限性在于未能有效考虑系统中的不确定性与波动性,难以全面描述光伏发电过程中复杂的动态特性;相比之下,区间预测通过预测功率的出力区间,能够有效地捕捉和量化光伏功率预测中的不确定性,提供更为全面的风险评估。现有的区间预测方法众多,其中,分位数回归[3-4](Quantile Regression, QR)方法因其良好的理论基础与实际应用效果而被广泛使用:文献[5]将分位数回归与多层感知机(Multilayer Perceptron, MLP)结合,建立短期光伏功率区间预测模型;文献[6]采用长短时记忆神经网络(Long Short-Term Memory, LSTM)代替MLP,构建时序分位数回归模型,通过把握功率序列中的时序信息来进一步提高预测精度。分位数回归预测的结果依赖于预测模型对光伏功率的准确建模,而事实上,现有模型往往难以在全局上拟合各类气候条件下的样本,当模型的拟合能力不足时,分位数预测曲线容易偏离实际分位数曲线,使得预测区间发生整体偏移。为缓解此问题,现有文献分别从修正分位数曲线和提高模型拟合精度两个方面展开研究。
在分位数曲线修正方面,文献[7]引入共形预测以量化分位数回归的预测偏差,并采用对称修正量进行区间校正。当上下界预测偏差大体一致时,该方法能够有效缓解偏差问题,从而获得较为可靠的预测区间;然而,当上下界存在非对称偏差时,对称修正量无法消除区间偏移,仅能通过整体扩张区间来保证覆盖率,进而导致预测区间跨度过大,降低了区间预测的紧致性与实用性。
在提高模型拟合精度方面,现有研究从天气特征入手,采用针对性的学习方式来降低建模难度:文献[8]使用K-均值算法将训练样本划分为晴天、阴天、雨天三种天气类别,分别进行训练与测试;文献[9]针对K-均值硬聚类的不足,改用模糊C均值聚类算法实现训练样本的软聚类划分,提高了模型对复杂天气状况的适应性。从本质上来说,上述方法都属于局部拟合思想,通过拟合小范围空间来提高模型的拟合精度,这无疑减少了单个模型的训练样本数。区间预测的核心是对不确定性的建模,充足的训练样本是建模准确性的重要保证,因此,上述方法存在一定的局限性。2024年4月,文献[10]提出科尔莫戈洛夫-阿诺德网络(Kolmogorov- Arnold Networks KAN),与现有模型的不同之处在于,KAN采用可学习的激活函数来提高模型的非线性拟合能力,能够更加灵活地应对各种复杂的映射关系。基于KAN,文献[11]提出了净负荷概率预测方法,利用可学习的激活函数提升模型结构的可解释性,并构建均值与方差双网络精确拟合净负荷的概率分布,实现高精度且具可解释性的建模;文献[12]提出了一种融合重构的二次分解-集成框架与KAN的电价预测方法,在该文献中,KAN处于整个预测模型的顶层,用于将模型底层提取到的时序信息映射到最终输出,增强了模型的精度和表达能力。上述文献对KAN的应用,已经初步体现了KAN相对于传统模型的建模优势,但从KAN的结构特征上来说,其并不擅长时序特征的提取,文献[11]仅使用KAN进行建模,没有较好地把握数据中的时序信息;文献[12]在使用底层模型提取时序信息时,同样没有结合到KAN。光伏功率序列作为时序数据,受周期性、趋势性等多种因素影响,蕴含时序规律。虽然KAN在静态数据拟合中表现优越,但在处理时序数据时难以充分考虑时间维度上的相关性,可能限制其在光伏功率回归预测中的表现。
综合上述讨论,基于共形分位数回归的光伏功率区间预测方法仍存在以下问题:①现有模型在复杂气候条件下的拟合能力不足,导致预测结果出现整体偏移或区间跨度过大;虽然基于聚类的局部建模方法在一定程度上提升了拟合效果,但牺牲了训练样本的规模,限制了模型对不确定性变化的建模精度。②KAN虽然具备较强的拟合能力,但其在时序数据特征提取上的表现不足,难以准确建模光伏功率的变化规律。③现有共形分位数回归方法在处理不对称预测偏差时,无法有效消除区间的不对称偏移,导致区间跨度过大。为解决上述问题,本文提出将KAN与多头注意力机制(Multi-Head Attention, MHA)结合,构建时序回归模型,并采用非对称共形分位数回归方法修正光伏功率预测区间的不对称偏移。实验结果表明,所提方法在保证高覆盖率的同时,显著缩小了预测区间的跨度,有效建模了光伏出力的不确定性,可为光伏能源的高效利用与优化配置提供可靠的预测依据。
共形预测(Conformal Prediction, CP)[13]是一种不确定性量化方法,其核心思想是基于模型残差分布构建预测区间。在回归任务中,已知样本数为的校验集,为校验集样本的真实值,为校验集样本的输入特征,为预测映射函数,定义样本残差。在显著性水平下,从校准集残差中选取()(+1)分位数作为阈值,对于测试集样本的输入特征,其真实值的预测区间可表示为
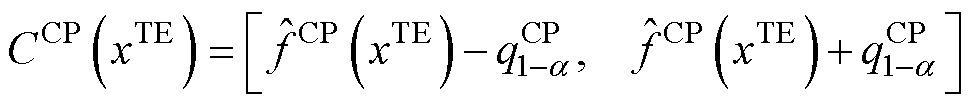 (1)
式中,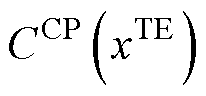 为测试集样本真实值的共形预测区间,理论上保证其真实值落入该区间的概率不低于。
分位数回归(Quantile Regression, QR)[14]是一种用于刻画条件分布特征的统计方法,可估计不同分位点的条件分布位置。在回归任务中,设 分位数曲线的预测模型为
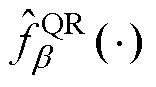 ,对于训练样本
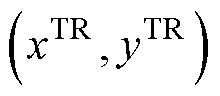 ,定义
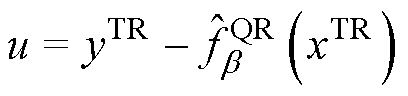 ,其损失函数
 为
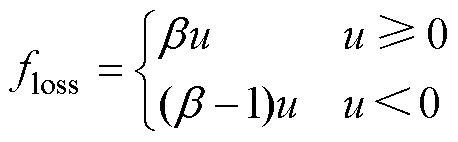 (2)
式中,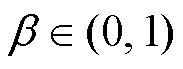 表示目标分位点。
共形分位数回归(Conformal Quantile Regression, CQR)[7]即使用共形预测修正分数回归预测结果,对于给定显著性水平,其分位数曲线预测步骤如下:
(1)将样本数据分为分位数回归训练集、校验集和测试集三部分,样本数量分别为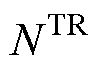 、
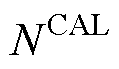 、
 。
(2)利用分位数回归算法和训练集数据训练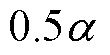 和
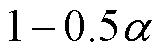 分位数曲线预测模型,完成训练后在校验集上预测分位数曲线。
(3)根据步骤(2)中的预测曲线,计算每个校验集样本的不一致分数,有
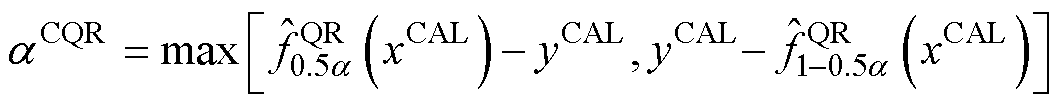 (3)
式中,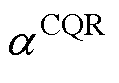 为校验集样本不一致分数;
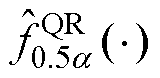 为步骤(2)中的分位数曲线预测模型;
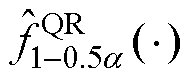 为步骤(2)中的分位数曲线预测模型。(4)从校准集不一致分数中选取()·(
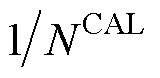 +1)分位数作为修正量
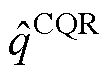 ,则对于测试集样本的输入特征,其真实值的预测区间可表示为
 (4)
式中,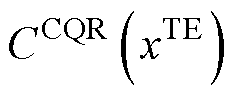 为测试集样本真实值的共形分位数回归预测区间,理论上保证真实值落入此区间中的概率不低于。
由式(4)可知,共形预测通过对称平移上下界的方式对分位数回归的预测结果进行修正。当分位数回归的预测区间出现非对称偏移时,会导致如图1所示的情况。
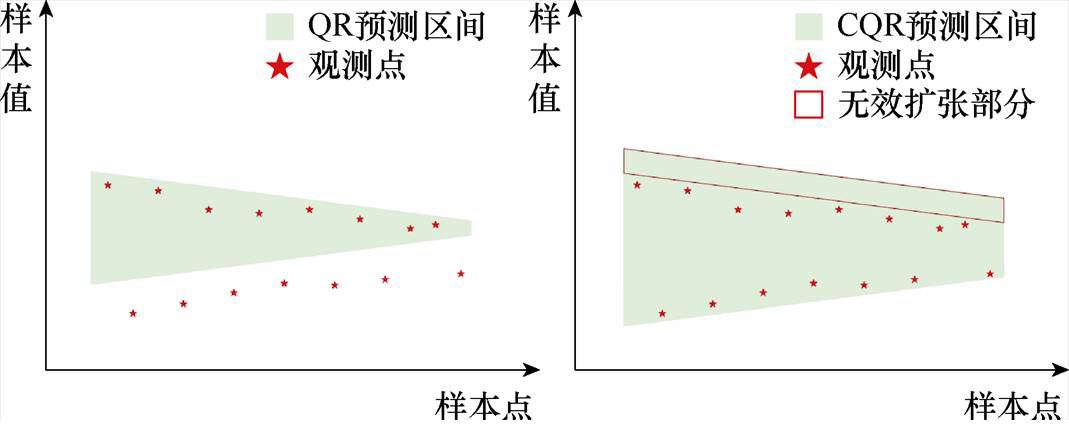
(a)共形预测修正前 (b)共形预测修正后
图1 共形预测修正非对称偏差示意图
Fig.1 Schematic diagram of conformal prediction correcting asymmetric bias
在图1a展示了分位数回归的预测结果。可以观察到,上分位数曲线拟合效果较好,而下分位数曲线则存在显著偏差。引入共形预测修正后,下分位数曲线的拟合效果得以改善,但由于采用对称修正方式,上分位数曲线出现无效扩张部分,不对称偏移仍然存在。由此可见,在此类情形下,仅对下分位数曲线进行修正,能够获得更优的区间拟合效果。
基于该分析,本文提出了非对称共形分位数回归(Asymmetric Conformal Quantile Regression, ACQR)方法,以提升区间预测的合理性与精度。对于给定显著性水平,其分位数曲线预测步骤如下:
(1)将样本数据分为分位数回归训练集、共形预测校验集和测试集三部分,样本数量分别为、、。
(2)利用分位数回归算法和训练集数据训练和分位数回归模型,完成训练后在校验集上预测分位数曲线。
(3)根据步骤(2)中的预测曲线,计算每个校验集样本的上下界不一致分数,有
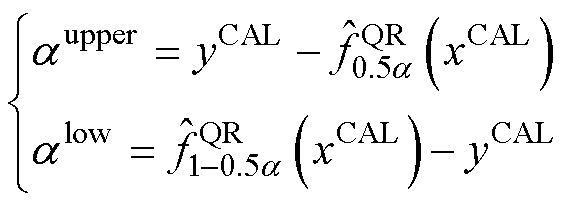 (5)
式中,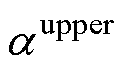 、
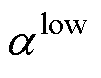 分别为校验集样本的上、下界不一致分数。
(4)从校验集上界不一致分数中选取()·(+1)分位数作为上界修正量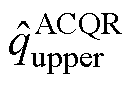 ,从校验集下界不一致分数中选取
 (1-)分位数作为下界修正量
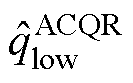 ,则对于测试集样本的输入特征,其真实值的预测区间可表示为
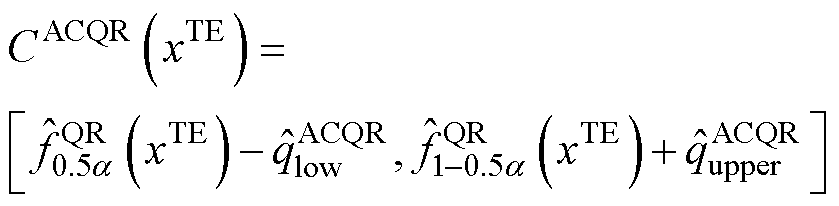 (6)
式中,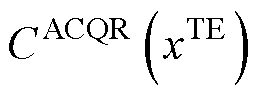 为测试集样本真实值的非对称共形分位数回归预测区间,理论上保证真实值落入该区间中的概率不低于。
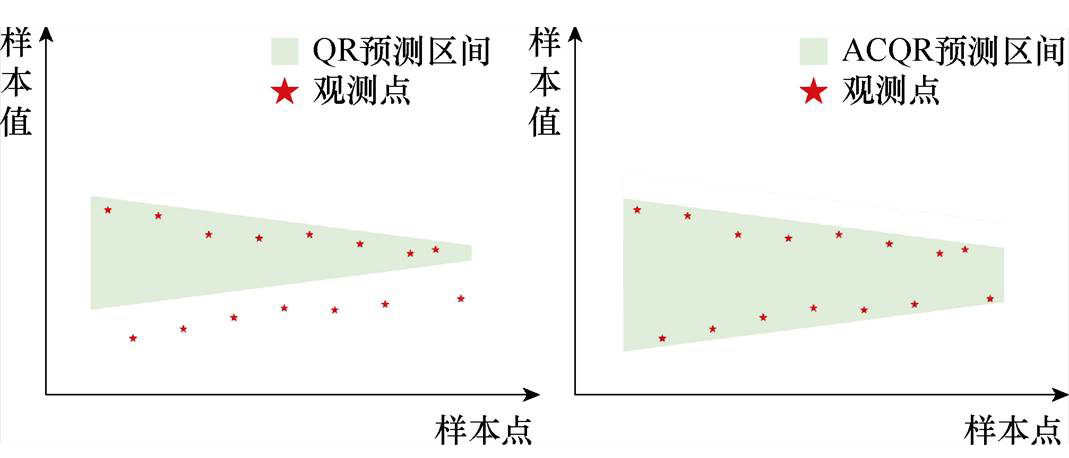
当使用非对称共形预测对图1a所示的非对称偏移预测区间进行修正时,可得到对称的修正结果,同时避免不必要的扩张,非对称共形预测修正非对称偏差示意图如图2所示。
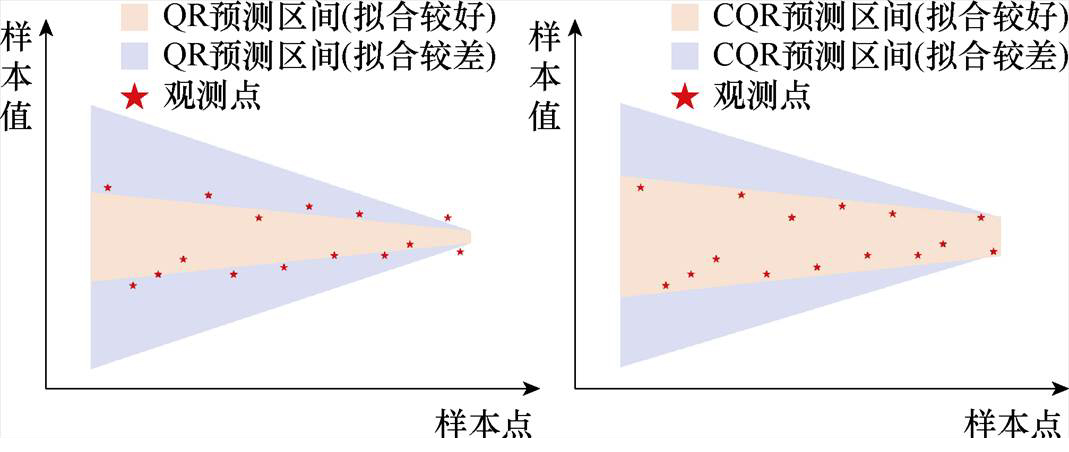
由式1.3节可知,无论是CQR还是ACQR,都是通过平移上下界的方式对分位数回归的预测结果进行修正。从理论上来说,修正后的结果可提供覆盖率保证,但当分位数回归模型的拟合效果较差时,会导致最终的预测区间跨度过大,以CQR为例,不同拟合效果的预测结果对比示意图如图3所示。
(a)非对称共形预测修正前 (b)非对称共形预测修正后
图2 非对称共形预测修正非对称偏差示意图
Fig.2 Schematic diagram of asymmetric conformal prediction correcting asymmetric bias
(a)共形预测修正前 (b)共形预测修正后
图3 不同拟合效果的预测结果对比示意图
Fig.3 Comparison diagram of prediction results with different fitting effects
图3a是两种不同的分位数回归预测结果,可以观察到,橙色QR结果在修正前已将观察点的大致分布拟合,而蓝色QR结果在修正前对观测点的分布拟合较差,没有较好地把握观测点的分布趋势;在对蓝、橙QR结果进行共形预测修正后,蓝、橙的CQR预测结果都将观测点包括在内,但蓝色CQR预测结果的区间宽度显然大于橙色CQR预测结果的区间宽度,这是由QR的拟合效果不同所引起的,由此可见,QR模型的拟合效果对最终的预测区间宽度至关重要。
科尔莫戈洛夫-阿诺德网络[10]以Kolmogorov- Arnold表示定理(Kolmogorov-Arnold Representation Theorem, KART)为基础,其理论为:有界域上的多元连续函数可以表示为有限单变量连续函数的两层嵌套叠加,有
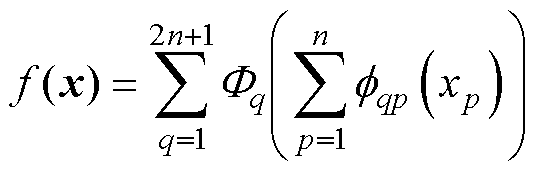 (7)
式中,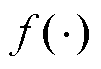 为多元连续函数;
 =
 …
 …
 为因变量;
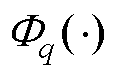 为第q个外层单变量连续函数;
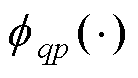 为外层q的第p个内层单变量连续函数。
以上述理论为基础,文献[10]将、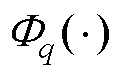 作为可学习的激活函数
 ,提出了KAN。
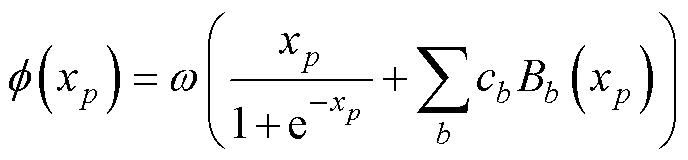 (8)
式中, 为控制函数整体大小的可学习参数;
 为第b个B样条曲线
 的可学习权重参数。
为了更一般化网络,文献[10]以式(9)定义KAN层。
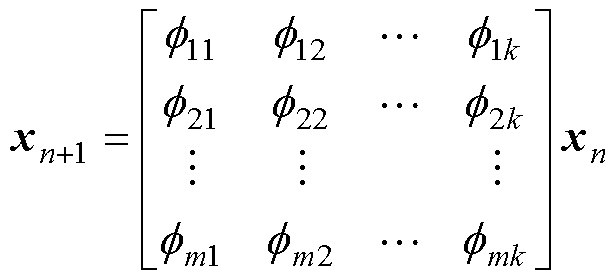 (9)
式中, 为输出向量;
 ,
 ,…,
 为可学习的激活函数,表达式即式(8);k为KAN层的输入维度;m为KAN层的输出维度;
 为输入向量;后文用
 代表KAN层的函数计算式,即
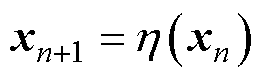 。
当多个KAN层堆叠时,前一个KAN层的输出维度即为后一个KAN层的输入维度。例如,某2层KAN的结构示意图如图4所示,其维度可表示为(2, 5, 1)。
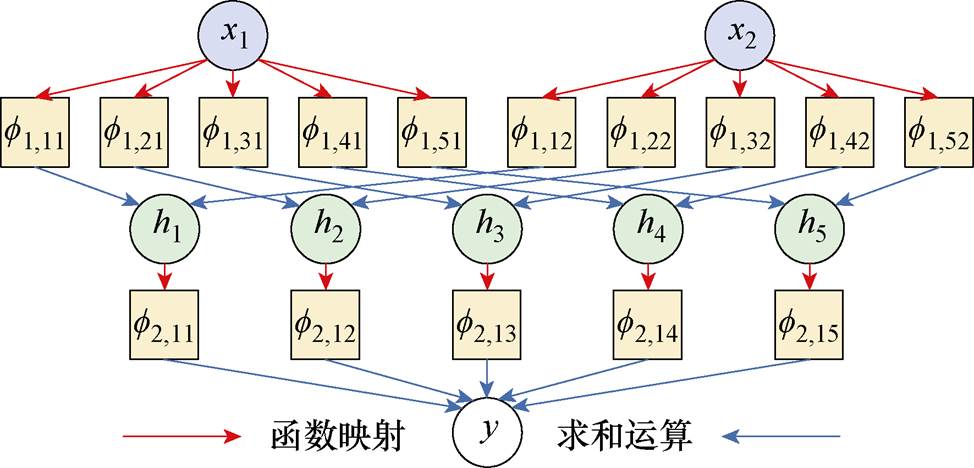
图4 KAN结构示意图
Fig.4 Schematic diagram of KAN structure
图4中, 、
 为输入变量;黄色方框为激活函数,对应式(9)中的激活函数矩阵;
 ,…,
 为隐藏层特征;y为输出结果。KAN的全局非线性拟合能力来源于可学习的激活函数,相较于固定的激活函数,可学习的激活函数能够灵活适应各种复杂的非线性映射关系,在全局上表现出优异的拟合性能。基于KAN构建QR预测模型,可有效提高QR的拟合精度,改善预测区间的宽度。
光伏功率输出主要受到天气特征的影响,可通过建模天气特征与实际功率之间映射关系来达到短期功率预测的目的,有
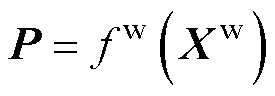 (10)
式中, 为实际功率向量;
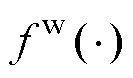 为天气特征与实际功率之间的映射函数;
 为天气特征变量矩阵,包含时间和特征数两个维度。
通过大量历史样本训练神经网络模型,可对式(10)中的进行拟合。为了提高建模的准确性,本文对时、空两种映射关系分别进行建模,整个模型以KAN为基本单元,结合MHA提取时序特征,结构示意图如图5所示,命名为KAN-MHA。

图5 KAN-MHA结构示意图
Fig.5 Schematic diagram of KAN-MHA structure
2.2.1 空间映射建模
空间映射关系是指当前时刻的天气变量与当前时刻输出功率之间的映射关系,对光伏输出功率而言,辐照度是其主要影响因素,而风速、温度、湿度等其他天气变量同样会相互作用共同影响最终的功率输出。本文通过堆叠多个KAN层来对上述变量之间的内在联系进行挖掘,作为整个模型的空间特征提取模块,其结构示意图如图5中“空间特征提取模块”所示,计算式为
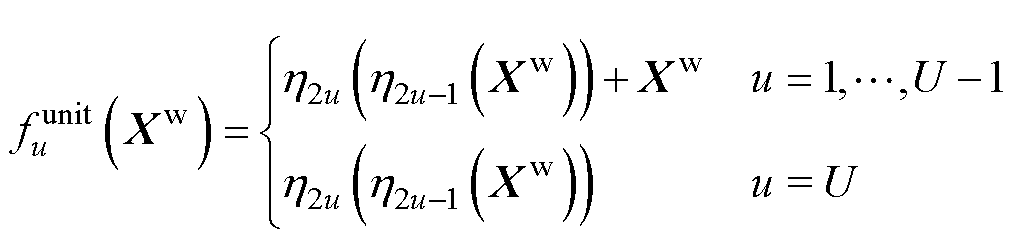 (11)
式中,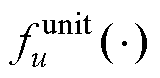 为第u个基本单元计算函数,共有U个基本计算单元;维度等于(T, M),其中T为预测的时刻总数,M为天气特征变量数;
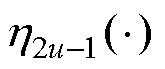 、
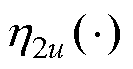 为第2u-1、2u个KAN层,维度分别为(M, 2M+1)、(2M+1, M),当中的u=U时,其维度为(2M+1, 1)。当u≠U时,额外加入是为了避免因层数过深而导致模型训练困难,这种跳跃链接的方式能够使得梯度在训练过程中进行有效传递;当u=U时,不加入是为了匹配最终的输出维度。
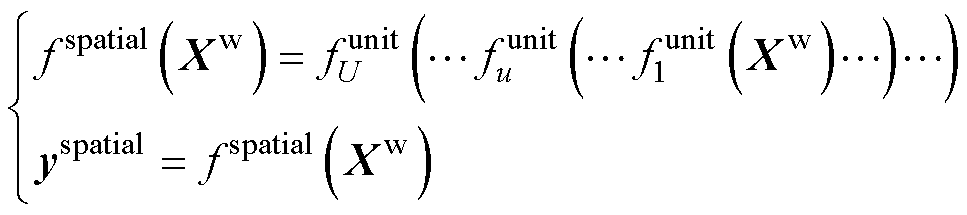 (12)
式中,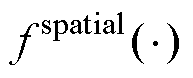 为整个空间特征提取模块的计算函数;
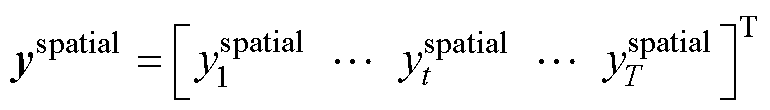 为空间特征提取模块的输出,代表各个天气变量相互作用后的特征提取结果,其中
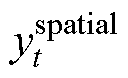 为第t个时刻的空间特征。
当输入变量为矩阵时,会对的每一行向量分别进行运算,行与行之间的计算相互独立。因此,仅与有关,即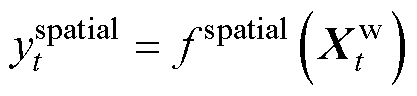 (
 是的第t行),当前时刻的空间特征提取结果只与当前时刻的天气变量有关,与其他时刻的天气变量无关。
2.2.2 时序映射建模
时序映射关系是指当前及相邻时刻的天气变量与当前时刻输出功率之间的映射关系。通常来说,天气因素对光伏功率输出的影响不仅仅是短期的,还会受到时间积累效应的影响,所以需要对各个变量在时序上存在的特征进行提取。显然,根据时序映射的原理可知,当前时刻的时序特征需要从所有时刻的天气变量中提取,而原始的KAN以特征向量输入、结果向量输出为映射形式,若将所有时刻的特征都放在单个向量中作为输入,则会大大增加输入变量维度,不仅影响计算速度,还不利于模型对关键特征进行捕捉。为解决此问题,本文将原始KAN与多头注意力机制进行结合,构建时序特征提取模块,如图5中“时序特征提取模块”,具体计算过程如下:
(1)通过三个维度相同的KAN对输入的天气特征进行初步映射,得到查询矩阵Q、键矩阵K、值矩阵V为
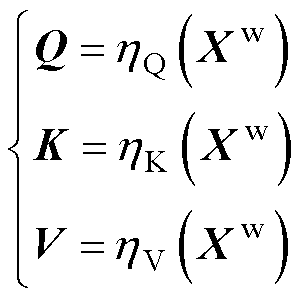 (13)
式中,Q、K、V的维度均为 (T, G),其中G为多头注意力机制头数;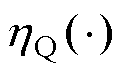 、
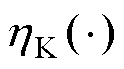 、
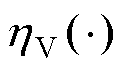 分别为Q、K、V对应的映射KAN,维度均为(M, 2M+1, G)。
(2)对Q、K、V按列分块为G个子矩阵,每一个分块对应一头注意力机制,并按式(14)对每头注意力机制分别进行计算,不同的头代表着不同的注意力子空间,旨在从不同角度对时序特征进行捕捉。
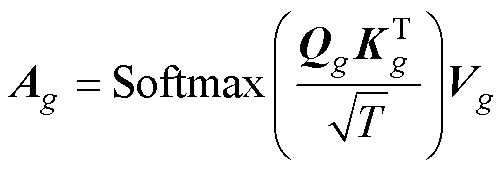 (14)
式中, 为第g头注意力机制计算结果;
 、
 、
 分别为Q、K、V的第g个列分块子矩阵。此处是时序特征提取的关键所在,、、的行数为时刻数T,每一行代表不同时刻。其中、用于权重计算,代表各时刻天气变量特征初步提取结果,具体来说,
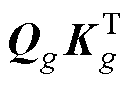 包含了不同时刻的时序特征与不同时刻输入变量之间的关联程度,例如,的第q行第p列由的第q行和的第p行内积计算而来,代表时刻第q的时序特征与第p个时刻输入变量的关联程度。
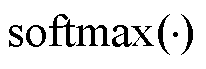 用于归一化,将当前时刻时序特征与各时刻天气变量之间的关联程度之和调整为1,因此,
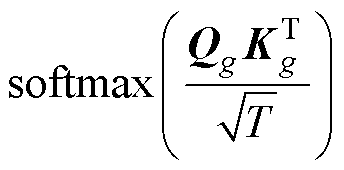 的每一行即为权重向量,与每一列进行加权求和计算得到各个时刻时序特征提取结果。(3)将多头注意力机制计算结果拼接成一个矩阵
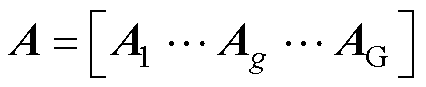 ,并通过一个全连接层输出时序特征提取结果。
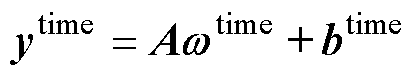 (15)
式中,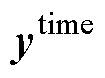 为时序特征提取模块的提取结果;
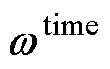 、
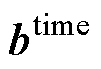 分别为时序特征提取全连接层的权重矩阵和偏置行向量,皆为可学习参数。整个时序特征提取模块的计算式概括为
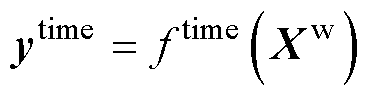 (16)
其中
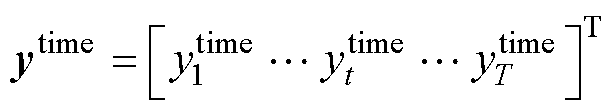
式中,为时序特征提取模块的输出;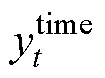 为时刻t的时序特征提取结果;
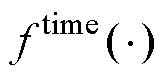 为时序特征提取模块的计算函数。此处需要注意的是,与所有时刻的输入变量都有关,而不仅仅取决于第t个时刻的输入变量,即
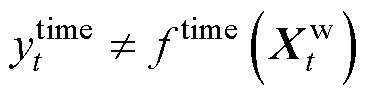 。
将天气特征输入至时、空特征提取模块后,得到抽象的时、空特征序列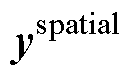 和,最后需要对时空特征与光伏功率之间建立映射,具体步骤如下:首先将时空结果拼接,得到拼接向量F,然后通过全连接层输出光伏出力预测结果,该过程为
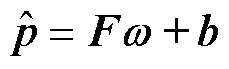 (17)
其中
 =
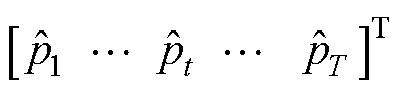
 =
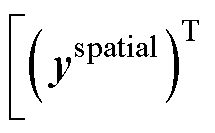
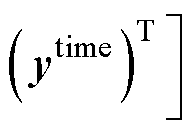
式中,为预测功率时间序列; 为时刻t的预测功率值;
 、
 分别为全连接层的权重矩阵和偏置行向量,皆为可学习参数。
本节通过两个算例来对各模型的预测精度进行对比分析,测试模型对不同情况的适应能力,突出所提时序回归模型在拟合性能方面的优越性,以及非对称共形预测修正方法的优势。
(1)算例数据1。本算例数据由DKA Solar Centre官网提供[15],包括澳大利亚中部沙漠某光伏电站2009—2011年间61 344条数据,每条数据提供了当前时刻的全球水平辐射、散射水平辐射、风向、温度、风速、相对湿度六个天气特征及系统发电量数值,相邻两条数据间的时间间隔为15 min。将61 344条数据以日为单位划分为639个样本,并按4 33的比例划分训练集、验证集与测试集。
(2)算例数据2。本算例数据由国能日新第二届光伏功率预测大赛提供[16],包括某光伏电站2017—2018年间56 448条数据,每条数据提供了当前时刻的辐照度、压强、风向、温度、风速、相对湿度六个天气特征及系统发电量数值,相邻两条数据间的时间间隔为15 min。将56 448条数据以日为单位划分为588个样本,并按433的比例划分训练集、验证集与测试集。
在进行实验之前,对所有算例数据进行式(18)所示的归一化处理。
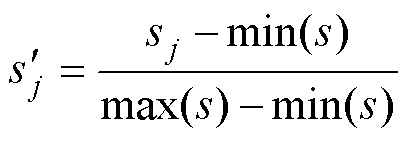 (18)
式中, 为
 归一化后数据值;为原始数据集s中的第j个数据。
通过Spearman相关系数和Pearson相关系数来筛选有效输入特征,两者计算式分别为式(19)、式(20),各天气变量与实际功率的相关性系数计算结果见表1、表2。
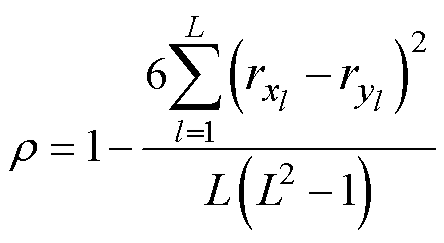 (19)
式中, 为变量
 、
 的Spearman相关系数;
 、
 为样本l在和中的秩次;L为样本总数。
表1 算例1天气变量与实际功率的相关性系数
Tab.1 Example 1 correlation coefficient between weather variables and actual power
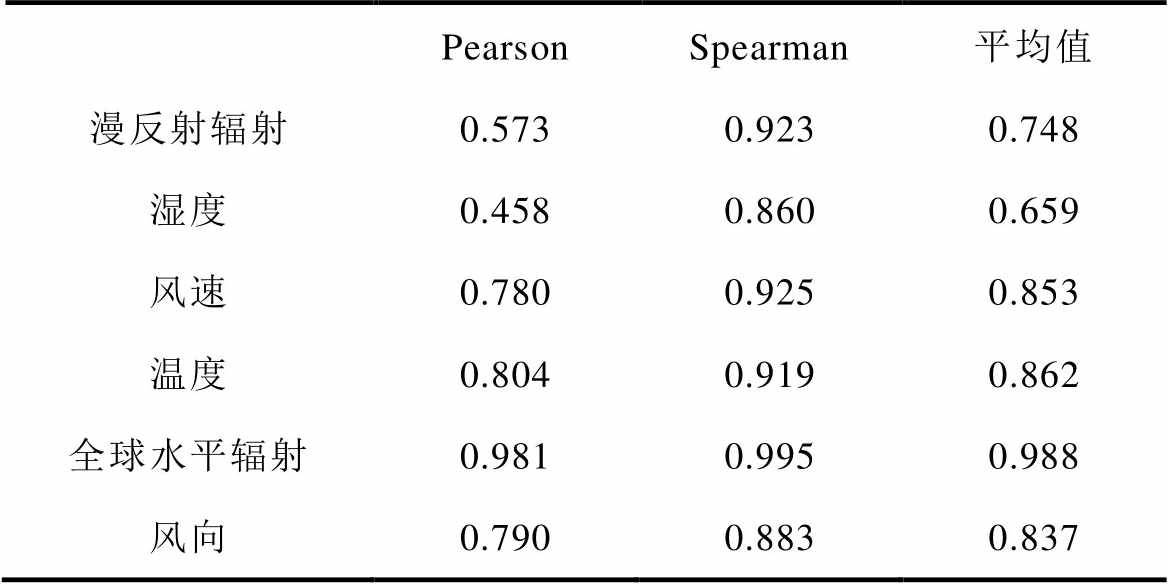
PearsonSpearman平均值 漫反射辐射0.5730.9230.748 湿度0.4580.8600.659 风速0.7800.9250.853 温度0.8040.9190.862 全球水平辐射0.9810.9950.988 风向0.7900.8830.837
表2 算例2天气变量与实际功率的相关性系数
Tab.2 Example 2 correlation coefficient between weather variables and actual power
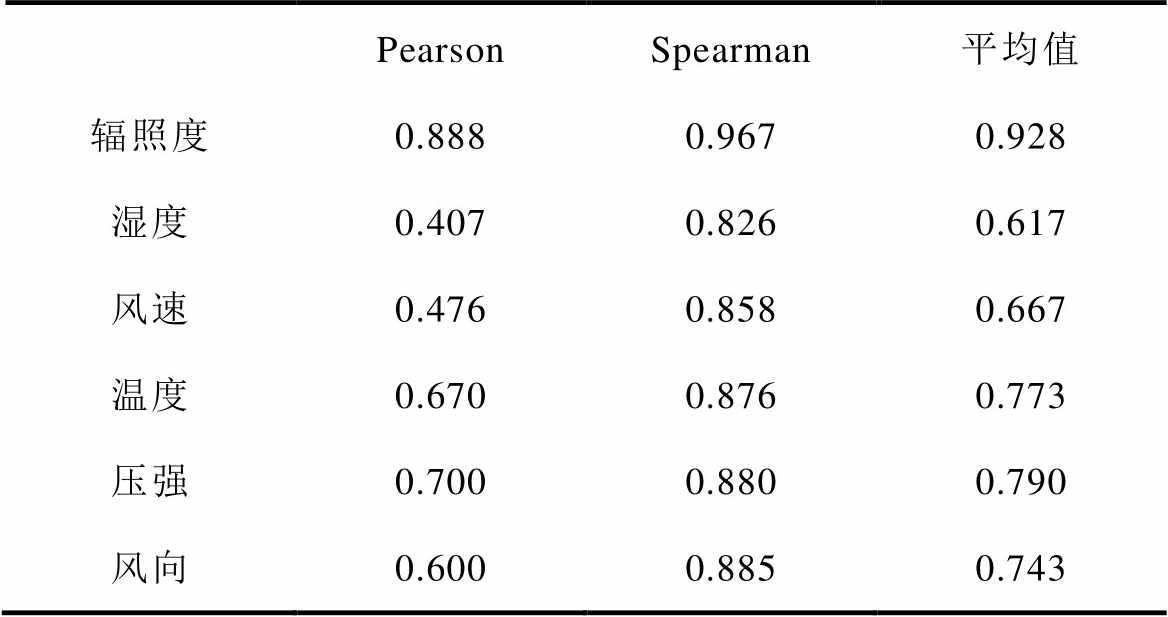
PearsonSpearman平均值 辐照度0.8880.9670.928 湿度0.4070.8260.617 风速0.4760.8580.667 温度0.6700.8760.773 压强0.7000.8800.790 风向0.6000.8850.743
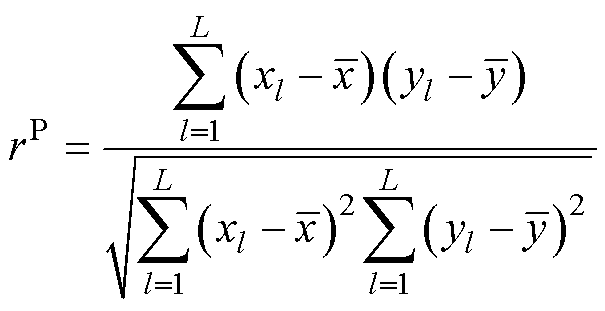 (20)
式中, 为变量和的Pearson相关系数;
 、
 分别为和的第l个样本;
 和
 分别为和的样本均值。
从表1、表2的Spearman相关系数可知,两个算例所有天气变量与实际功率之间的Spearman相关系数都在0.8以上,说明两个算例皆无冗余特征。通常来说,输入变量与目标输出之间的相关性越高,预测难度越低,从两个算例的相关性系数计算结果来看,算例2的相关性系数值整体高于算例1的相关性系数值,故算例1和算例2的预测难度具有一定的区分性,可验证模型在不同情况下的预测性能。
对于光伏功率区间预测的结果,采用预测区间归一化平均宽度(Prediction Interval Normalized Average Width, PINAW)、预测区间覆盖率(Prediction Intervals Coverage Probability, PICP)和标准化区间宽度(Normalized Interval Width, NIW)作为评价指标。PICP用于衡量预测区间包含真实值的比例,它体现了区间预测结果的可靠性;PINAW是一种衡量区间预测质量的指标,主要用于评估预测区间的宽度,二者表达式如式(21)、式(22)所示,NIW则定义为PINAW与PICP之比,二者比值越小,则该区间内的样本越密集。
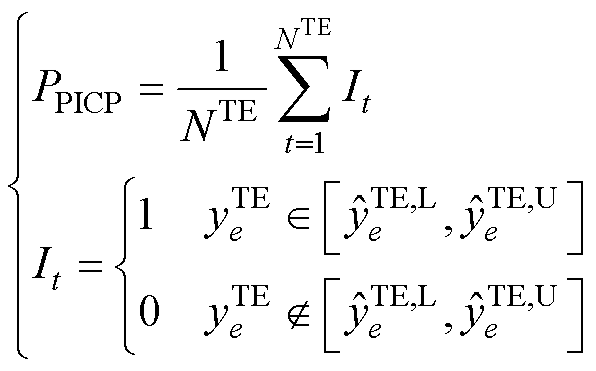 (21)
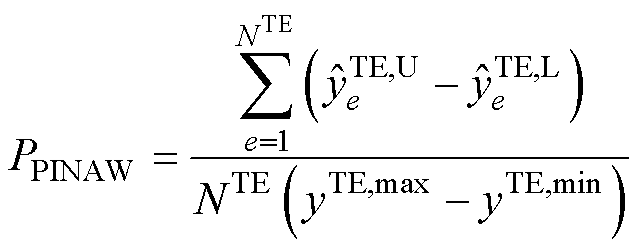 (22)
式中,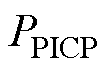 为PICP指标值;
 为测试集样本总数;
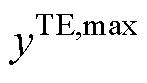 、
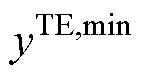 分别为测试集功率的最大、最小值;
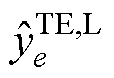 、
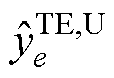 为测试集样本e的功率预测区间上、下界;
 为测试集样本e的真实功率值;
 为PINAW指标。
由于测试样本集庞大,若以图1~图3的方式展示预测区间与真实功率值的观测点,仅能对部分结果进行细致展示,为了展示所有真实功率值与其预测区间的相对误差,本文以预测区间上下界为参考线,对于每一个样本,计算其与上下界曲线的相对误差,有
 (23)
式中, 为测试集样本的真实功率值与其预测区间上界的相对误差(相对误差);
 为测试集样本的真实功率值与其预测区间下界的相对误差;
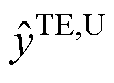 、
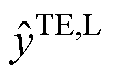 分别为预测区间的上、下界。显然,当<0时,表示该样本的真实功率值在其预测区间上界以下,同理,当<0时,表示该样本的真实功率值在其预测区间下界以上。
由于是以上界曲线为参考线,故在的频数分布直方图中,过原点垂直横轴的直线即为上界,从而实现了化“曲”为“直”的目的,同理,也有类似的规律,在此不多赘述。后文对所有样本的频数分布直方图命名为“上界相对误差频数分布直方图”;对所有样本的频数分布直方图命名为“下界相对误差频数分布直方图”。通过上下界相对误差频数分布直方图,可集中展示所有样本的真实功率值与其预测区间上下界的相对误差关系。
为验证本文模型的有效性,本小节比较了卷积神经网络-双向长短期记忆网络[17-19](Con- volutional Neural Network-Bidirectional Long Short- Term Memory, CNN-BILSTM)、自适应掩码网络[20](Adaptive Masked Network, ASMNet)、基于滞后特征的提升网络[21](Lag features-based Boosting Net- work, LagBoostNet)等模型与所提KAN-MHA模型在QR预测中的表现;此外,为突出本文对KAN的改进效果,将原始KAN模型也纳入对比。
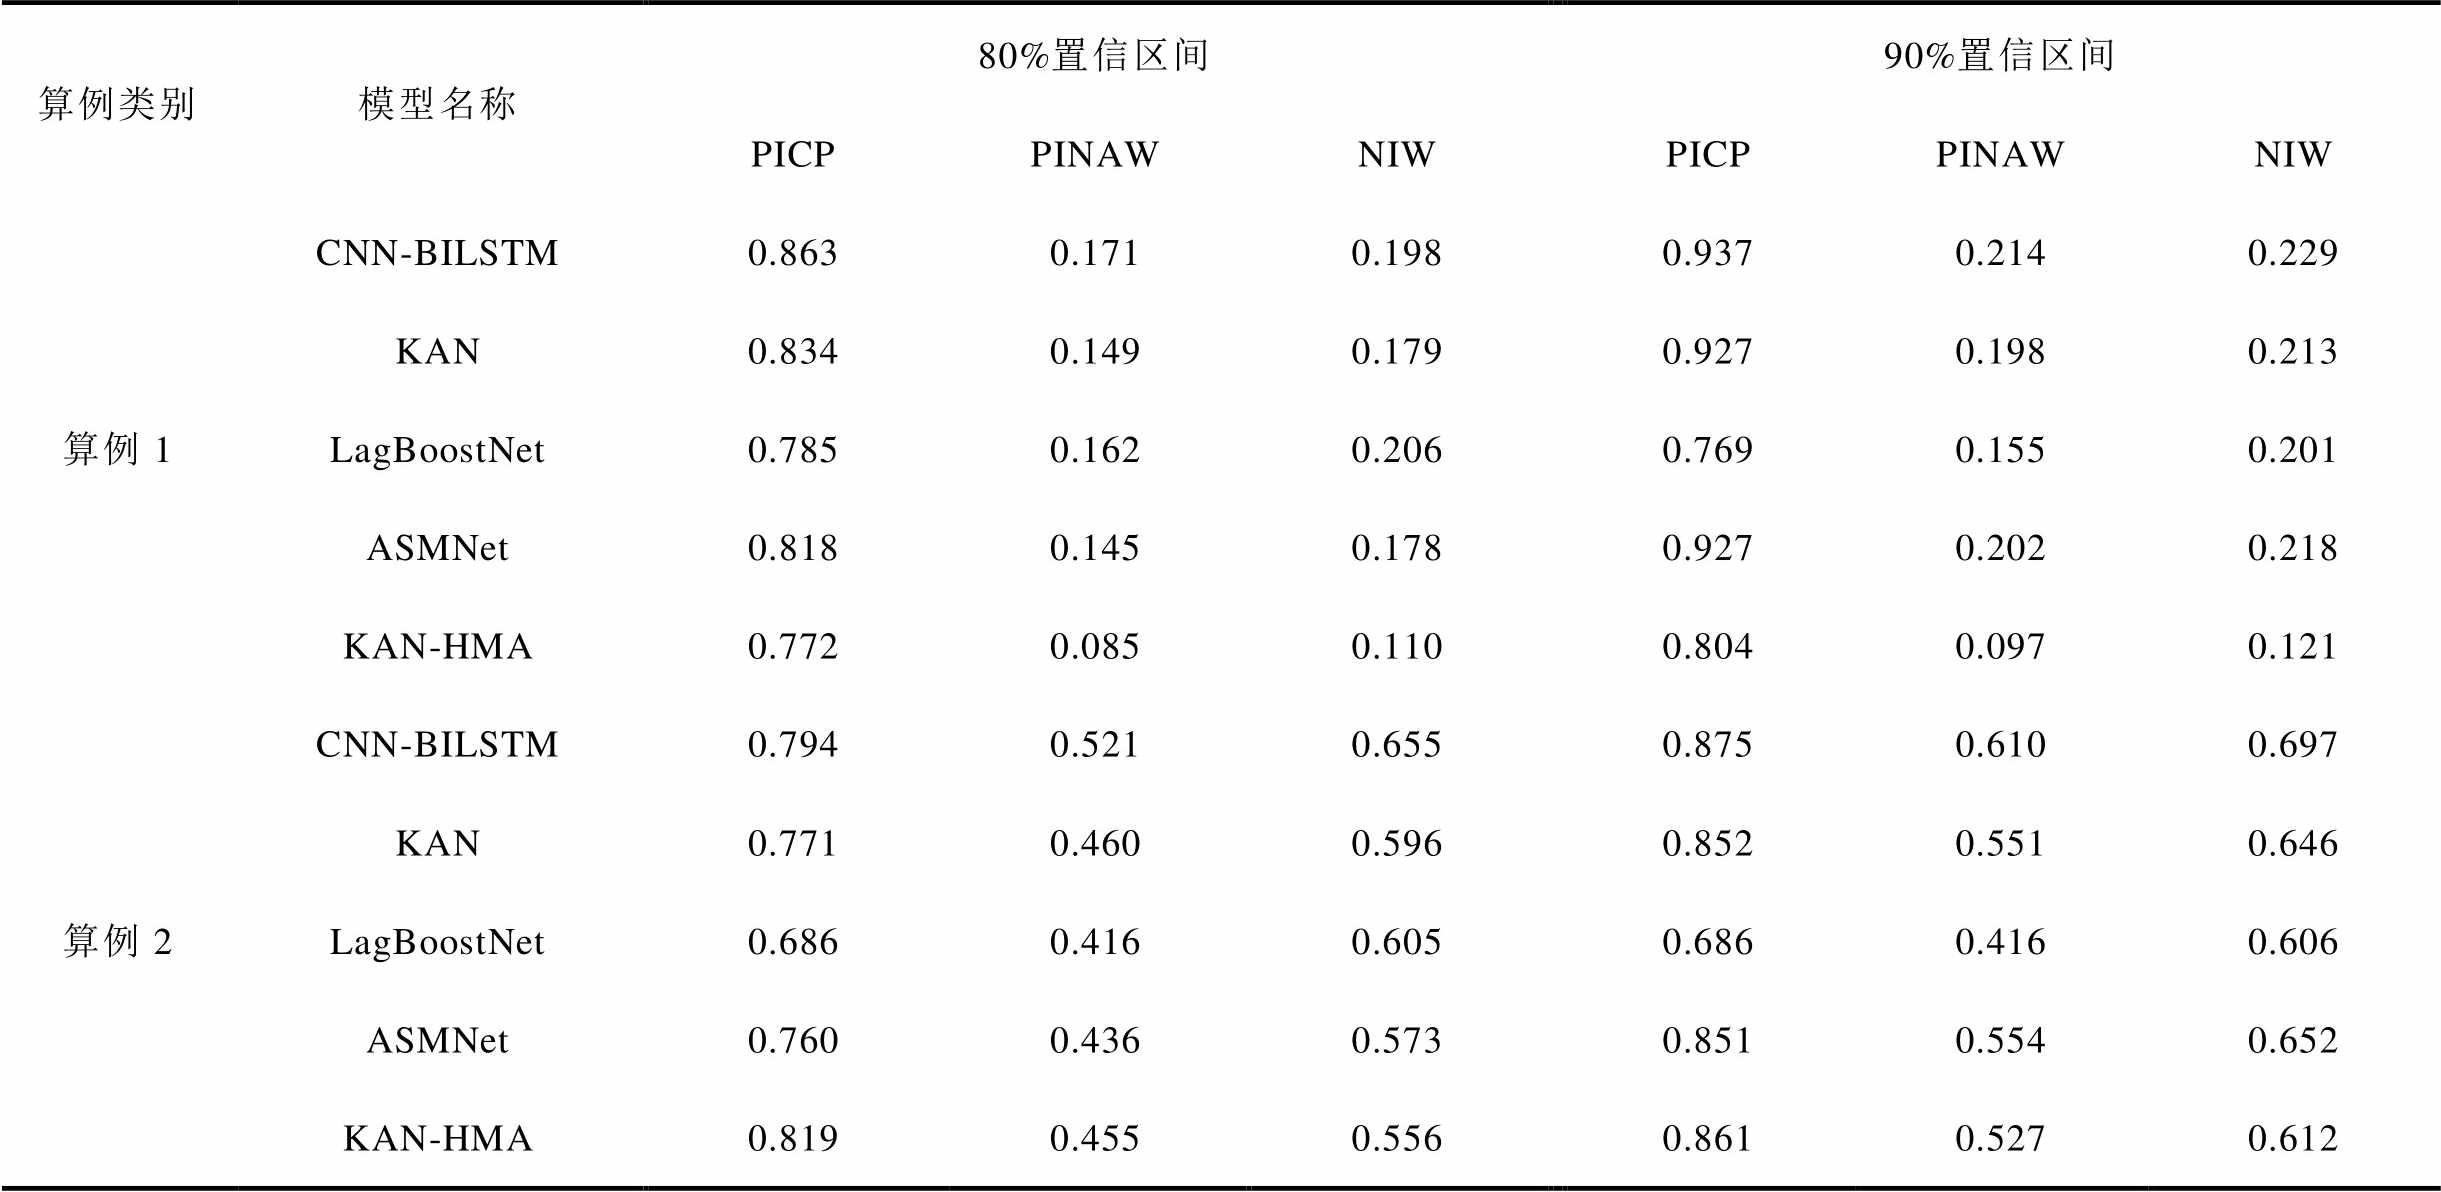
置信度越高,预测区间往往越宽,然而即便是更宽的预测区间,也难以保证能够覆盖极端的小概率事件。因此,过高的置信度不具备实际研究意义。参考文献[7, 22-23],本文设定了80%和90%两个常见的置信度水平作为预测目标,其实验结果的评价指标见表3。
现对表3中的实验结果进行分析:
从各算例的PICP值来看,超过半数的预测结果没有达到指定的置信度,因为预测模型在拟合数据时,不可避免地存在误差,故QR预测通常难以保证其结果的置信度,需要利用共形预测或非对称共形预测进行区间校正。
从各算例的NIW值来看,KAN-HMA模型在算例1中的优势较为明显,其NIW值仅为其他模型的约53%~62%。在算例2中,KAN-HMA模型的NIW值仍具有一定优势,但这一优势相较于算例1明显减弱。这是因为光伏功率建模依赖于历史数据中天气特征与实际功率之间的潜在映射关系,当天气特征与实际功率的相关性较低时,往往意味着这种映射关系较为模糊,因此KAN-HMA模型在建模性能上的优势也会随之减弱。
表3 各模型80%、90% QR区间预测结果
Tab.3 Prediction results for each model's 80% and 90% QR intervals
算例类别模型名称80%置信区间90%置信区间 PICPPINAWNIWPICPPINAWNIW 算例1CNN-BILSTM0.8630.1710.1980.9370.2140.229 KAN0.8340.1490.1790.9270.1980.213 LagBoostNet0.7850.1620.2060.7690.1550.201 ASMNet0.8180.1450.1780.9270.2020.218 KAN-HMA0.7720.0850.1100.8040.0970.121 算例2CNN-BILSTM0.7940.5210.6550.8750.6100.697 KAN0.7710.4600.5960.8520.5510.646 LagBoostNet0.6860.4160.6050.6860.4160.606 ASMNet0.7600.4360.5730.8510.5540.652 KAN-HMA0.8190.4550.5560.8610.5270.612
从KAN模型和KAN-HMA模型的预测结果来看,KAN-HMA模型的NIW值更优,说明本文模型对光伏功率的建模更加准确,多头注意力机制的引入改进了KAN时序特征提取能力的不足。
在算例1的90%置信区间中,CNN-BILSTM模型与KAN-HMA模型之间NIW值差距最明显,现对两模型的预测结果绘制3.3节中定义的上下界相对误差频数分布直方图,如图6所示。图中,误差为0即为预测区间的上界或下界。“边界内侧的样本”在上界相对误差频数分布直方图中指上界以下的样本,在下界相对误差频数分布直方图中指下界以上的样本。
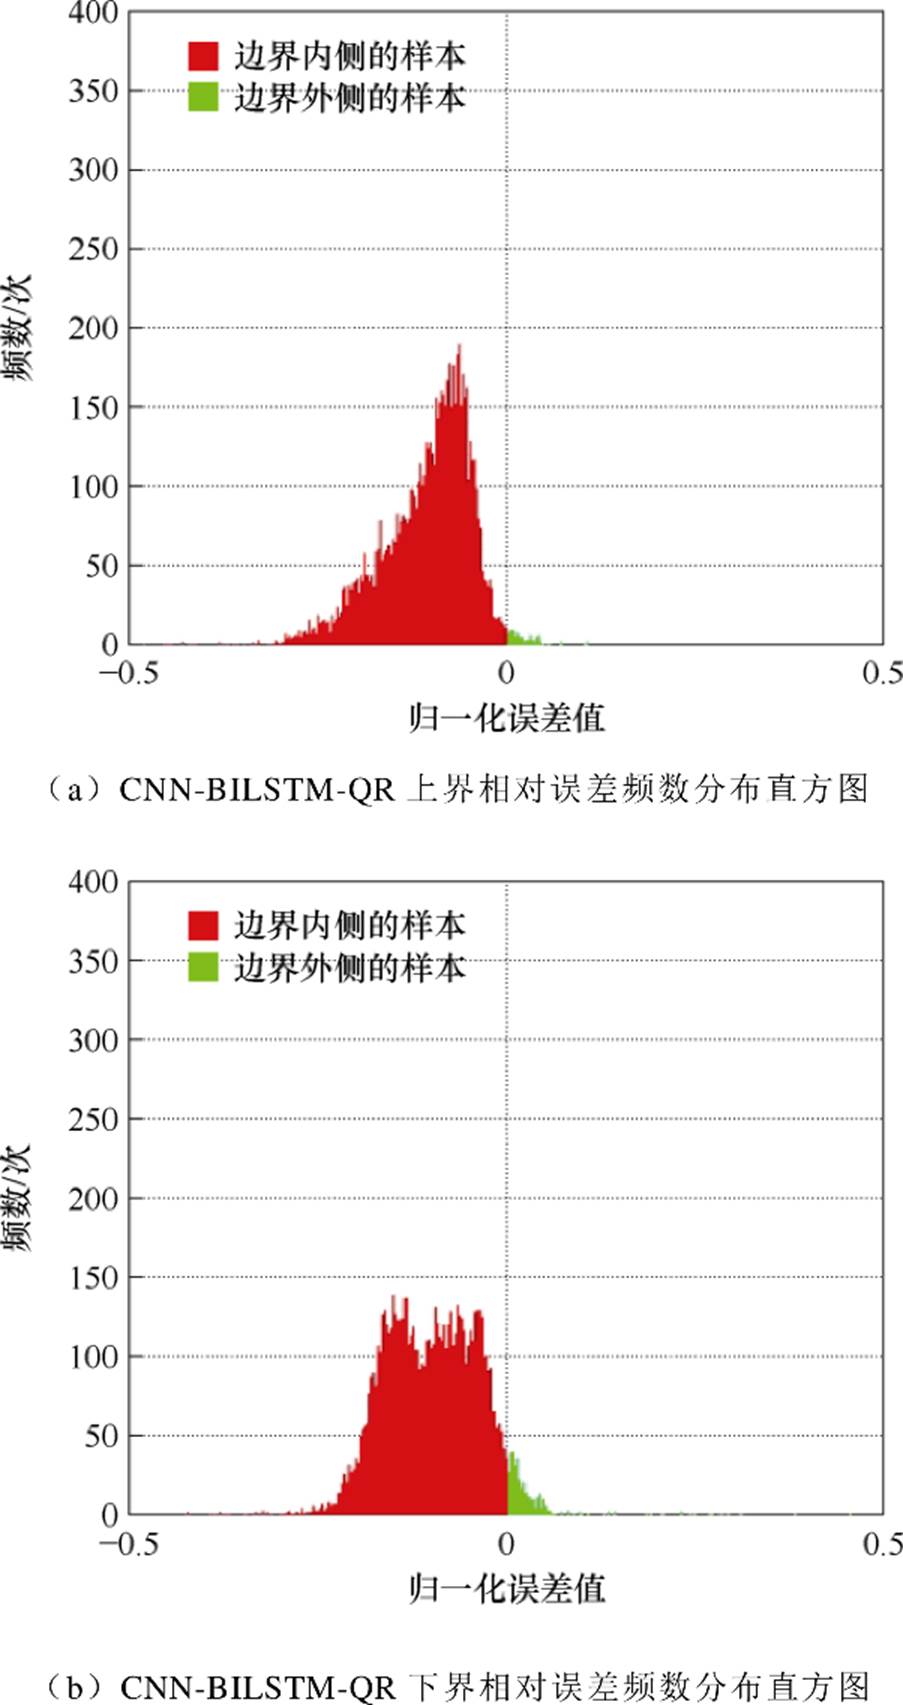
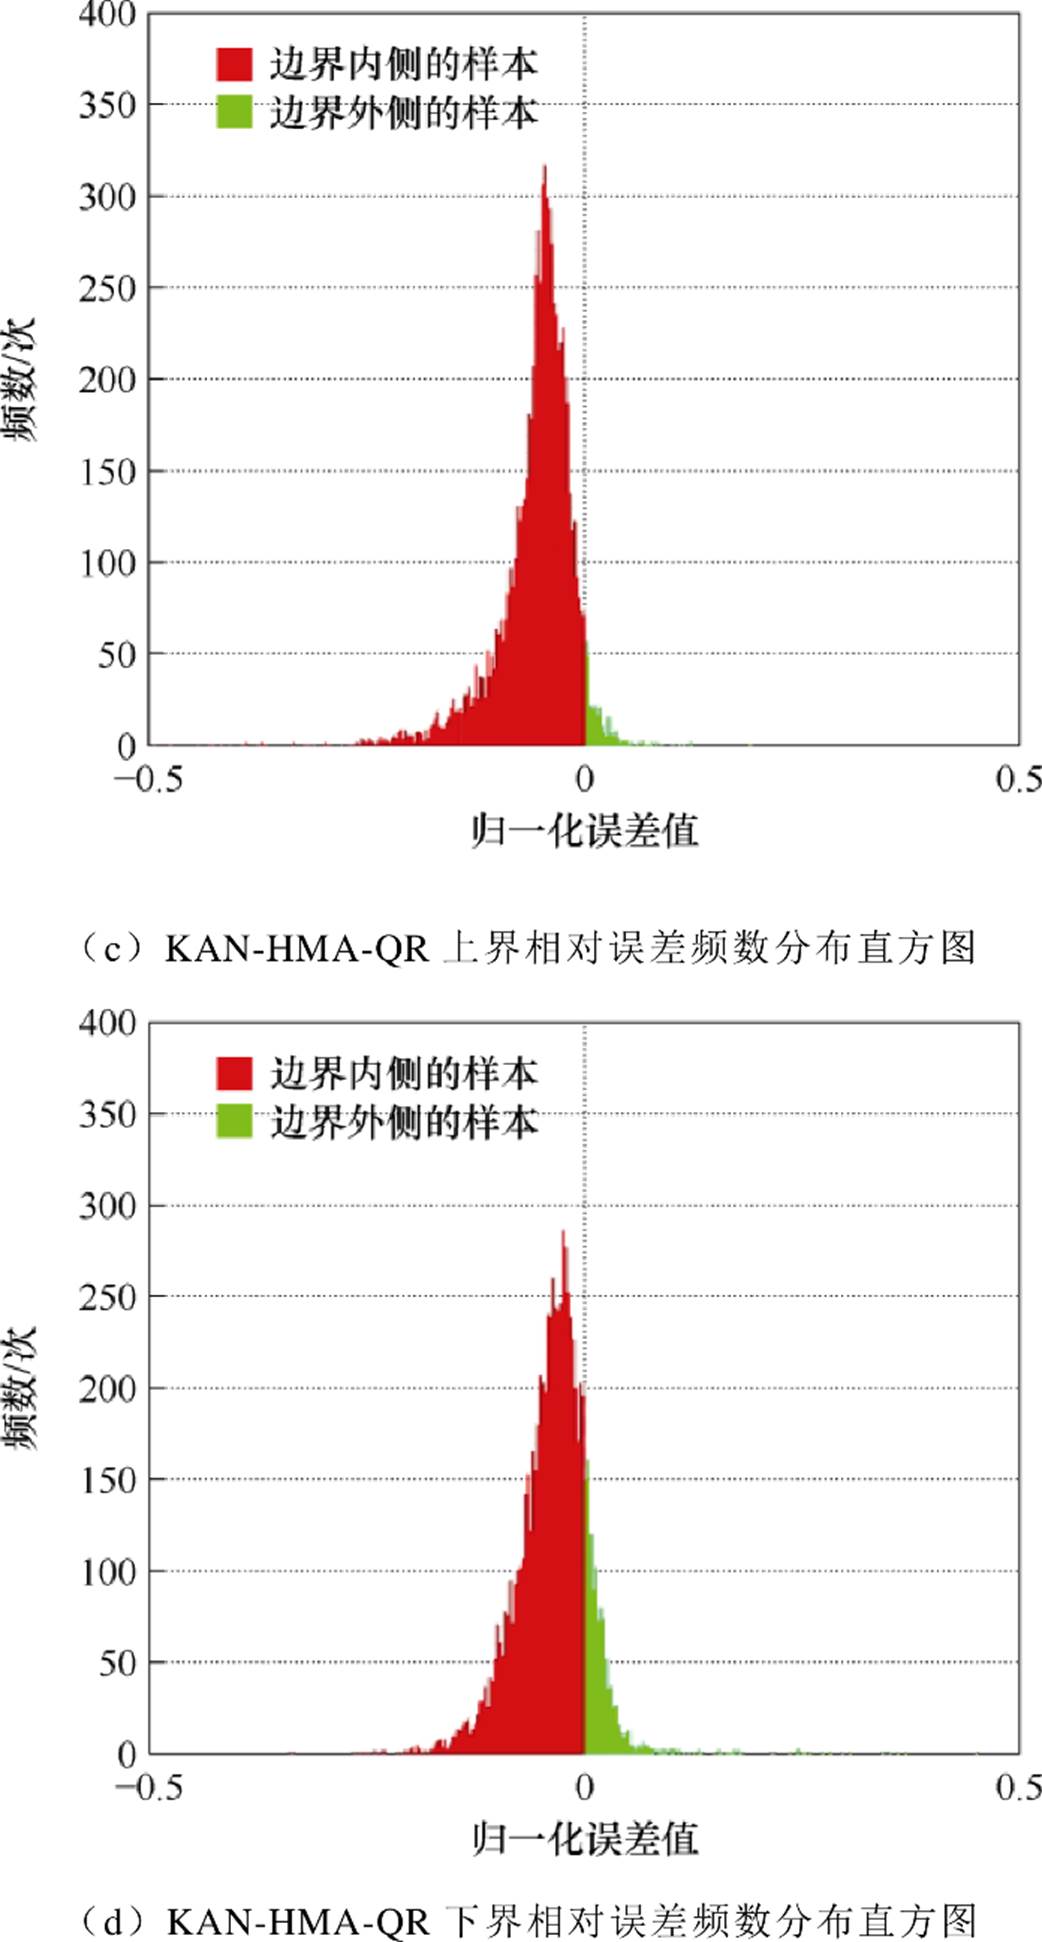
图6 算例1 QR区间预测结果上下界相对误差频数分布直方图(90%置信区间)
Fig.6 Case 1 QR interval prediction result relative error frequency distribution histogram (90% confidence interval)
对于图6展示的结果,主要关注两个方面:
(1)关注模型对光伏功率建模能力,从图6中可知,测试集样本功率真实值与KAN-HMA模型预测结果的上、下界相对误差分布更加集中,而与CNN-BILSTM模型预测结果的上、下界相对误差分布比较分散,说明KAN-HMA模型的建模更加准确,其上、下界预测曲线更加贴合功率值的分布趋势,与测试集样本功率真实值之间的距离相对固定。
(2)关注QR预测区间是否存在不对称偏移。由KAN-HMA模型预测结果上、下界的相对误差分布频数直方图可见,上界对应的频数约为60,而下界对应的频数约为160,上、下界对应的频数值差异明显,表明QR预测区间发生了不对称偏移。由表3可知,此时KAN-HMA模型预测结果的PICP尚未达到0.9,因此需要对QR预测区间进行扩张校正。与对上、下界进行对称等距扩张相比,此时优先向外扩张下界,可以在更小的扩张距离下纳入更多的样本。
本小节使用校验集样本对3.4节的预测结果进行修正,采用传统的CQR方法和本文所提ACQR方法进行对比,同样在测试集上进行修正结果的评估,各模型CQR、ACQR区间预测结果见表4。
表4 各模型CQR、ACQR区间预测结果
Tab.4 Prediction results of CQR and ACQR intervals for each model

现对表4中的实验结果进行分析:
从表4中各算例的PICP指标可以看出,绝大部分预测结果都达到了预设置信度,少数未达到置信度要求的算例,其PICP值与目标值的差距也均控制在1%以内,这是误差的允许范围,说明ACQR和CQR在PICP指标上整体均能满足要求。
观察各算例的PINAW可见,KAN-HMA模型在所有区间的算例中均表现为最优,说明该模型在预测区间宽度的紧凑性上优于其他模型。进一步观察各算例的PINAW可以发现,在绝大多数情况下,对于同一算例、同一置信度和同一模型,ACQR得到的预测区间均比CQR更窄。虽然在个别情形下CQR的PICP略优于ACQR,但在ACQR和CQR的PICP均已满足置信度要求的前提下,二者预测区间的紧致性更为关键。为了更加直观地对比CQR与ACQR预测结果的区间宽度,图7计算了表4中同一算例、同一置信度、同一模型下ACQR与CQR预测区间宽度之比。

图7 ACQR与CQR区间预测结果的PINAW之比
Fig.7 The ratio of PINAW between ACQR and CQR interval predictions
从图7可以看出,在绝大部分算例中,ACQR与CQR预测结果的PINAW之比小于1;二者比值最小的情形出现在KAN-HMA模型算例1在80%置信区间下的预测结果中,仅为0.906,表明此时ACQR预测区间的宽度相比CQR缩小了约9.4%。
在3.4节对图6的分析中可知,KAN-HMA模型在算例1-90%置信区间下的QR预测结果存在明显的不对称偏移。为了对比验证ACQR、CQR能否校正这一偏移,如图8展示了KAN-HMA模型算例1在90%置信区间下ACQR、CQR预测结果的上、下界相对误差频数分布直方图。
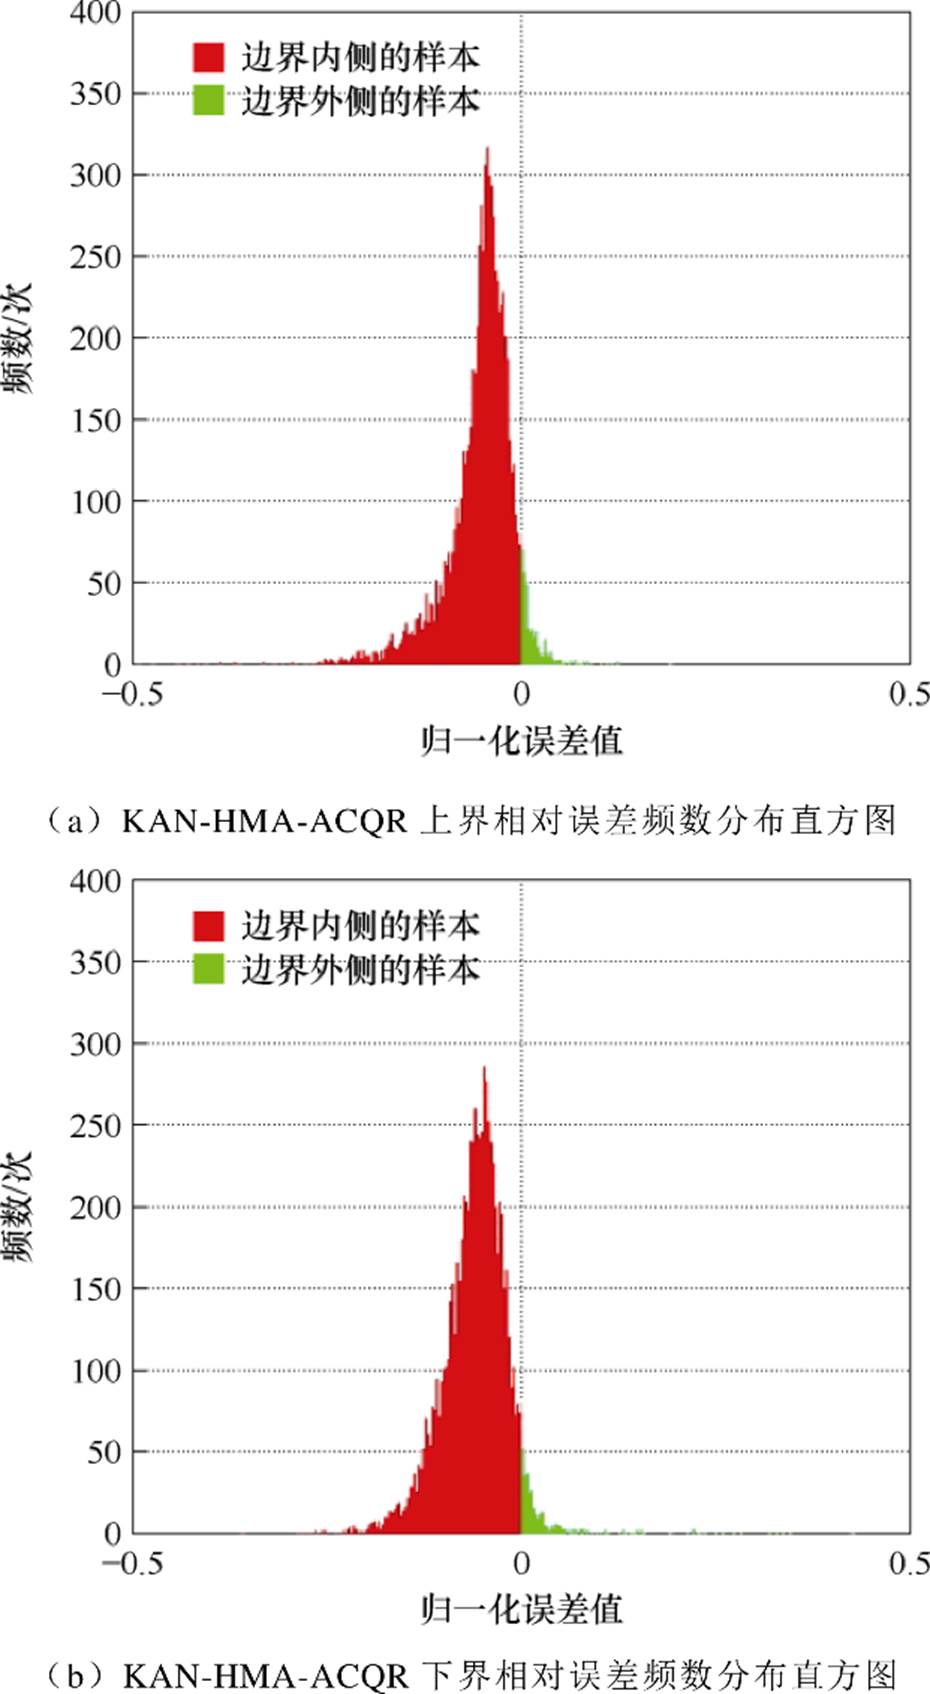

图8 KAN-HMA模型算例1-90%置信区间预测结果上下界相对误差频数直方图
Fig.8 KAN-HMA model Case 1-histogram of relative errors of upper and lower bounds for 90% confidence interval predictions
由图8可以观察到,ACQR预测区间上、下界对应的频数值相当,在50~70之间;而CQR预测区间上界对应的频数值约为20,下界约为80,存在明显差异。上述结果表明,ACQR能够有效校正QR预测区间的不对称偏移,而CQR仍然保留了QR预测区间的这种不对称性。
这一现象与1.3节中的理论分析相一致:CQR采用的上下界对称修正方式无法消除QR预测区间的不对称偏移,导致其覆盖的样本并非主要集中在整体分布最中心的区域,为满足覆盖率要求,不得不牺牲区间宽度,采用更大的区间跨度。相比之下,ACQR通过对上下界进行不对称修正,可以有效校正QR预测区间的不对称偏移,使预测区间更加集中地覆盖样本分布最中心的区域。从区间宽度的角度看,该区域对应的预测区间更加紧致;从预测需求的角度看,样本分布的中心区域恰是大概率事件聚集的部分,也是区间预测所关注的核心目标。
图9为KAN-HMA模型ACQR区间预测结果。由于测试集样本量较大,仅选取了两个算例的四个时窗进行展示。
本文针对共形分位数回归(CQR)在光伏功率区间预测中易出现区间整体偏移或跨度过大的问题,提出了一种结合Kolmogorov-Arnold网络(KAN)与多头注意力机制(MHA)的时序回归模型,并设计了非对称共形分位数回归(ACQR)方法。在理论分析与实验验证的基础上,得出以下结论:

图9 KAN-HMA模型ACQR区间预测结果
Fig.9 KAN-HMA model ACQR interval prediction results
1)本文提出的KAN-MHA模型在光伏功率时序回归预测中表现优异,充分结合了KAN的非线性拟合能力和MHA的时序特征提取能力,使得分位数回归的预测结果更贴近样本分布。在所有实验中,经过CQR或ACQR修正后,KAN-MHA模型可满足覆盖率要求,并能够提供比CNN-BILSTM、LagBoostNet、ASMNet以及KAN模型更紧凑的预测区间。
2)在区间修正方面,本文提出的ACQR能够校正QR预测中存在的不对称偏移,使预测区间更贴近样本分布的中心,在保证覆盖率的前提下显著缩小预测区间的跨度。实验结果表明,当QR预测区间存在较大不对称偏移时,ACQR预测区间的跨度约为CQR预测区间的90.6%。
尽管本文方法在光伏功率区间预测中取得了较好效果,但仍存在进一步的研究空间。未来工作可在以下几个方面展开:①考虑引入更多气象与运行特征,提升模型对复杂环境条件的适应性;②探索KAN-HMA模型和ACQR在风电、负荷等其他时序预测场景中的推广应用。
参考文献
[1] 杨明, 李梦林, 王勃, 等. 面向新型电力系统的数值天气预报技术及应用综述[J]. 电力系统自动化, 2025, 49(17): 1-20.
Yang Ming, Li Menglin, Wang Bo, et al. Review on technologies and applications of numerical weather prediction for new power system[J]. Automation of Electric Power Systems, 2025, 49(17): 1-20.
[2] 彭春华, 张浩旗, 孙惠娟, 等. 基于延迟感知多智能体深度强化学习的多光储直柔系统优化调度[J]. 电工技术学报, 2026, 41(11): 3742-3754.
Peng Chunhua, Zhang Haoqi, Sun Huijuan, et al. Optimal scheduling of multi PV-storage-DC-flexible systems based on delay-aware multi-agent deep reinforcement learning[J]. Transactions of China Electrotechnical Society, 2026, 41(11): 3742-3754.
[3] 杨茂, 张书天, 王勃, 等. 基于混合分位数回归长短期记忆神经网络的风电功率短期区间预测[J]. 太阳能学报, 2025, 46(2): 582-590.
Yang Mao, Zhang Shutian, Wang Bo, et al. Short- term wind power interval prediction based on mixed quantile regression long and short-term memory neural network[J]. Acta Energiae Solaris Sinica, 2025, 46(2): 582-590.
[4] 柳天虹, 齐胜利, 裔扬, 等. 基于分位数回归的改进权重GRU风电功率区间预测[J]. 太阳能学报, 2024, 45(12): 291-298.
Liu Tianhong, Qi Shengli, Yi Yang, et al. Improved weighted GRU wind power interval prediction based on quantile regression[J]. Acta Energiae Solaris Sinica, 2024, 45(12): 291-298.
[5] 赵耀, 高少炜, 李东东, 等. 基于天气相似聚类与QRNN的短期光伏功率区间概率预测[J]. 电力系统自动化, 2023, 47(23): 152-161.
Zhao Yao, Gao Shaowei, Li Dongdong, et al. Short-term interval probability prediction of photo- voltaic power based on weather similarity clustering and quantile regression neural network[J]. Auto- mation of Electric Power Systems, 2023, 47(23): 152- 161.
[6] 张昆明, 马龙义, 章天晗, 等. 基于iDGA-LSTM的分布式光伏出力时空协同概率预测方法[J]. 电力系统自动化, 2025, 49(1): 128-138.
Zhang Kunming, Ma Longyi, Zhang Tianhan, et al. Spatio-temporal cooperative probability forecasting method for distributed photovoltaic output based on iDGA-LSTM[J]. Automation of Electric Power Systems, 2025, 49(1): 128-138.
[7] 杨茂, 张书天, 王勃, 等. 基于门控循环加权共形分位数回归的风电功率短期区间预测[J]. 中国电机工程学报, 2025, 45(19): 7565-7574.
Yang Mao, Zhang Shutian, Wang Bo, et al. Short- term wind power interval prediction based on weighted gated recurrent conformalized quantile regression[J]. Proceedings of the CSEE, 2025, 45(19): 7565-7574.
[8] 彭依明, 王佳, 周长城, 等. 基于BiLSTM-SA的分布式光伏功率超短期概率预测[J]. 南方电网技术, 2025, 19(11): 172-181.
Peng Yiming, Wang Jia, Zhou Changcheng, et al. Ultra-short-term probability prediction of distributed photovoltaic power based on BiLSTM-SA[J]. Southern Power System Technology, 2025, 19(11): 172-181.
[9] 彭昱, 符琛, 郭昕, 等. 基于FCM-BOA-TCN-GRU的分布式光伏出力异常检测方法[J]. 电工技术学报, 2025, 40(17): 5389-5401.
Peng Yu, Fu Chen, Guo Xin, et al. Distributed photovoltaic power output anomaly detection method based on FCM-BOA-TCN-GRU[J]. Transactions of China Electrotechnical Society, 2025, 40(17): 5389- 5401.
[10] Liu Ziming, Wang Yixuan, Vaidya S, et al. KAN: Kolmogorov-Arnold networks[J]. arXiv: 2404.19756, 2024.
[11] 刘栋, 郭国栋, 辛蜀骏, 等. 基于KAN的可解释净负荷概率预测方法[J]. 电力系统自动化, 2025, 49(15): 123-132.
Liu Dong, Guo Guodong, Xin Shujun, et al. Probabilistic prediction method for interpretable net load based on Kolmogorov-Arnold network[J]. Automation of Electric Power Systems, 2025, 49(15): 123-132.
[12] 成润坤, 王辉, 刘达, 等. 融合RSDE框架与KAN算法的现货电价异质模型集成预测[J]. 中国电机工程学报, 2024, 44(24): 9645-9657.
Cheng Runkun, Wang Hui, Liu Da, et al. Ensemble prediction of spot electricity prices using hetero- geneous models by integrating the RSDE framework and KAN algorithm[J]. Proceedings of the CSEE, 2024, 44(24): 9645-9657.
[13] 桂前进, 徐文法, 李晓阳, 等. 基于时序分解与共形分位数回归的超短期光伏功率区间预测[J]. 中国电力, 2025, 58(5): 21-32.
Gui Qianjin, Xu Wenfa, Li Xiaoyang, et al. Ultra- short-term photovoltaic power interval forecasting based on time-series decomposition and conformal quantile regression[J]. Electric Power, 2025, 58(5): 21-32.
[14] 焦治杰, 王小君, 刘曌, 等. 考虑分布式新能源出力不确定性的虚拟电厂概率可行域构建方法[J]. 电力系统自动化, 2024, 48(18): 129-138.
Jiao Zhijie, Wang Xiaojun, Liu Zhao, et al. Con- struction method for probability-based feasible region of virtual power plant considering uncertainty of distributed renewable energy output[J]. Automation of Electric Power Systems, 2024, 48(18): 129-138.
[15] Desert Knowledge Australia Solar Centre. DKA solar Centre[EB/OL]. (2025-07-09)[2025-08-29]. https:// dkasolarcentre.com.au/.
[16] 国能日新第二届光伏功率预测赛[EB/OL]. (2024- 09-06)[2025-08-29]. https://gitcode.com/open-source- toolkit/6e0d3.
[17] 李楠, 王鹤潼, 张光耀, 等. 基于双重分解策略与MSTCN-BiLSTM的超短期负荷预测[J/OL]. 电工技术学报, 1-19 [2025-12-15].
Li Nan, Wang Hetong, Zhang Guangyao, et al. Short- term load forecasting based on dual decomposition strategy and MSTCN-BiLSTM[J/OL]. Transactions of China Electrotechnical Society, 1-19 [2025-12-15].
[18] 杨朵, 吕浩然, 李民策, 等. 基于双向长短期记忆网络和注意力机制的质子交换膜燃料电池衰退行为预测[J]. 电工技术学报, 2026, 41(2): 701-713, 724.
Yang Duo, Lü Haoran, Li Mince, et al. Prediction of degradation behavior in proton exchange membrane fuel cells based on bi-long short-term memory and attention mechanism[J]. Transactions of China Elec- trotechnical Society, 2026, 41(2): 701-713, 724.
[19] 高爽, 李辰昊, 李泽宇, 等. 考虑波浪作用和时序特性的海上漂浮式光伏阵列故障诊断方法[J]. 电工技术学报, 2026,41(3): 999-1011.
Gao Shuang, Li Chenhao, Li Zeyu, et al. Fault diagnosis method for offshore floating photovoltaic array considering wave effects and temporal chara- cteristics[J]. Transactions of China Electrotechnical Society, 2026,41(3): 999-1011.
[20] Ma Qiaoyu, Fu Xueqian, Yang Qiang, et al. Adaptive masked network for ultra-short-term photovoltaic forecast[J]. Engineering Applications of Artificial Intelligence, 2025, 139: 109555.
[21] Yang Feifei, Fu Xueqian, Li Zhengshuo, et al. A novel clustering-ensemble learning model for day- ahead photovoltaic power forecasting[J]. Engineering Applications of Artificial Intelligence, 2025, 161: 112281.
Photovoltaic Power Interval Prediction Based on KAN-MHA and Asymmetric Conformal Quantile Regression
Abstract First, this paper systematically reviews the basic principles of conformal prediction (CP), quantile regression-based prediction (QR), and conformal quantile regression (CQR). It is noted that when the original QR prediction intervals exhibit pronounced asymmetric bias, the symmetric calibration strategy used by CQR unnecessarily inflates the interval width. To address this issue, this paper proposes an asymmetric conformal quantile regression method (ACQR). In ACQR, the calibration residuals are split into two sets of nonconformity scores for the lower and upper bounds, respectively. Correction terms are then extracted by quantile and used to asymmetrically shift the bounds. In this way, the method aims to eliminate asymmetric bias and shrink the ineffective parts of the interval, while satisfying the desired coverage level.
This paper discusses the impact of the QR model’s fitting capability on the width of the final prediction interval. Improving the QR model’s fitting accuracy is a prerequisite for obtaining tight prediction intervals, thereby motivating the proposed KAN-MHA model. The structure of KAN-MHA is then described: using KAN as the basic building block, the model comprises a spatial feature-extraction module, a temporal feature-extraction module, and a fully connected layer that fuses spatial and temporal features to produce the predicted power.
Results from two real-world cases demonstrate that the proposed KAN-MHA+ACQR method achieves excellent prediction accuracy and interval tightness. In Case 1, meteorological features are strongly correlated with PV power, indicating that numerical weather prediction is relatively accurate. At the 80% and 90% confidence levels for QR-based prediction, the mean interval width (PINAW) of KAN-MHA is significantly smaller than those of the CNN-BiLSTM, LagBoostNet, ASMNet, and KAN models, achieving approximately 38%~47% interval compression. In Case 2, the correlation between meteorological features and power is weaker, representing scenarios with larger numerical weather prediction errors. Although the overall prediction accuracy of all models decreases, KAN-MHA still achieves the best performance. A further comparison between ACQR and CQR shows that in the vast majority of experimental settings, ACQR yields lower PINAW than CQR, and in the best case, PINAW can be reduced to 90.6% of that obtained by CQR. Visualization results indicate that, compared with CQR, ACQR’s upper and lower bounds of the prediction intervals are more symmetric and better aligned with the actual power distribution.
The following conclusions can be drawn. (1) Compared with CQR, the proposed ACQR method can effectively reduce the prediction interval width while ensuring the required coverage, thereby alleviating the interval inflation problem caused by asymmetric bias. (2) The proposed KAN-MHA model achieves tighter and more reliable prediction intervals across different case studies. (3) The combination of the KAN-MHA model with the ACQR method provides reliable and compact short-term PV power prediction intervals. This paper offers an effective and valuable new approach for engineering applications of short-term interval prediction of PV power.
keywords:Photovoltaic power range prediction, Kolmogorov-Arnold network, multi-head attention mechanism, asymmetric conformal quantile regression
中图分类号:TM614
DOI: 10.19595/j.cnki.1000-6753.tces.251649
国家重点研发计划资助项目(2022YFB2403500)。
收稿日期2025-09-22
改稿日期 2025-11-12
李 嵩 男,2001年生,硕士研究生,研究方向为新能源出力预测及电力系统优化调度。
E-mail: 452785748@qq.com
夏成军 男,1974年生,博士,副教授,研究方向为电力系统分析运行与控制。
E-mail: cjxia@scut.edu.cn(通信作者)