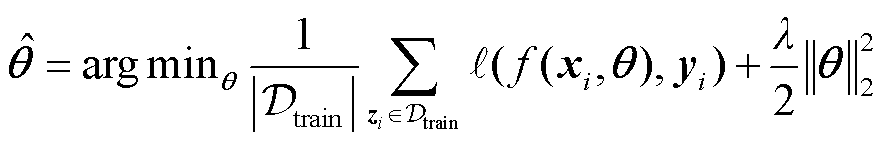 (1)
摘要 准确的超短期负荷预测对于电力系统的实时调控与安全稳定运行至关重要。传统的集中式协同建模方法依赖跨域数据汇集,易引发数据安全问题;而现有联邦学习面临全局模型收敛慢、通信成本高的难题。为此,该文提出一种考虑低通信成本的张量分解个性化联邦学习超短期电力负荷预测方法。首先,使用张量分解技术设计了一种新的张量化本地模型,以降低通信成本;其次,设计了双层损失函数,通过控制个性化模型与张量本地模型之间的距离,实现个性化模型的优化与张量本地模型的解耦;最后,根据模型参数张量化特性,设计了一种高效的个性化学习策略和集成张量聚合机制,实现全局模型的聚合与更新。通过理论分析与实验验证,表明所提方法在完成快速收敛的同时,有效地提升了模型的鲁棒性与泛化能力,增强了预测稳定性,降低了联邦学习模型训练过程中的通信成本。
关键词:联邦学习 张量分解 个性化学习策略 低通信成本 负荷预测
随着电力需求的持续增长,准确的超短期负荷预测(Ultra-Short-Term Load Forecasting, USTLF)对于提升电网调控效率、增强系统运行灵活性与供电可靠性具有重要意义[1-2]。然而,电力需求具有显著的时空波动性,为准确感知其变化规律带来了巨大挑战。电力供应商亟须采用先进的数据分析技术,深入挖掘用电行为特征和负荷需求模式,从而提升对电力需求变化的感知能力,实现精细化运营。
从技术路线来看,当前电力负荷预测领域的协同建模方法主要可分为两类:集中式协同建模和分布式协同建模。集中式协同建模方法将各运营商数据集中存储在同一服务器,以便在单一环境中训练模型。文献[3]将Transformer与图神经网络结合以捕捉负荷与需求响应信号之间的复杂关联,但其预测性能在较大程度上依赖多维数据的支撑。文献[4]提出了一种两阶段自适应概率预测框架,以有效应对负荷随时间变化的不确定性,但模型复杂性较高。文献[5]提出了一种基于非侵入式负荷分解的两阶段超短期负荷预测方法,有效地解决了目前深度分解模型对负荷特征提取不充分、分解精度低的问题,但其对波动性较大的局部峰值拟合能力仍存在不足。文献[6]通过改进传统Transformer模型,嵌入序列分解模块、自相关计算模块和空间注意力模块,有效地提升了负荷预测的准确性,但其跨多场景的泛化能力与鲁棒性仍有待提升。文献[7]提出了一种由集合经验模态分解、改进型卷积块注意力模块和双向长短期记忆神经网络(Bi-directional Long Short-Term Memory, BiLSTM)的组合预测方法,有效地降低了牵引负荷超短期预测误差与计算成本,但其对突变负荷的泛化能力不足。文献[8]基于序列神经基扩展分析提高了对高波动性负荷的预测精度,但损失函数设计过于依赖特定场景,泛化能力有限。集中式建模在依赖单一供应商本地数据时,样本规模和特征覆盖受限,难以充分反映负荷多样性;而跨区域数据整合虽可缓解数据稀缺,却会不可避免地增加通信与存储成本,同时带来隐私风险。
联邦学习通过分布式协同建模,有效地规避了数据传输过程中可能面临的隐私泄露风险,同时减少了数据集中存储带来的成本[9]。文献[10]提出了一种安全联邦学习框架,通过仅将客户端训练后的梯度符号传输到控制中心,解决了模型参数泄露和网络攻击威胁问题,但其在复杂负荷场景下的预测精度有待提升。文献[11]提出了一种用于多能负荷预测的PPenergyNET框架,设计了一种保护数据隐私的环形结构纵向联邦学习机制来解决数据隔离问题,但其模型结构带来的精度损失在一定程度上影响了实际应用效果。文献[12]提出了一种基于自适应横向联邦学习的需求响应基线负荷估计方法,使用自适应学习率对本地模型参数进行聚合,以稳定参数聚合过程并增强模型的泛化能力,但其训练过程通信成本高昂。文献[13]提出了一种结合可微架构搜索与两阶段个性化的联邦学习模型,通过用户聚类、全局协同更新与本地微调,有效地缓解了负荷波动与消费异质性问题,但其架构搜索需要较多通信轮次,导致收敛速度慢。文献[14-15]均基于联邦聚类与联邦预测两阶段架构,以兼顾数据异构性与隐私保护,聚类方法的引入使相似模式用户共享知识,在一定程度上提升了预测精度,但其对聚类数敏感,限制了模型在多工况电力系统中的泛化能力。
针对联邦学习在非独立同分布数据中收敛慢与通信成本高的问题,文献[16]通过将Moreau包络作为客户端的正则化损失函数,以双层优化问题的形式实现了个性化模型优化与全局模型学习的解耦,使其在非独立同分布数据上快速收敛,同时保持优异性能。然而,基于莫罗包络的个性化联邦学习(personalized Federated learning with Moreau envelopes, pFedMe)算法仍无法解决联邦学习中用户与服务器间通信成本问题。文献[17]提出了一种自适应通信周期控制方法,以平衡通信效率与收敛速度的平衡问题,但其通过控制通信周期的方式来控制通信成本与收敛速度,模型的鲁棒性与泛化能力较差。文献[18]提出了一种分层分割聚合方法,通过特征提取层的参数冗余消除来优化传输效率,但存在非独立同分布数据下分层权重分配不均和动态环境适应性不足的问题。文献[19]提出了一种基于相似度的服务器端动态剪枝方法,利用全局模型作为阈值矩阵指导局部模型剪枝,但存在全局模型与局部模型对齐难问题,且在极端剪枝率下容易导致模型发散。文献[20]提出了一种基于边缘数据分布优化的分层联邦学习框架,通过边缘数据分布整形和两级聚合机制平衡通信效率与模型性能,但边缘节点选择对初始数据分布的敏感性严重限制了模型的适用性。
现有联邦学习方法大多未能同时兼顾客户端与服务器之间的通信成本和模型收敛效率。在全局模型聚合过程中,也往往忽视了各客户端数据分布的异质性,从而限制了模型在不同应用场景下的适应性与稳定性。为在保障用户隐私和预测精度的基础上,降低通信成本、加速模型收敛并提升泛化能力,本文提出一种考虑低通信成本的张量分解个性化联邦学习超短期电力负荷预测方法。该方法基于个性化集成张量聚合联邦学习(personalized Federated learning with Aggregating Composed Tensor, pFedACT)全局模型策略,通过对本地模型和全局模型的张量分解,实现模型压缩和特征提取,设计个性化联邦学习训练策略与双层目标函数,解耦张量本地模型与个性化模型,并通过集成张量聚合机制实现全局模型更新与泛化能力提升。
在超短期负荷预测中,为获得最优负荷预测模型,通常将模型训练过程形式转换为结构风险最小化问题,其优化过程可表示为
(1)
式中,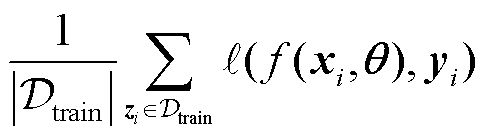 为经验风险项;
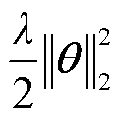 为结构风险加权项;
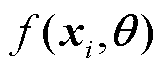 为由参数
 定义的负荷预测模型;
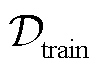 为训练数据样本集;
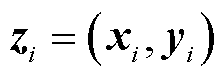 ,
 为历史负荷数据,
 为当前时刻实际负荷;
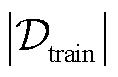 为训练数据集的大小;
 为模型训练后得到的最优模型参数。损失函数
 引导模型的拟合过程,L2正则化系数
 用于缓解过拟合问题。
然而,在实际电力系统中,数据分布于不同区域,集中式数据驱动建模需将数据跨域传输至同一存储设备,在数据安全方面面临严峻挑战。联邦学习允许各参与方在本地完成模型训练,并通过参数聚合实现协同建模。在该框架下,服务器与客户端之间通过模型参数的广播与聚合实现协作,可分别表示为
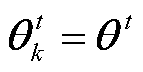 (2)
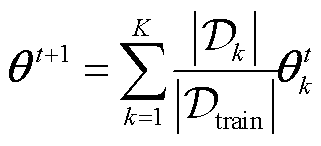 (3)
式中, 为客户端的总数;
 为客户端
 的训练集数据量;
 为第
 次训练过程中客户端的模型参数;为第次训练后的全局模型。从中可以看出以下两点。
1)在参数广播与聚合过程中,服务器需在每轮训练中将全局模型参数发送至所有客户端,同时客户端也需上传本地模型参数至服务器。这一过程涉及大量数据传输,尤其是在模型复杂、参数量大时,通信成本将显著增加。
2)高维复杂参数在分布式训练中易引入噪声与冗余信息,导致权重矩阵呈现明显的低秩结构,进而引发参数空间膨胀,使得通信轮次随模型复杂度呈超线性增长,从而严重制约了联邦学习的收敛效率。
为解决上述问题,本文提出了一种兼顾模型训练效率与通信成本的张量分解个性化联邦学习超短期负荷预测方法。该方法利用张量分解技术对模型参数进行特征提取与压缩,在有效降低通信成本的同时,提升了参数时空表达能力,实现了模型的高效聚合与个性化建模。
为高效表征和处理电力负荷数据中隐含的多维时空关联特征,本文采用欧拉字母对张量进行符号化表示。向量 的第
 个元素表示为
 ;矩阵
 的第(i, j)个元素表示为
 ;三阶张量
 的第(i, j, k)个元素表示为
 ;序列中的第
 个元素以带有括号的上标形式表示,例如,
 表示矩阵序列中的第个矩阵。
对于矩阵和 ,克罗内克积表示为
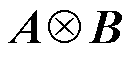 ,卡特里-拉奥积表示为
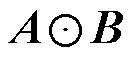 ,哈达玛积表示为
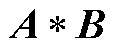 。张量
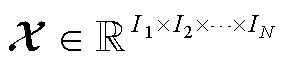 的弗罗贝尼乌斯范数定义为
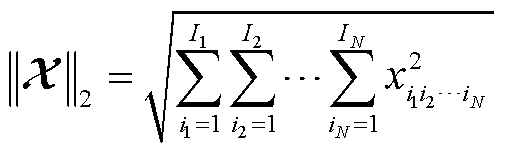 (4)
两个相同大小的张量内积定义为
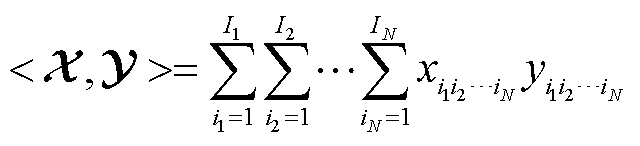 (5)
如果一个 维张量可以表示为个向量的外积,那么这个张量的秩是1。将多维张量重新排列成矩阵的过程称为张量展平。在此过程中,原始张量按特定维度被重组为矩阵形式,从而有效简化了数据结构。对于张量
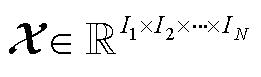 ,将其沿着维度展开写成
 。模积表示张量和矩阵在维度的乘积,用
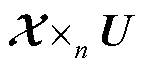 表示张量
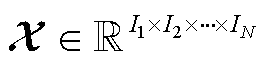 与矩阵
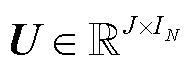 的模乘积。模积可以表示为张量的展开形式,即
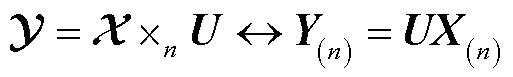 。模积与张量和向量的乘法相同,结果是一个N-1维的张量。一个张量可以与多个矩阵或向量相乘,例如,对于一系列向量
 ,
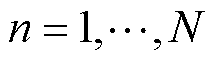 ,所有模式的乘积是一个标量,表示为
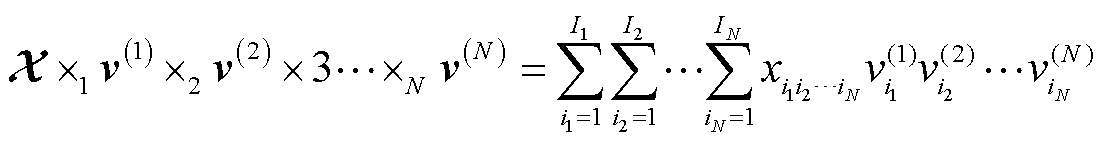 (6)
CANDECOMP/PARAFAC(CP)分解可将张量分解为一系列秩为1的张量之和。对于一个N维张量和一个正整数 ,可以采用式(7)形式表示。
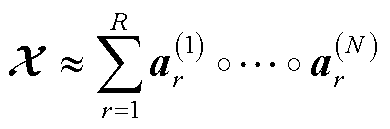 (7)
式中, 表示向量的外积;向量
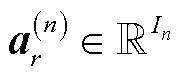 ,
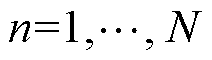 ,
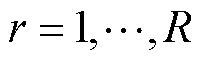 ,而最小的被称为CP秩,这些向量构成因子矩阵
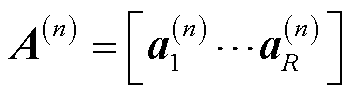 。使用克鲁斯卡尔算子,CP分解可以写为
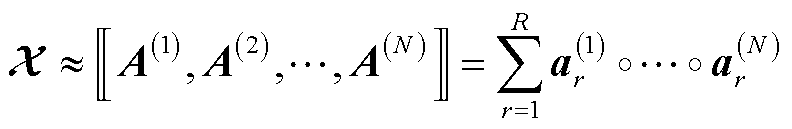 (8)
此外,该乘积可以写成矩阵形式,有
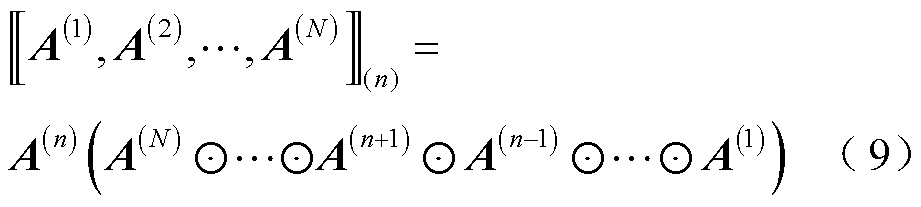
综上所述,本文在构建面向超短期负荷预测的pFedACT框架过程中,需解决以下关键技术问题:
1)如何对模型参数进行张量分解,以提升其对电力负荷时空演化特性的表征能力,减少因频繁数据交互对通信资源的消耗,降低模型训练过程中的通信成本。
2)如何在个性化模型的基础上,训练并解耦张量本地模型,使得个性化模型和张量本地模型能够独立优化,提升全局模型的鲁棒性。
3)如何设计高效的分布式训练策略与张量模型聚合方法,提升模型面对不同客户端异质负荷数据时的泛化能力。
基于上述关键技术问题,本文所提考虑低通信成本的张量分解个性化联邦学习超短期电力负荷预测方法整体框架如图1所示。
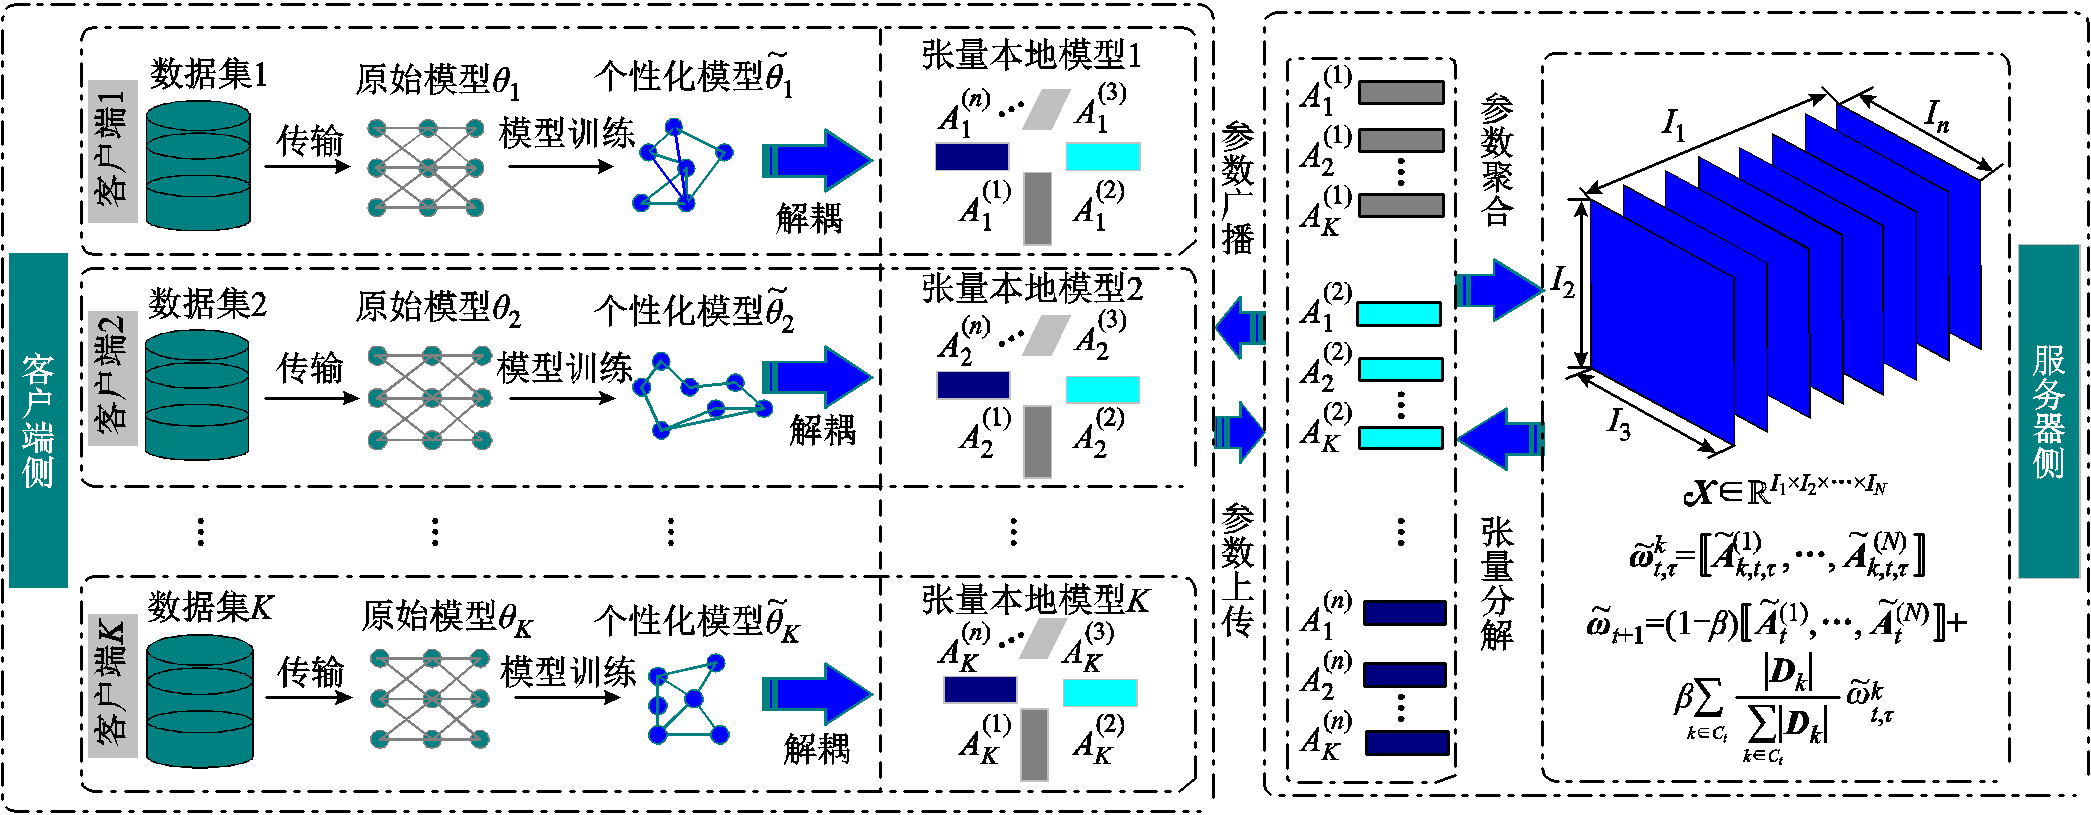
图1 考虑低通信成本的张量分解个性化联邦学习超短期电力负荷预测模型框架图
Fig.1 Overall framework of a low-communication-cost tensor decomposition-based personalized federated learning model for ultra-short-term power load forecasting
为更好地捕捉电力负荷数据中的时空耦合性,本文定义了一个深度神经网络(Deep Neural Network, DNN)用于客户端模型训练。在该模型中,输入特征首先通过第一层全连接层,将其映射到中间特征空间,其计算过程为
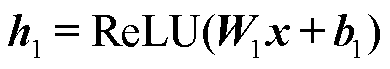 (10)
式中,W1为负荷预测模型的权重矩阵,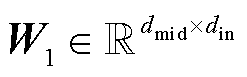 ,
 为模型中间隐藏层的特征维度,
 为负荷预测模型输入特征向量的维度;x为输入负荷序列特征向量;b1为偏置向量,
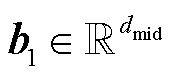 ;ReLU为激活函数,用于引入非线性,增强模型对电力负荷高波动性导致的数据间复杂语义关系的表征能力。
通过第二层全连接层,将中间层的输出 映射到输出层,计算公式为
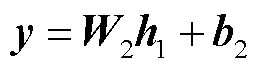 (11)
式中,y为输出预测值;W2为第二层的权重矩阵,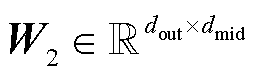 ,
 为模型输出层维度;b2为对应的偏置向量,
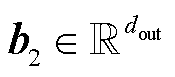 。
为降低服务器与客户端之间的通信成本,并提升超短期负荷预测模型的收敛效率,本文使用张量分解技术在客户端构建张量本地模型。由于模型的每一层权重可以表示为一个矩阵或高维张量,因此本文通过对模型的参数权重进行CP张量分解,以此实现模型压缩与特征提取,提升模型参数时空表达能力。在下述表达式中,小写字母和下标分别表示元素索引和维度。
根据DNN模型定义,分解后的负荷预测模型权重可以进一步表示为多个低秩张量因子的乘积,即
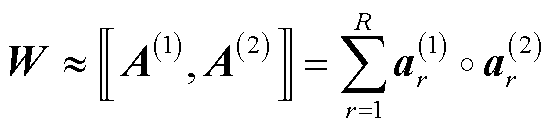 (12)
式中, 、
 分别为因子矩阵的列向量,
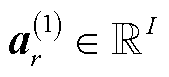 ,
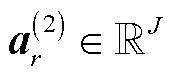 ;
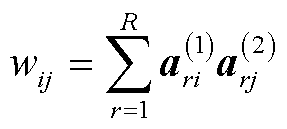 。可以看出,模型参数可被分解为因子矩阵的乘积。因此,张量分解后的全连接层可以表示为
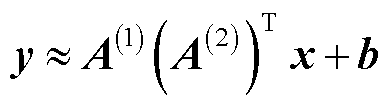 (13)
基于张量分解后的模型参数矩阵,进一步推导模型总体目标函数。本文将负荷预测模型的原始高维权重参数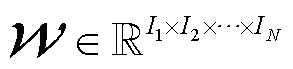 记为一个
 阶张量,将其转换为秩为的CP张量分解形式后,记为
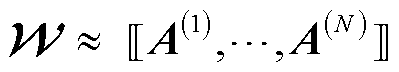 。其中,因子矩阵
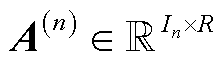 的第r列向量为
 ,,且
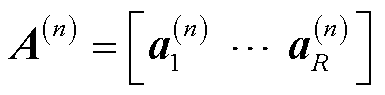 。基于此,pFedACT的总体目标函数定义为
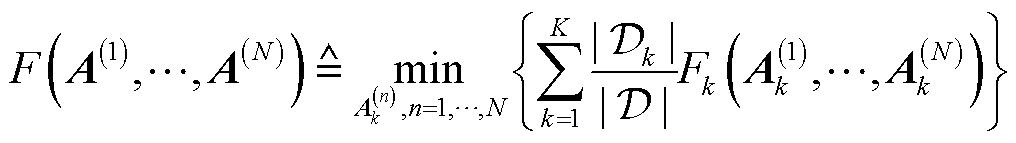 (14)
式中, 为第k个客户端的本地负荷数据集,
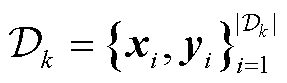 ;
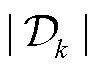 为第k个客户端本地负荷样本的数量;
 为第k个客户端的本地目标函数,定义为
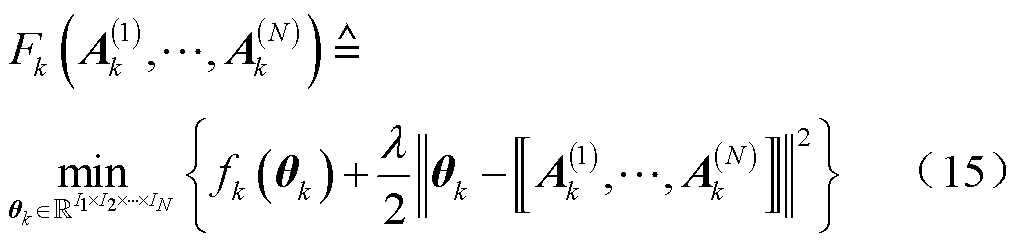
式中, 为第k个客户端的个性化模型;
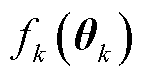 为个性化模型在客户端k的本地负荷数据分布上的预期损失;
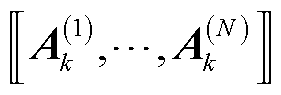 为张量本地模型。
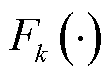 包含了一个
 范数正则化项,用于控制个性化模型和张量本地模型之间的距离;用于控制正则化的程度,有效地对齐全局模型与个性化模型,提升全局负荷预测模型的鲁棒性。
本文所提pFedACT超短期负荷预测模型训练策略流程如图2所示。根据式(15),客户端k针对其本地负荷数据的最优个性化预测模型表示为
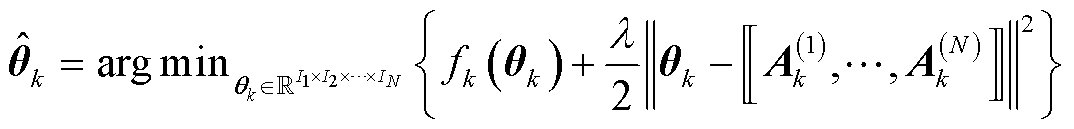 (16)
客户端可以通过最小化本地目标函数交替优化张量本地模型 ,在
 的约束下,其目标函数表示为
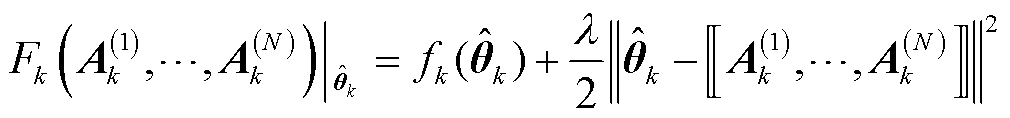 (17)
通过这种方式,全局模型聚合时仅需传输分解后的低维负荷特征因子,以达到降低通信成本的目的。同时保留个性化模型的独立优化能力,提高模型在非独立同分布(Non-Independent and Identically Distributed, Non-IID)负荷数据上的性能。
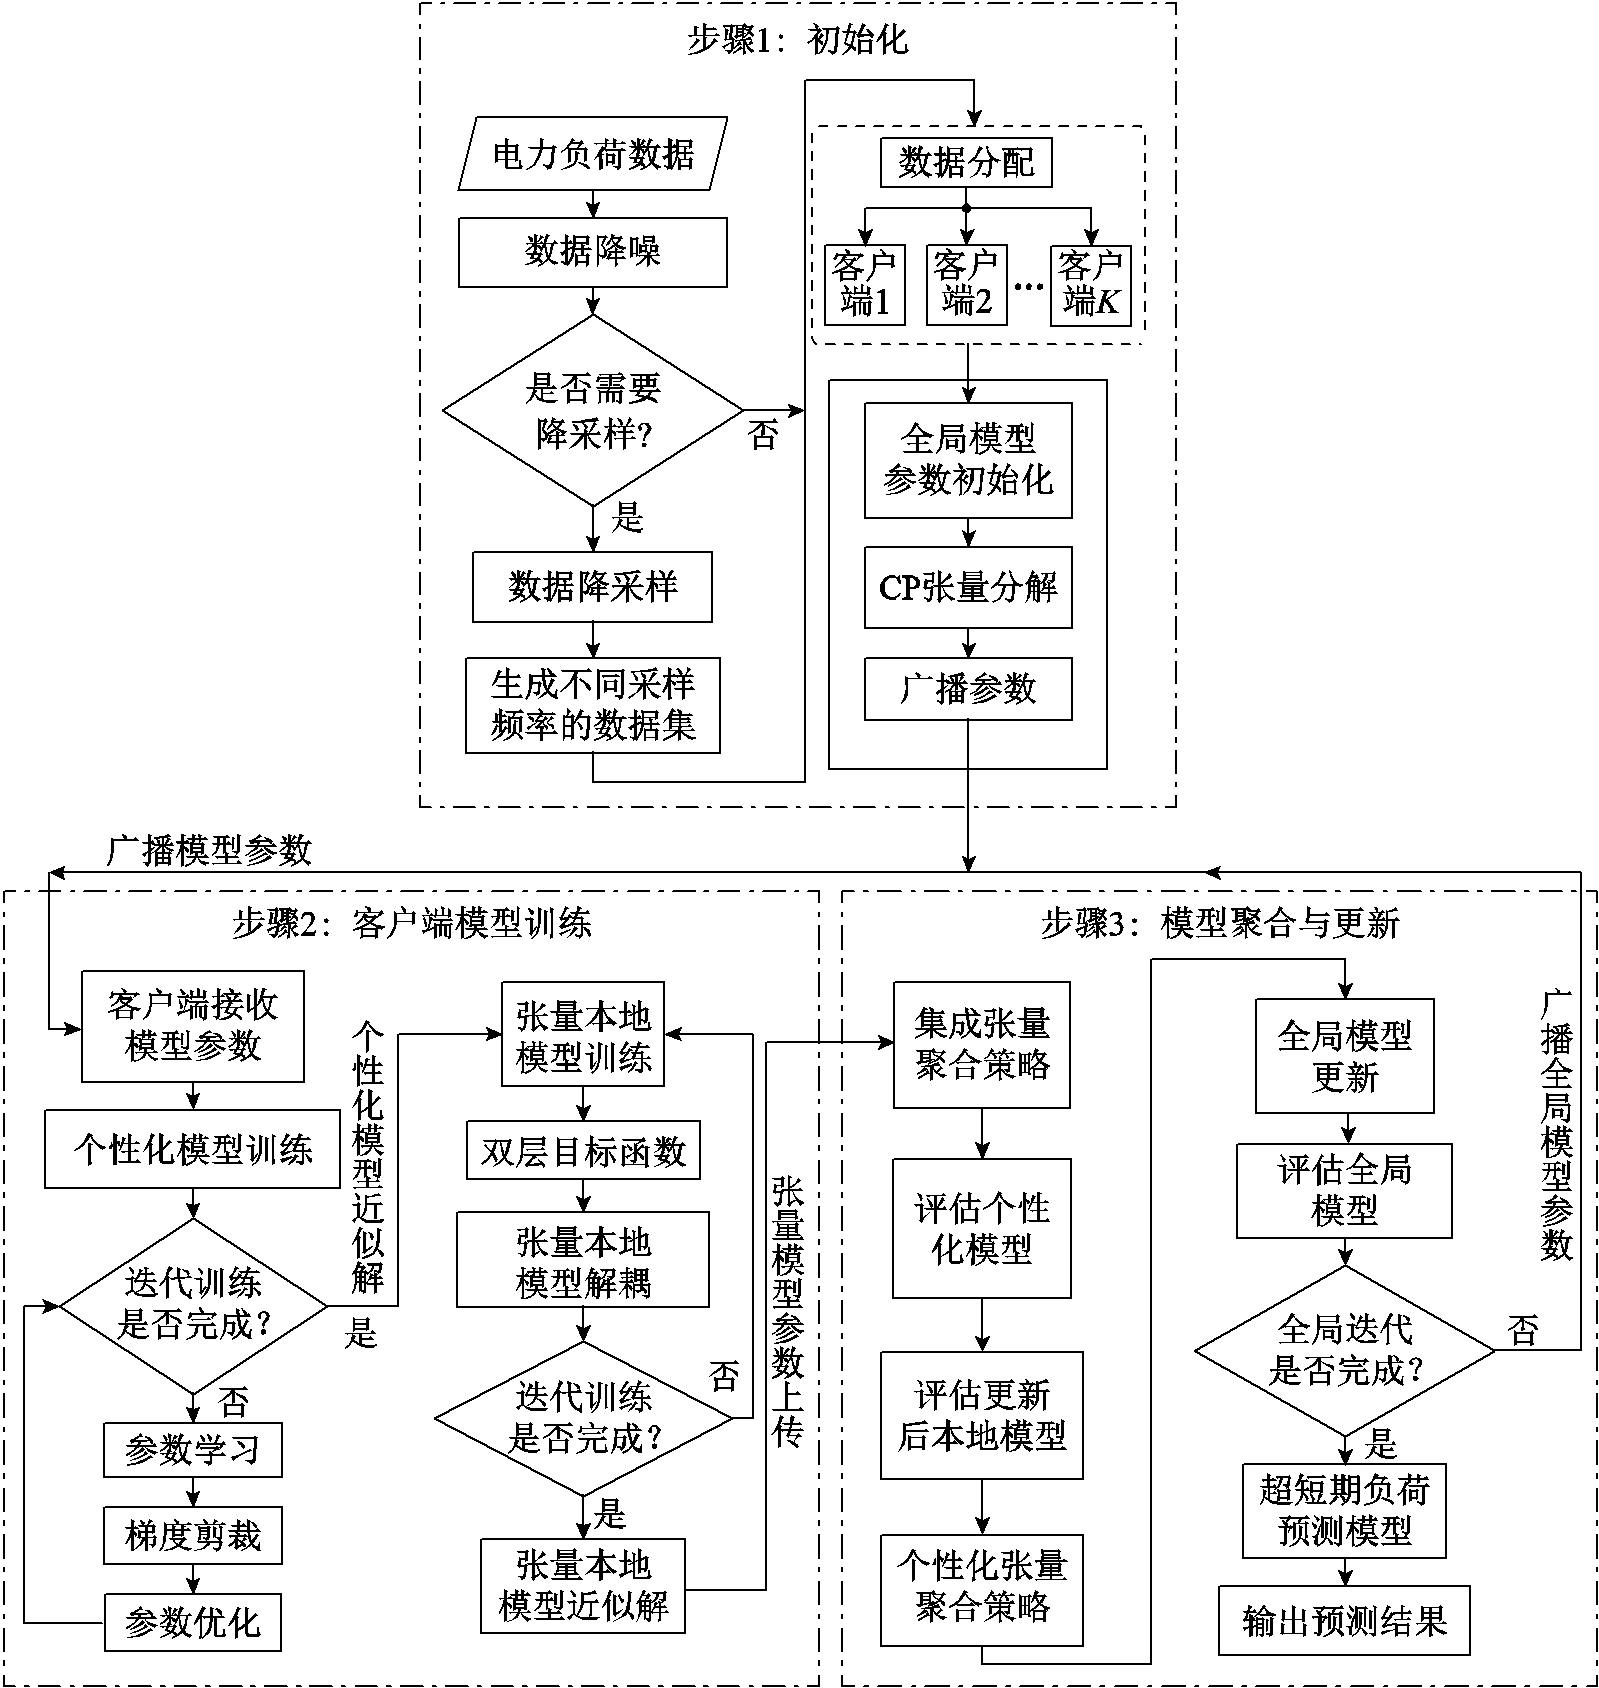
图2 考虑低通信成本的张量分解个性化联邦学习超短期电力负荷预测模型训练流程
Fig.2 Training flow chart of a low-communication-cost tensor decomposition-based personalized federated learning model for ultra-short-term power load forecastings
2.4.1 模型整体训练流程
在客户端,首先将张量本地模型作为参考中心点,通过最小化目标函数训练个性化模型;其次,在获得最优个性化模型的基础上,解耦张量本地模型;然后将张量本地模型的因子矩阵上传服务器;最后服务器聚合因子矩阵后,将聚合后的张量和因子矩阵广播给客户端,分别作为个性化和张量本地模型。这个训练过程持续进行,直到迭代完成。具体训练流程如下:
步骤1:初始化。服务器首先初始化一个全局负荷预测模型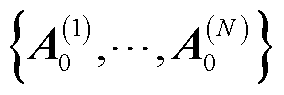 ,并广播给客户端。
步骤2:客户端模型训练。假设总共有 次全局通信轮次。在每次全局通信轮次
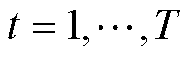 中,客户端基于本地历史负荷数据,执行
 次本地更新轮次,依次训练个性化模型和张量本地模型。在每次本地更新轮次
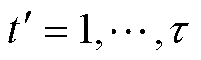 中,客户端k首先以
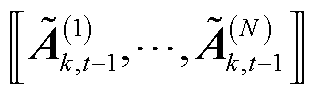 作为参考中心点来训练其个性化负荷预测模型
 ;其次,客户端使用获得的近似解训练张量本地模型
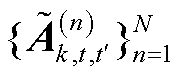 。此阶段重复轮,直至迭代完成。
步骤3:模型聚合与更新。在联邦学习框架下,考虑网络连接的不稳定性(如通信负载或设备电量限制),服务器通常会设定一个固定大小为 的客户端子集
 进行模型聚合。每个被选中的客户端将其更新后的表征局部负荷特征的因子矩阵
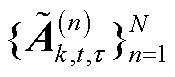 ,
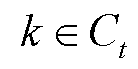 发送给服务器。在服务器端,使用集成张量聚合机制来更新全局模型,并将更新后的全局模型广播给客户端。
2.4.2 个性化模型训练
在每次本地迭代中,从客户端本地负荷数据集中随机抽取一个小批量样本 ,将模型在该批次负荷数据上预测损失的梯度
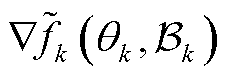 作为整个本地负荷数据集梯度
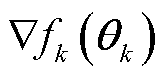 。小批量样本定义的目标函数为
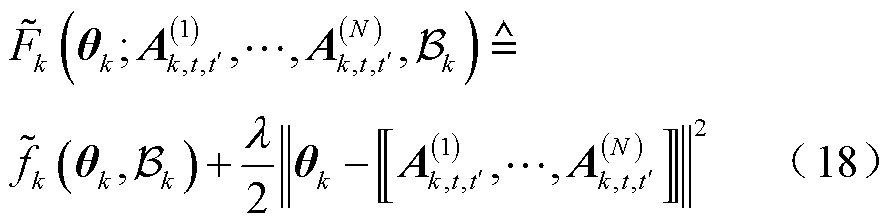
假设选择正则化参数使得 是强凸的,并且具有条件数
 (该条件数量化了优化式(18)的难度),可以使用梯度下降,以获得个性化模型
 。经过S次计算,使得
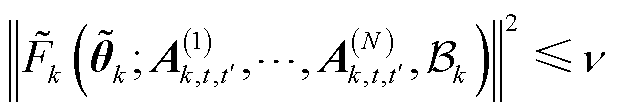 (19)
式中,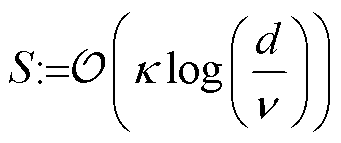 [21],d为模型参数空间的直径,
 为期望的精度;为个性化模型的近似解。
2.4.3 张量本地模型训练
在获得最优个性化负荷预测模型的近似解后,对式(15)的参数因子矩阵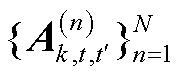 进行梯度求导,以优化表征本地用电特征的张量本地模型
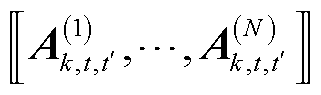 ,可得到局部目标函数对于
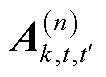 的偏导数
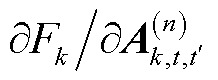 。然后,应用梯度下降法优化因子矩阵。受交替最小二乘法的启发,本文交替优化每个因子矩阵。为了方便,后续公式中省略了
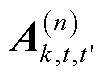 的下标,客户端k的因子矩阵
 的梯度
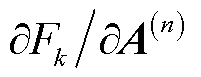 可以表示为
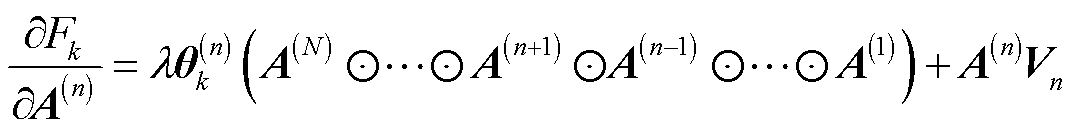 (20)
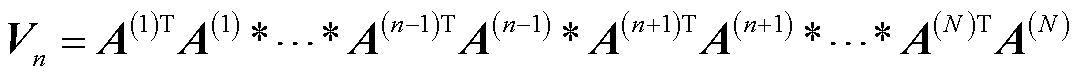 (21)
以梯度下降算法为例,因子矩阵的更新公式为
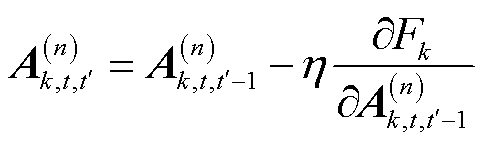 (22)
式中, 为张量本地模型的学习率。由于在基于梯度的张量训练过程中需要多次迭代,在第
 次本地更新轮次中,进行
 次计算来获得近似解。
2.4.4 集成张量聚合机制
根据张量本地模型特性,设计了集成张量聚合机制,用于在服务器端高效地融合来自各客户端的局部负荷特征,更新全局预测模型。在此聚合机制中,服务器将客户端的因子矩阵重构成一个完整的张量参数,有
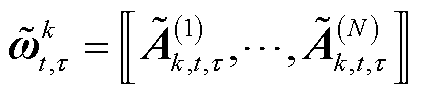 (23)
服务器计算张量 的平均值,通过
 控制全局模型聚合方向,即
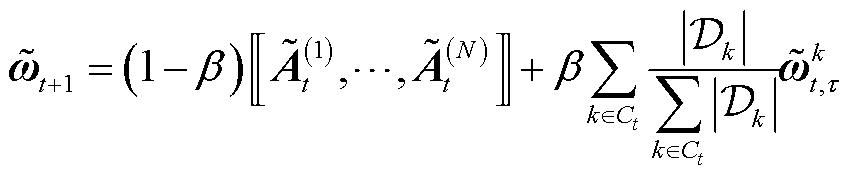 (24)
聚合后的全局模型可以表示为 和
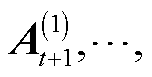
 ,分别为完整模型参数和张量化模型参数,即
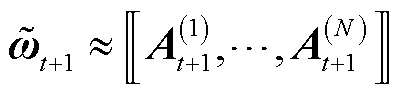 (25)
该机制有效地融合了不同客户端的负荷特征模式,在降低通信成本的同时提升了对全局电力负荷变化规律的表达能力。基于pFedACT的超短期负荷预测算法伪代码详见附表1。
2.4.5 收敛性分析
在联邦学习领域,梯度计算与收敛性分析通常基于若干经典假设[22-23]。基于此,本文在本节中深入分析了pFedACT在超短期负荷预测任务非凸情境下的算法收敛性表现,为所提方法的收敛特性提供坚实的理论支撑。
假设1:平滑性。假定每个客户端的本地负荷预测损失函数 是非凸的,并且具有L-平滑性,即有L-Lipschitz梯度,对于任意的
 和
 ,不等式(26)成立。
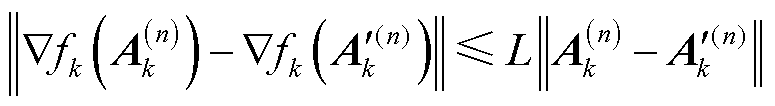 (26)
式中, 为与相关的平滑参数。
假设2:梯度方差有界。每个客户端基于小批量负荷数据估计的随机梯度方差有上界,即随机梯度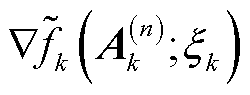 与确定性梯度
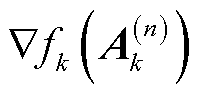 的平方差的期望值被
 上界限制,有
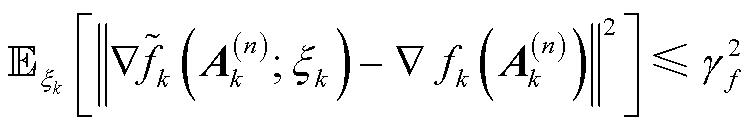 (27)
假设3:梯度差异有界。各客户端本地负荷数据分布差异导致的梯度偏差受到约束。对于所有客户端k,局部梯度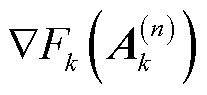 与全局梯度
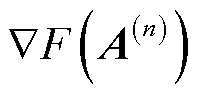 之间的平方差之和,乘以客户端k的数据占总数据集的比例
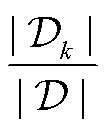 ,小于或等于
 ,即
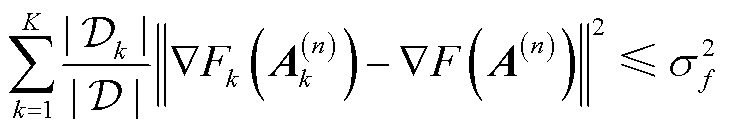 (28)
假设4:方差约束。对于每个客户端k,在任意一次迭代中,梯度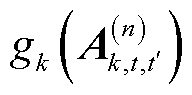 与局部目标函数在处梯度差的二次方的期望受到
 的约束,有
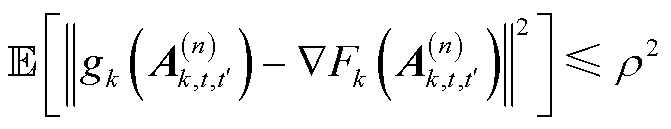 (29)
式中,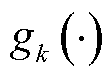 为当个性化模型为时,客户端局部目标函数关于参数因子的梯度。
假设1是收敛性分析中的一个标准假设,假设2和假设3在联邦学习领域内被普遍采用。其中,和分别表征负荷数据采样噪声和不同客户端用电模式分布差异[24]。假设4与文献[25]中的假设相似。
引理1: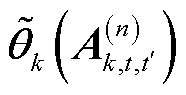 是式(19)定义的客户端个性化负荷预测模型解,可得
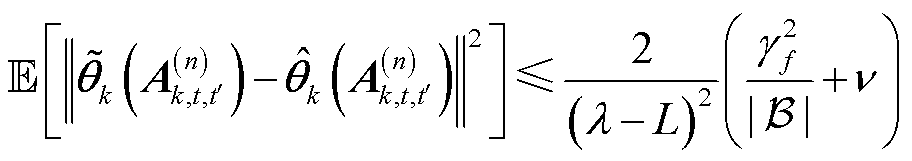 (30)
式中, 为随机抽取的小批量样本包含的样本数。
引理2:在假设1成立的情况下,可得
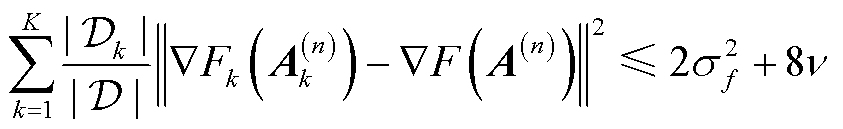 (31)
本引理为的有界多样性提供了一个上限,这与假设3中对的约束有关。
引理3:客户端采样的的有界多样性受到式(32)约束。
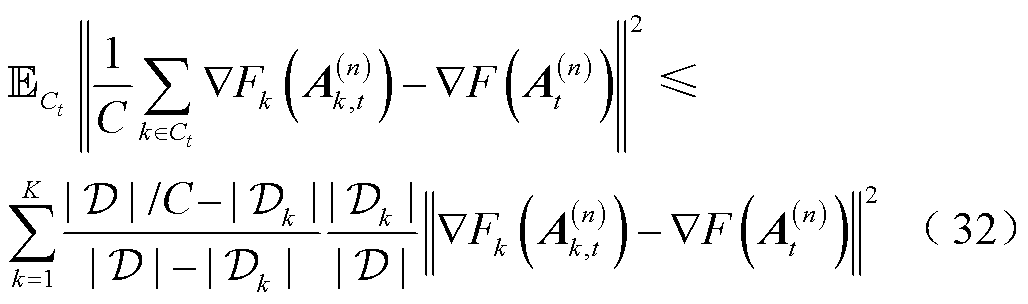
引理4:客户端漂移导致的错误是有界的,即
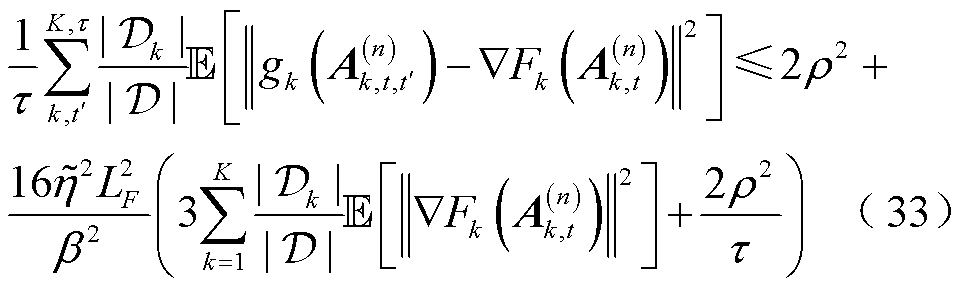
式中,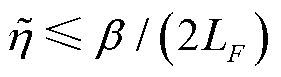 ;
 为的平滑参数。
基于上述引理,可得出以下关于pFedACT的收敛性定理。
定理1:非凸且平滑的pFedACT收敛性。上述假设1~假设4成立,如果,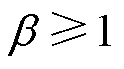 ,则
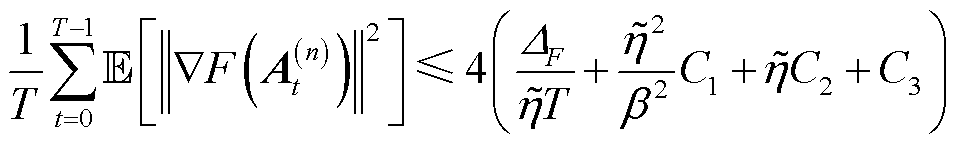 (34)
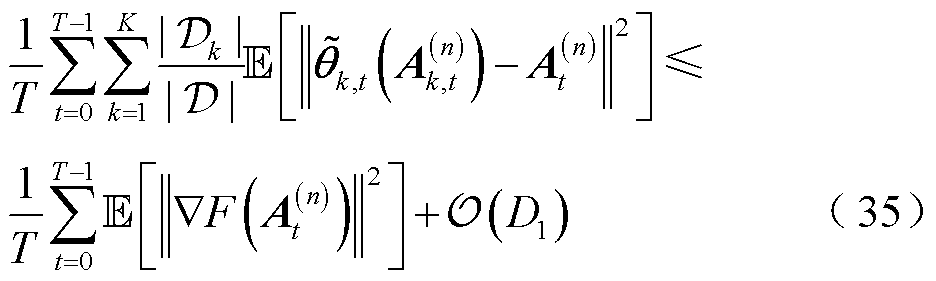
式中, 为初始误差,其以
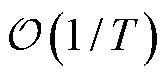 速率线性衰减,
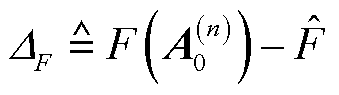 ,
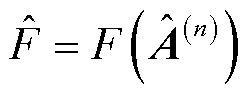 ;
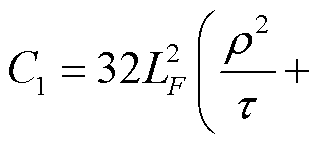
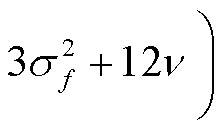 ;
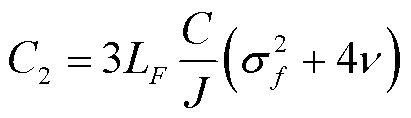 ;
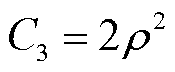 ;
 为函数的强凸性参数;
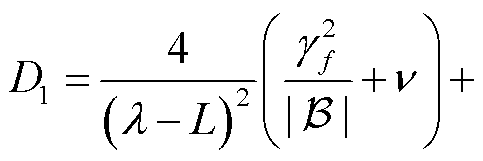
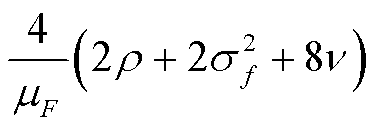 。式(34)阐述了全局模型的收敛结果。式(35)描述了在非凸场景中,客户端个性化模型收敛到以个性化模型为中心的球体
 内部,并且具有半径
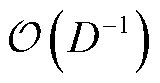 。
1)实验平台:本实验所有程序均使用Python编写,并在配备英特尔5220R CPU(2.20 GHz)处理器和24 GB英伟达A10 GPU的计算机上运行。
2)数据集与客户端设置:为全面评估所提方法的性能,本实验使用了来自新英格兰独立系统运营商(ISO-NewEngland)提供的2017年1月—2018年12月的电力负荷数据。该数据集除时间标签外,仅包含区域“总负荷需求”特征。为提升数据质量,对其进行了降噪处理,包括对缺失值采用局部线性插值法填充以及去除重复数据,并将降噪后的数据集记为原始数据集(Raw Dataset, RD),其采样频率为5 min。通过对RD进行降采样,另外构建了三个不同时间细粒度的数据集:1 h级数据集(Hourly Dataset, HD)、30 min级数据集(Semi-Hourly Dataset, SHD)以及15 min级数据集(Quarter-Hourly Dataset, QD)。在建模过程中,分别基于不同采样频率下的历史10个时间步的负荷数据,预测未来5、15、30、60 min的负荷需求。
RD、QD、SHD、HD中的客户端数均为20。此外,本文还设置了包含50、80和100个客户端的多组对比实验,根据分布式建模需求,使用RD,每个客户端划分1 500条数据。其中,1 200条为训练集,300条为测试集。实验数据示例见表1。在后续算例分析中,如未标注实验组的客户端数量,则默认采用20个客户端的实验组设置。
表1 实验数据示例
Tab.1 Examples of experimental data
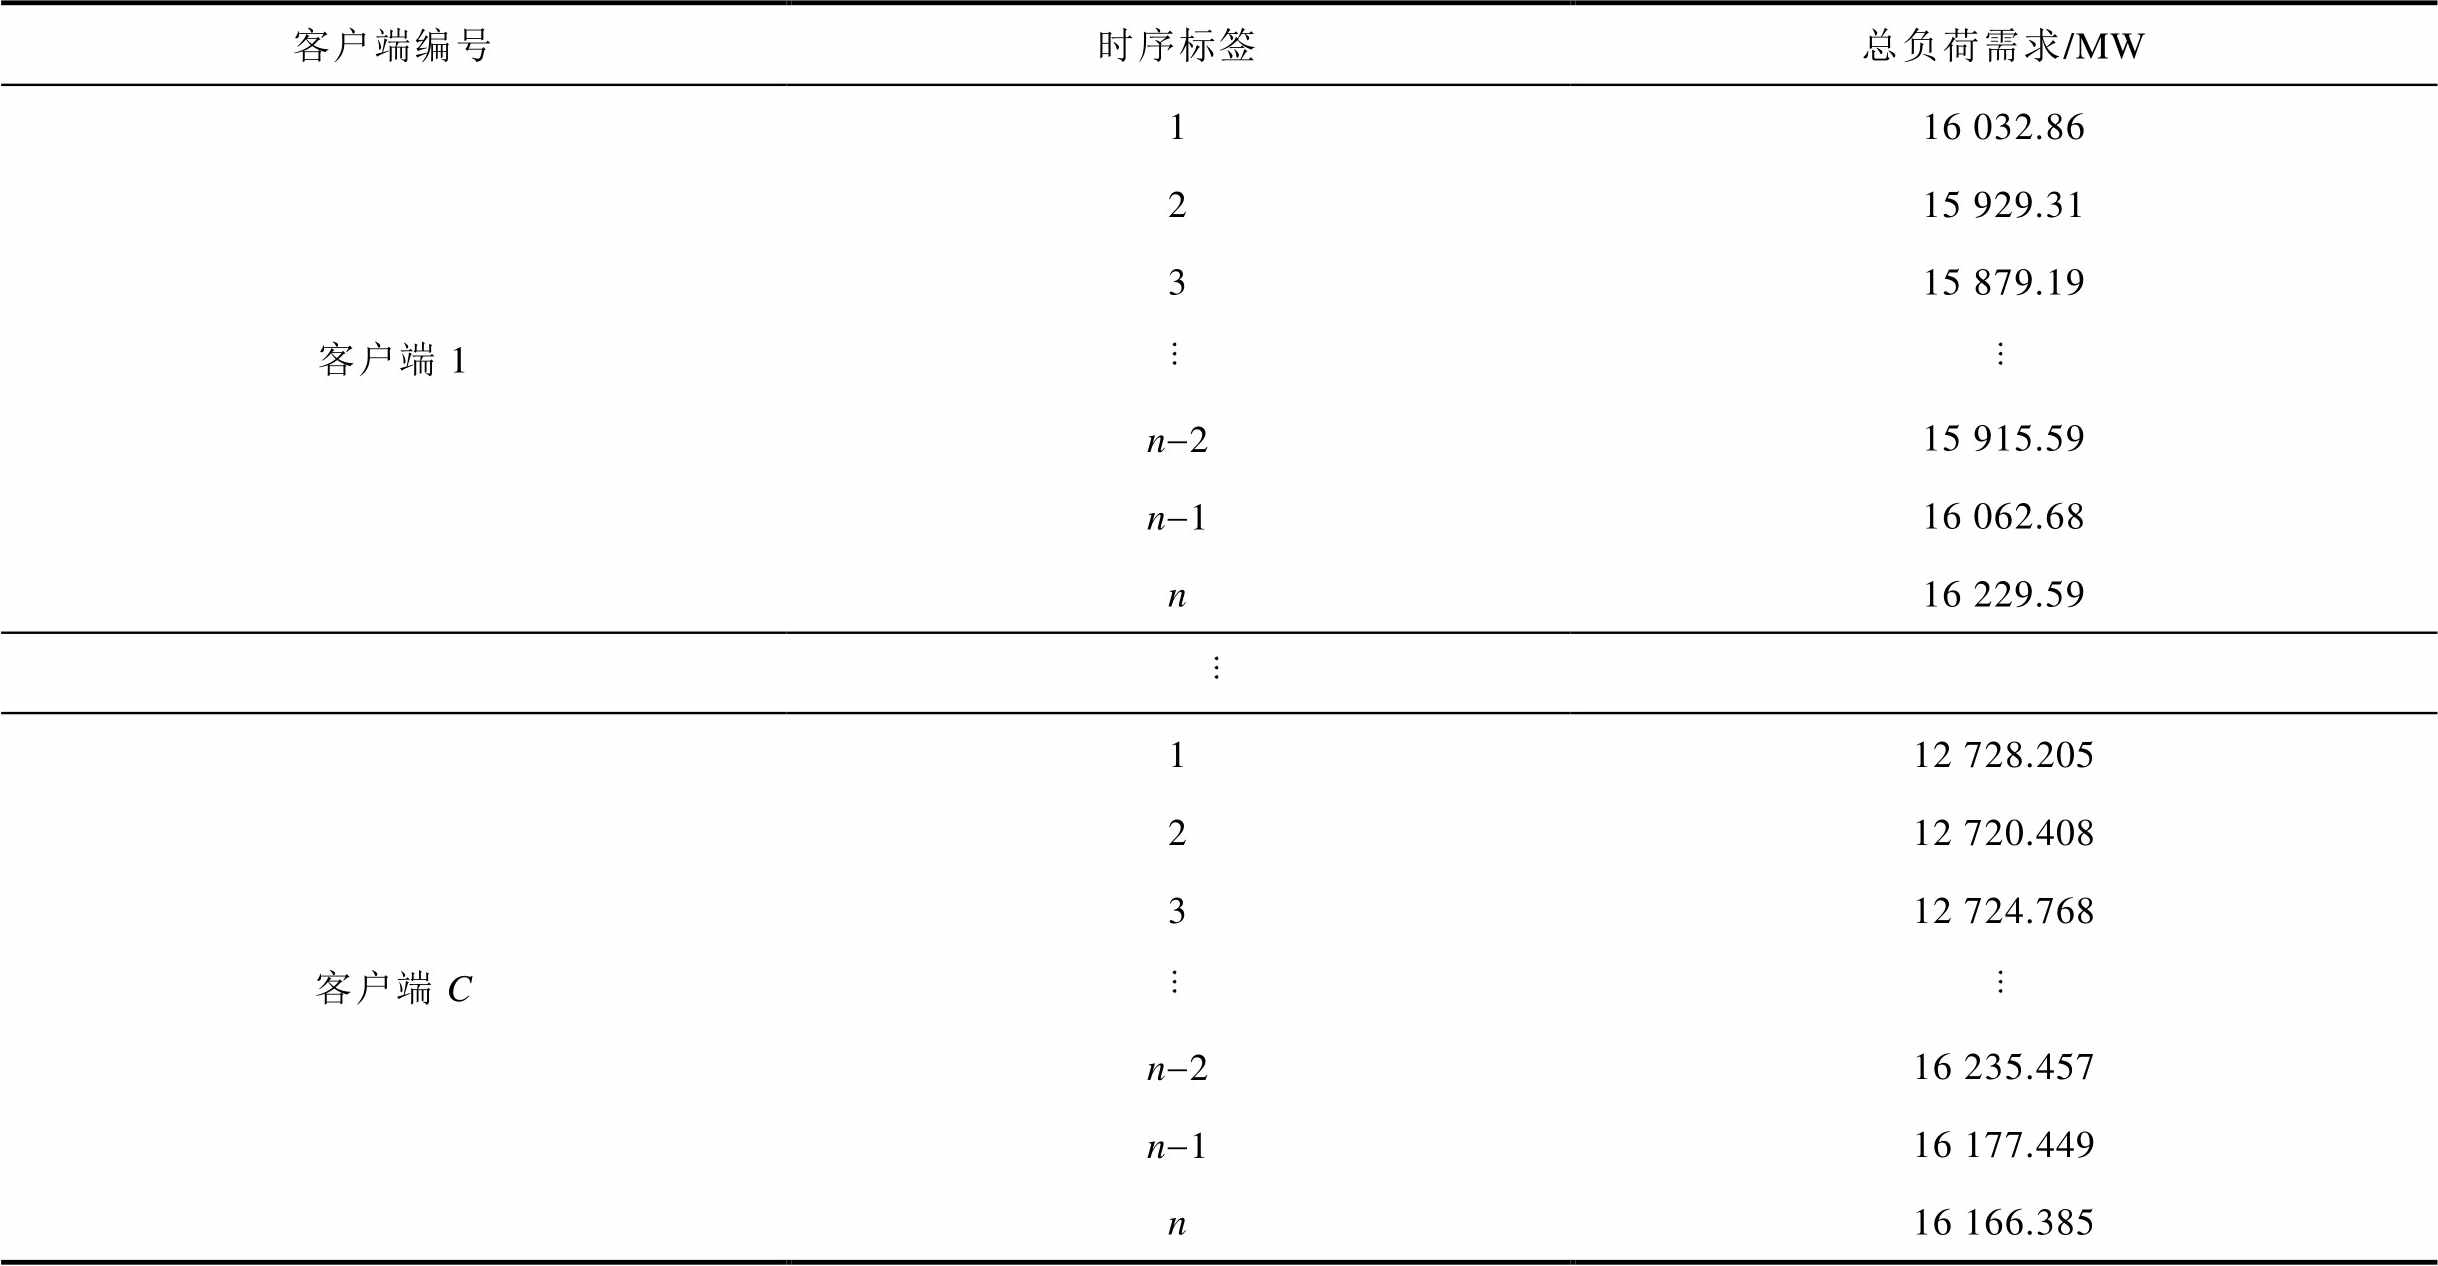
客户端编号时序标签总负荷需求/MW 客户端1116 032.86 215 929.31 315 879.19 n-215 915.59 n-116 062.68 n16 229.59 客户端C112 728.205 212 720.408 312 724.768 n-216 235.457 n-116 177.449 n16 166.385
为验证各客户端数据是否具备真实场景中的Non-IID特性,采用柯尔莫戈洛夫-斯米尔诺夫(Kolmogorov-Smirnov, K-S)检验方法评估不同规模实验组内各客户端间的数据分布特性。数据分布显著性检验如图3所示。在各实验组中,绝大多数客户端之间的数据分布p值均低于预设的显著性水平阈值(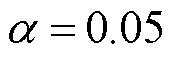 ),仅在80和100个客户端的实验分组中存在极少数p值高于显著性水平阈值的情况。这表明各个分组内客户端间的数据呈现典型的Non-IID特征,能够合理模拟实际电力系统中多区域、多用户间的负荷特性差异。
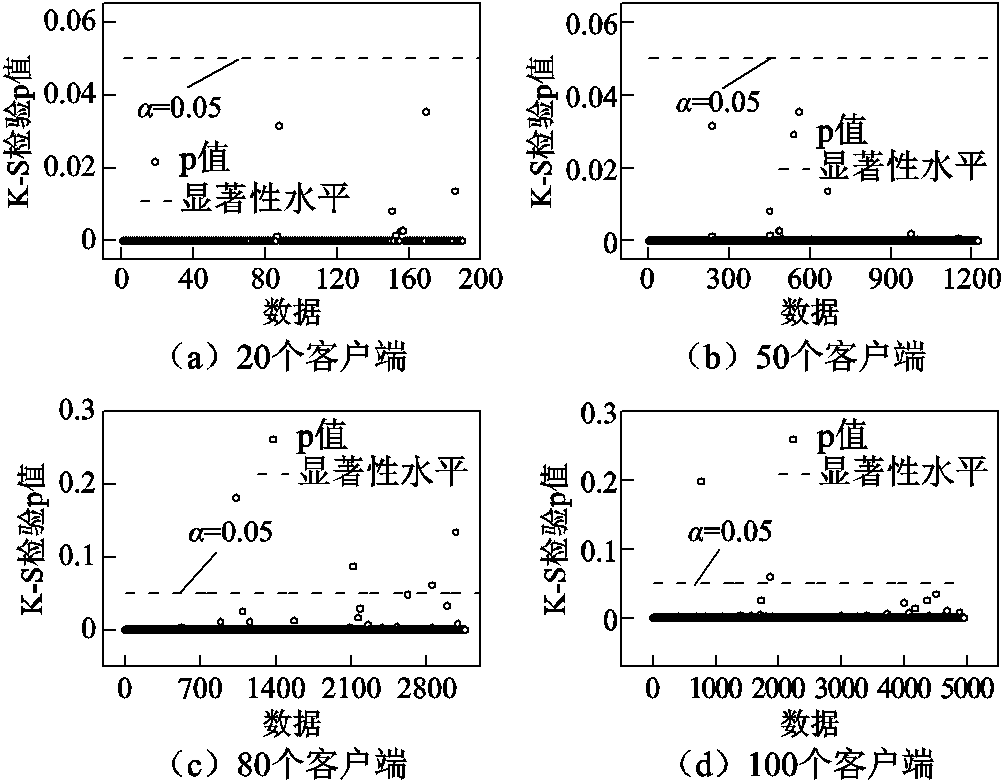
图3 数据分布显著性检验
Fig.3 Statistical significance test of data distribution
3)模型设置:为全方位评估模型性能,本文将所提方法分别与集中式建模方法及联邦学习方法进行了对比。在集中式建模方法下,假设不存在数据跨域传输带来的数据安全问题,运用四个基准模型,即变换器模型(Transformer, TRA)、Transformer与双向门控循环单元(BiGRU)的组合模型(BiGRU-TRA)、Transformer与双向长短期记忆网络(BiLSTM)的组合模型(BiLSTM-TRA)及pFedACT框架中使用的DNN。在联邦学习场景中,分别与pFedMe、FedAvg基准框架进行对比。
4)评估指标:为全面评估模型性能,采用了五项评估指标:平均绝对误差(Mean Absolute Error, MAE)、平均绝对百分比误差(Mean Absolute Percentage Error, MAPE)、方均根误差(Root Mean Square Error, RMSE)、最大绝对误差(Maximum Absolute Error, MAXAE)以及决定系数(Coefficient of Determination,  )。MAE用于量化预测值与实际值之间的平均偏差。MAPE则将该偏差表示为实际值的百分比形式。RMSE对较大的误差值敏感,通过测算预测误差的方均根来反映模型的稳定性。MAXAE可反映模型的极端误差值及鲁棒性。用于评估模型对实际负荷曲线的拟合程度,其值越接近1,表明预测能力越强。评估指标的详细说明可参考文献[26-27]。
本文首先进行了模型超参数寻优实验。通过设定合理的初始搜索空间,采用多轮网格搜索优化。在整个优化过程中,以验证集平均准确率作为核心评估指标,同时兼顾模型预测性能的稳定性。最终基于预测精度与鲁棒性双重考量择优选定模型超参数,见表2。全局模型训练800轮,聚合系数 为1.2,正则化项系数
 与数据批大小
 均设为5,本地张量模型学习率
 与个性化模型学习率
 均设为0.01,个性化模型迭代次数S取为5,张量本地模型迭代次数
 设为15,张量分解的秩为3。
表2 模型超参数设置
Tab.2 Model hyperparameter setting
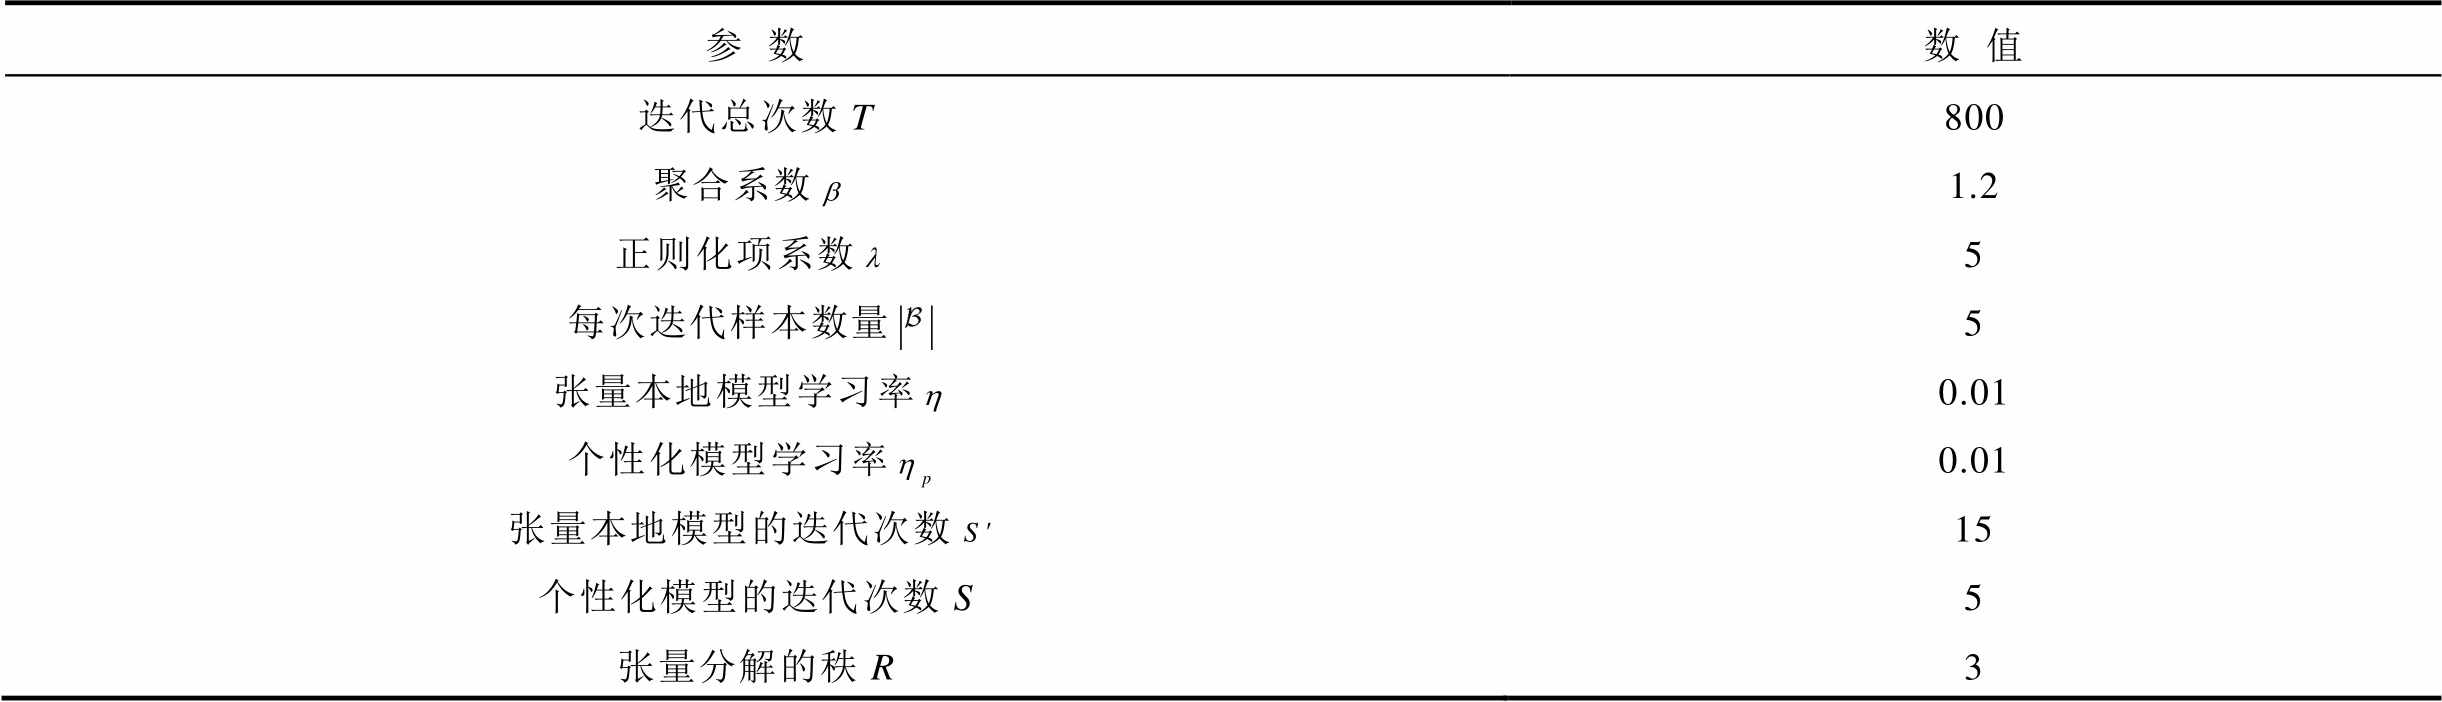
参数数值 迭代总次数T800 聚合系数1.2 正则化项系数5 每次迭代样本数量5 张量本地模型学习率0.01 个性化模型学习率0.01 张量本地模型的迭代次数15 个性化模型的迭代次数S5 张量分解的秩R3
针对pFedACT模型的关键特色参数、、S、 、和R,图4进一步可视化了参数优化过程中MAE的变化趋势。当
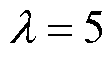 时,模型性能达到最优,此时能有效地平衡张量本地模型与个性化模型之间的距离约束强度与梯度更新强度。过大的值会抑制模型捕捉客户端特有数据分布模式的能力。值过高会因过度拟合特定用户数据而降低泛化能力,
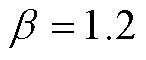 可在模型个性化与泛化能力间取得理想平衡。个性化模型迭代次数S越大精度越高,但由式(18)可知,张量本地模型的解耦效果受与个性化模型训练结果的共同影响,在不变的前提下,若张量本地模型与个性化模型的欧氏距离过大将破坏训练稳定性,故设S=5。当
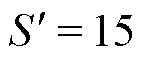 时,模型精度达到最佳,并可在精度与通信成本之间实现平衡。尽管=0.03在局部收敛时能达到更低的误差极值,但综合训练全过程中,=0.01能提供更稳定的训练过程和更优的泛化性能。基于训练过程鲁棒性与最终模型性能的综合考量,本研究将设为0.01。R是平衡模型轻量化程度与上下文表征能力的关键因素。当R取值过小时(R<3),模型参数被过度压缩,导致其在表征负荷数据的时空变化特征方面能力受限,进而引发预测性能的退化。相较之下,当R=3时,模型经CP分解后在保留关键信息的同时,有效去除冗余成分,从而增强了模型对复杂负荷特性的刻画能力,提升了整体预测性能。
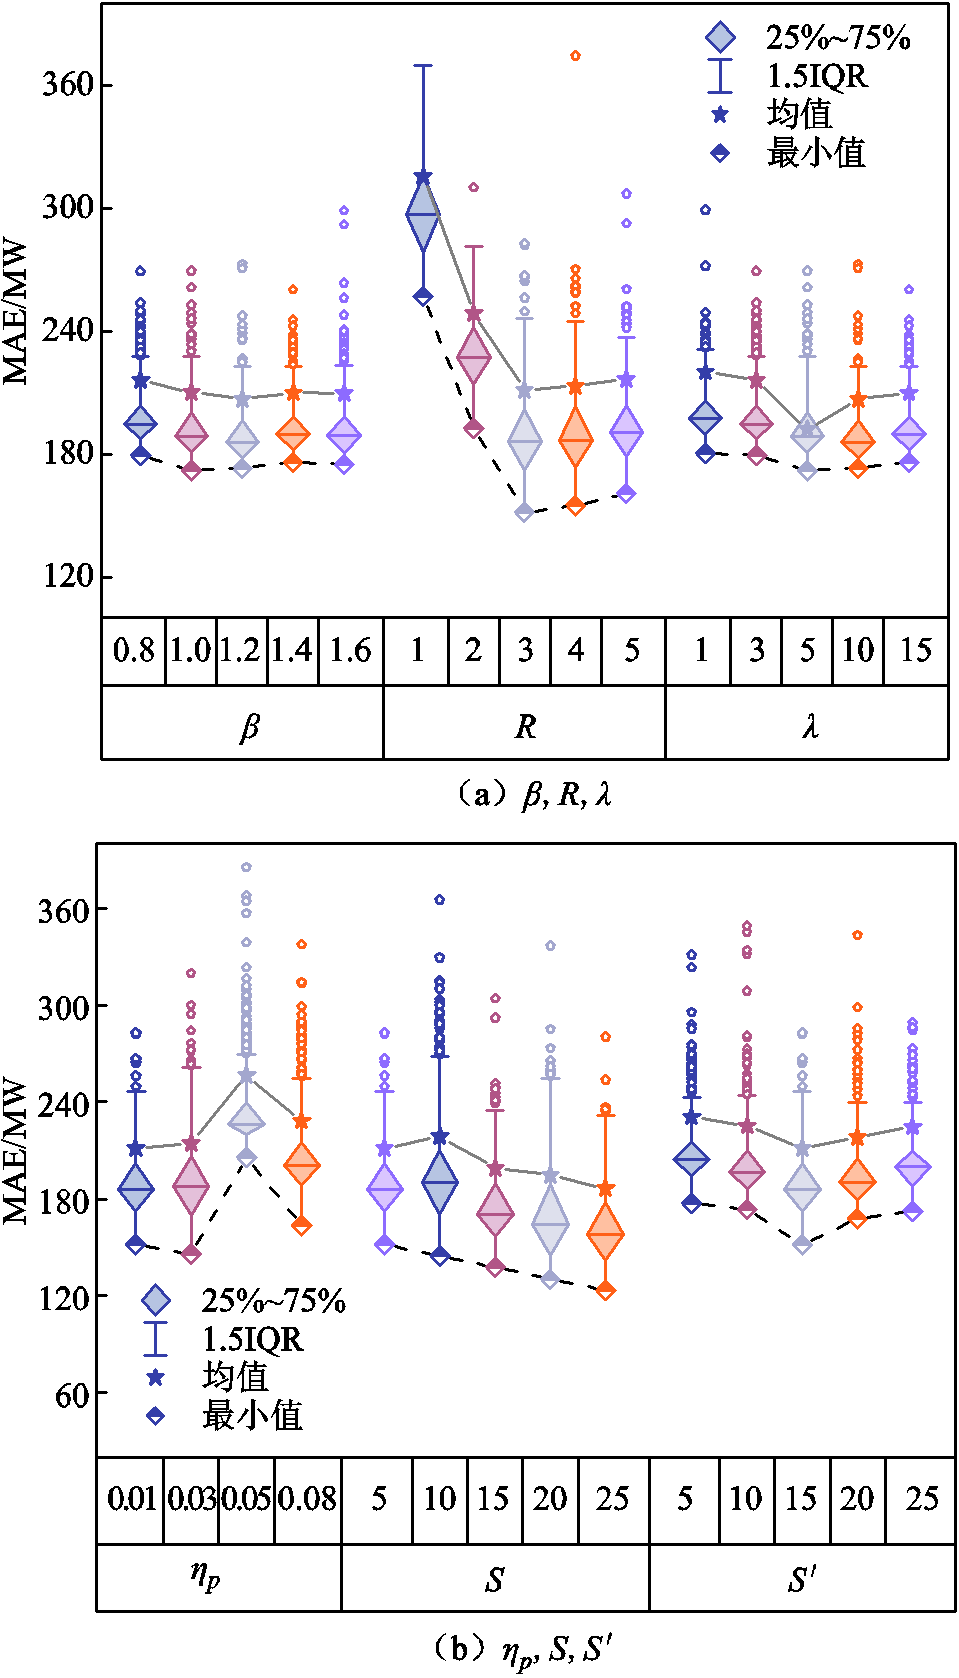
图4 超参数优化实验
Fig.4 Hyperparameter optimization experiment diagram
为系统性评估模型综合性能,本文设计了多维度对比实验。首先,将pFedACT与当前电力负荷预测领域表现优异的联邦学习方法进行对比,以检验其捕捉电力负荷数据时空变异性的能力;其次,分析pFedACT与集中式建模方法的预测效果,评估其在保障数据隐私前提下的学习性能;再次,通过数据不平衡、时间多粒度、负荷多类型与场景多样性四个维度验证模型的鲁棒性;接着,从收敛稳定性和收敛效率两方面进行算法的收敛性分析;然后,通过对比全局模型与个性化模型在面对不同客户端异质数据时的性能差异,检验pFedACT的泛化能力;随后,通过对比不同基础模型集中式建模表现与其在pFedACT中的性能差异,检验所提方法在分布式建模中的有效性;进一步,通过设置不同规模的客户端分组实验,验证模型在多样化电力系统场景下的可行性;最后,进行模型通信成本分析,量化pFedACT在通信成本方面的优势。
3.3.1 与分布式建模方案对比
图5展示了各模型在RD上的性能表现。图中越靠近右下角,误差指标值越小,表示模型的性能越优异。从图5中可以看出,pFedACT在所有评估指标上均表现出色,尤其在提升预测准确性和减少极端误差方面,展现了显著的优势。

图5 RD上模型性能对比
Fig.5 Model performance comparison diagram on RD
图6直观地展示了各模型在RD上的预测值与实际值之间的差异。pFedACT预测负荷曲线与实际负荷曲线最为吻合,最好地捕捉了电力负荷的时空变异性;其次是FedAvg,也较好地解释了电力负荷的变化规律;而pFedMe稍显不足,部分区间预测负荷曲线与实际负荷曲线存在较大偏差。
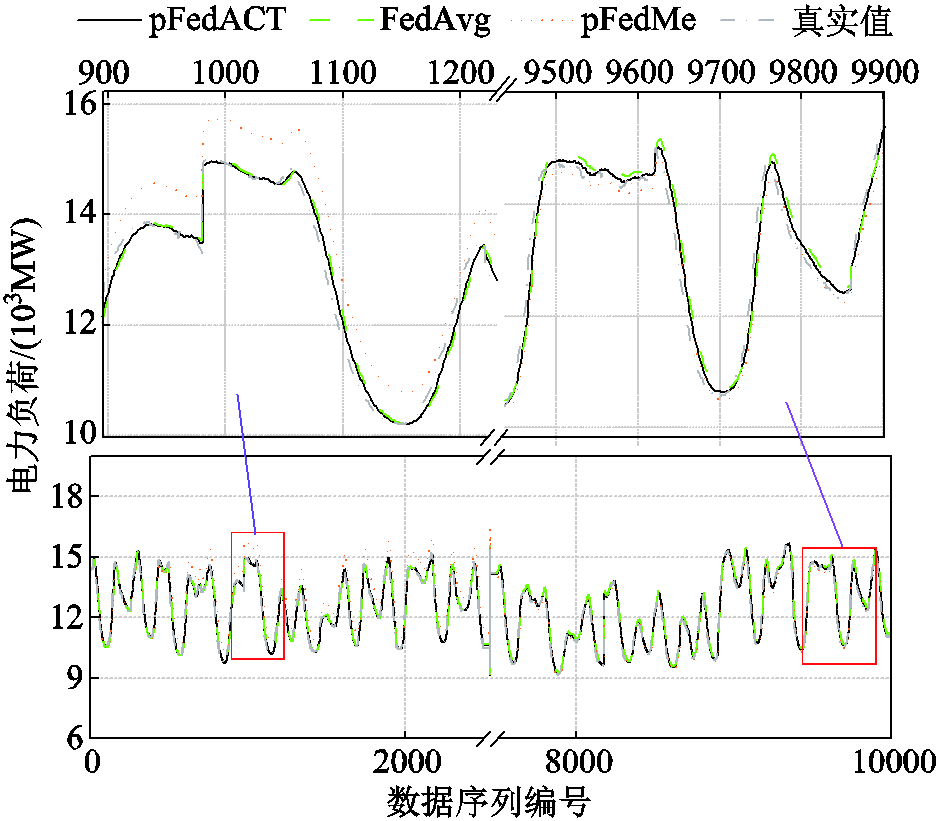
图6 RD数据集上各模型预测曲线拟合效果图
Fig.6 The fitting effect diagram of the prediction curves of each model on the RD
表3展示了各模型在不同数据集上的具体性能表现。为便于直观比较,表3中对每个数据集上各指标的最优值进行了加粗处理。可以看出,pFedACT在各个数据集上的性能指标全面优于pFedMe和FedAvg,尤其在最大绝对误差控制和拟合能力方面表现突出。在反映预测精度的MAE、MAPE和RMSE指标上,pFedACT 在每个数据集上都取得了最优值,且MAE较次优模型降低20.83%及以上,显著提升了预测精度。在MAXAE方面,pFedACT始终保持最小值,其相对于次优模型的MAXAE降低了24.10%及以上,凸显了其在处理异常值和极端值时的稳健性,确保模型能够有效捕捉电力负荷需求的突变,这对于电力系统稳定运行至关重要。最后,pFedACT的决定系数 均超过0.96,特别是在RD、QD和SHD上均达到0.98及以上。
表3 不同数据集上模型性能指标评估
Tab.3 Evaluation of model performance indicators on different datasets
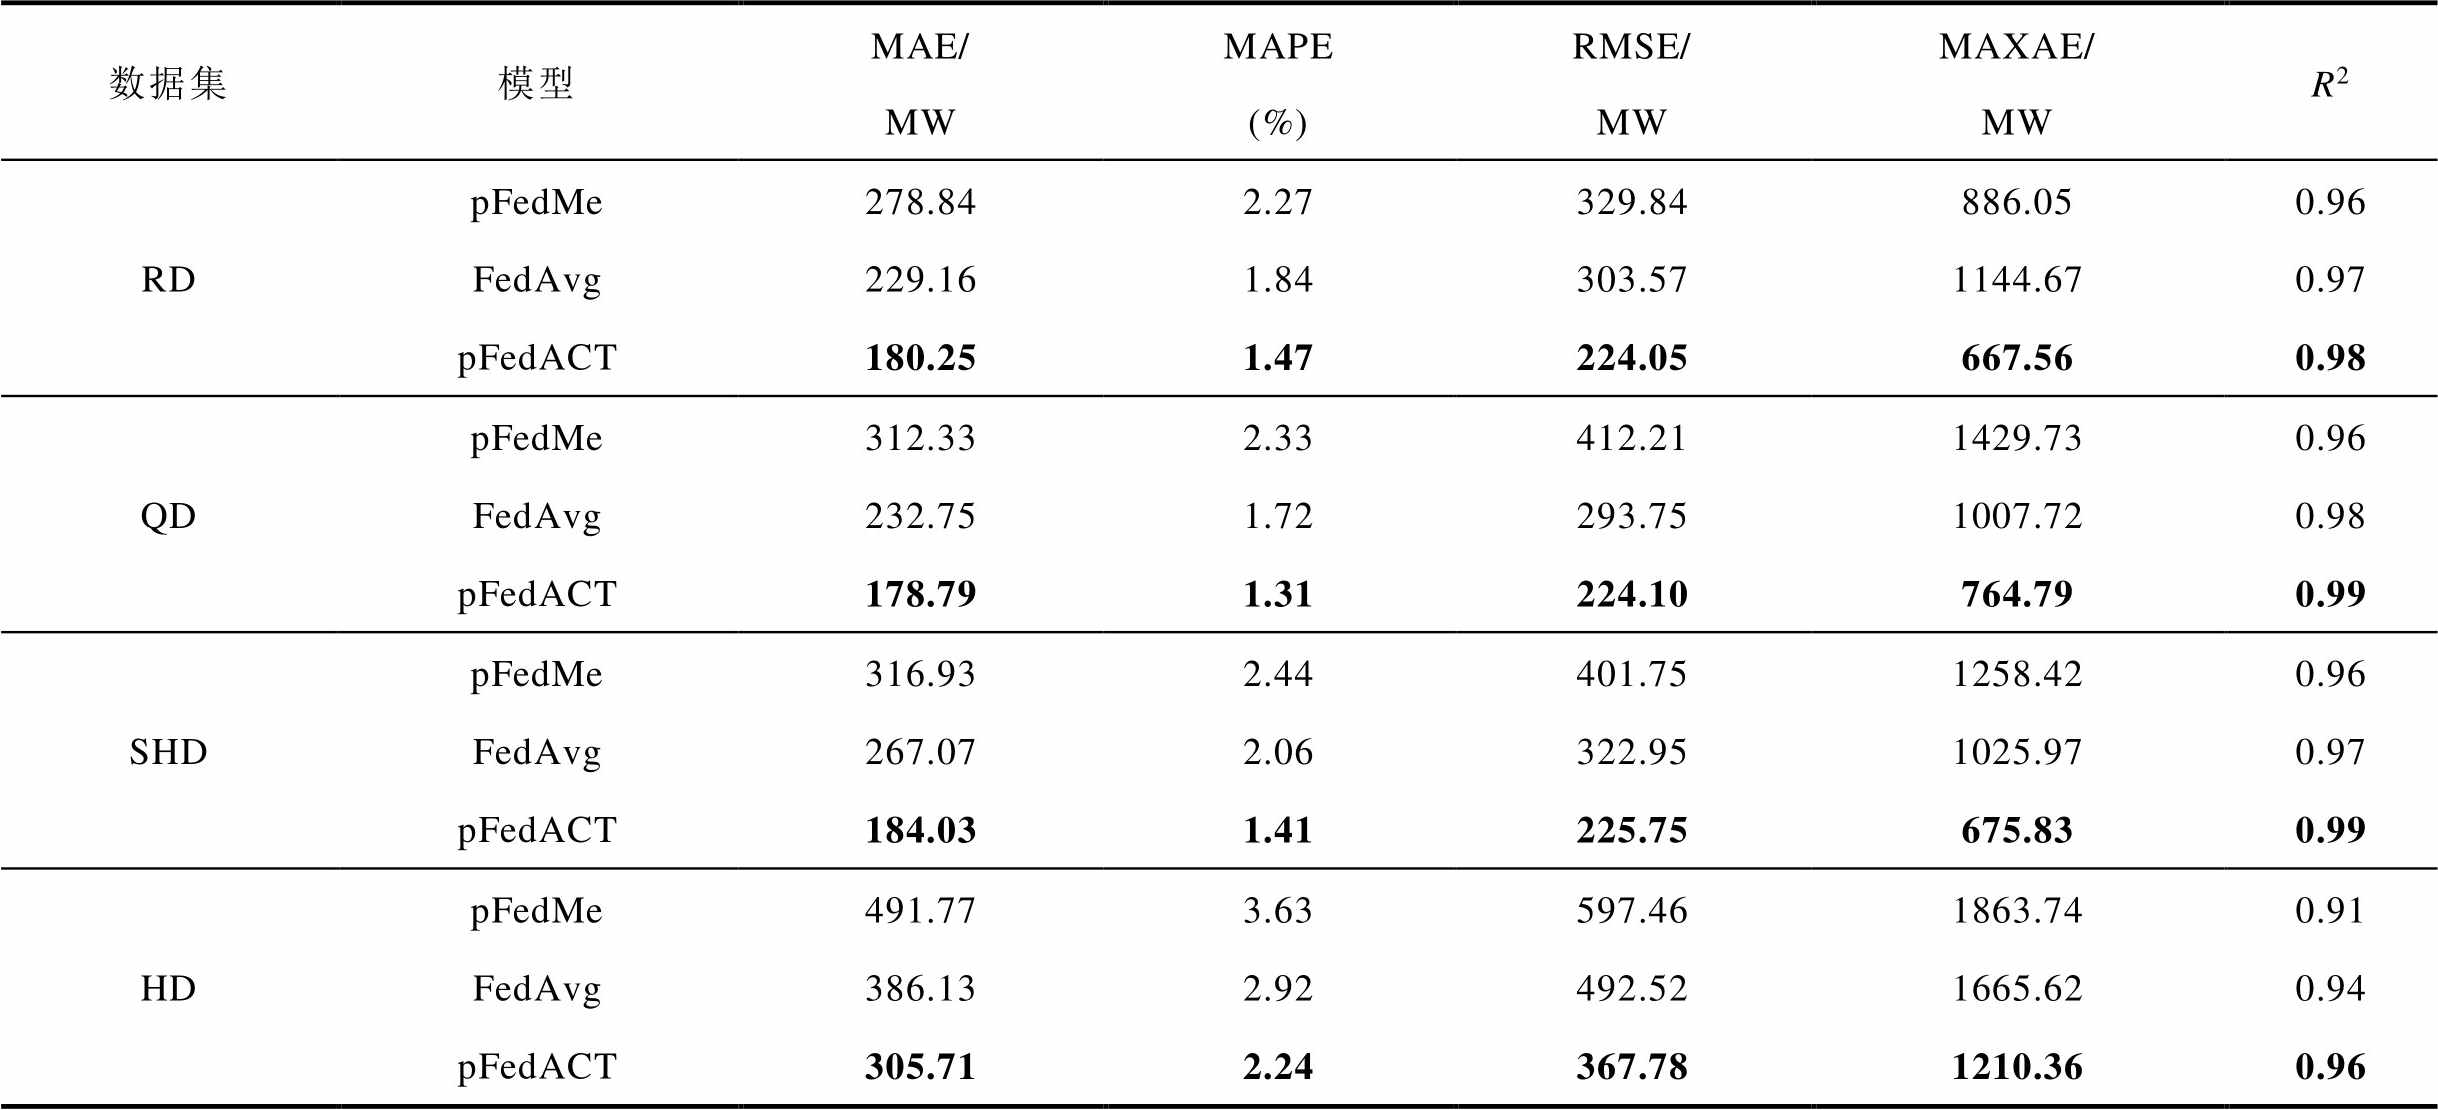
数据集模型MAE/MWMAPE(%)RMSE/MWMAXAE/MWR2 RDpFedMe278.842.27329.84886.050.96 FedAvg229.161.84303.571144.670.97 pFedACT180.251.47224.05667.560.98 QDpFedMe312.332.33412.211429.730.96 FedAvg232.751.72293.751007.720.98 pFedACT178.791.31224.10764.790.99 SHDpFedMe316.932.44401.751258.420.96 FedAvg267.072.06322.951025.970.97 pFedACT184.031.41225.75675.830.99 HDpFedMe491.773.63597.461863.740.91 FedAvg386.132.92492.521665.620.94 pFedACT305.712.24367.781210.360.96
3.3.2 与集中式建模方法对比
为评估pFedACT在保护数据隐私的同时,其预测性能是否受到影响,本实验假设不存在跨域传输数据泄露等问题,使用集中式建模方法对负荷数据进行建模分析,并将其预测结果与pFedACT的预测结果进行对比分析。
集中式建模方案性能评估见表4。pFedACT在多数指标上优于集中式建模方法。pFedACT在MAE、MAPE、RMSE及MAXAE上取得最好的性能,体现出更高的平均预测精度与良好的负荷曲线拟合能力。其中,pFedACT大幅降低了MAXAE值,表明其在处理Non-IID数据时,具备更强的异常捕捉能力与波动响应能力。相比之下,集中式建模方法在应对负荷剧烈波动场景下的稳定性不足,预测误差波动较大。值得注意的是,DNN作为pFedACT框架中的基础模型,其在集中式建模中的预测性能显著弱于在联邦学习框架下的表现。在pFedACT框架中,相比DNN模型的MAE下降了34.51%,且MAXAE取得了突破性改善,充分验证了pFedACT在提升模型性能的同时,能够在无需共享原始数据的前提下,有效地实现数据驱动的负荷预测建模目标。
表4 集中式建模方案性能评估
Tab.4 Centralized modeling scheme performance evaluation
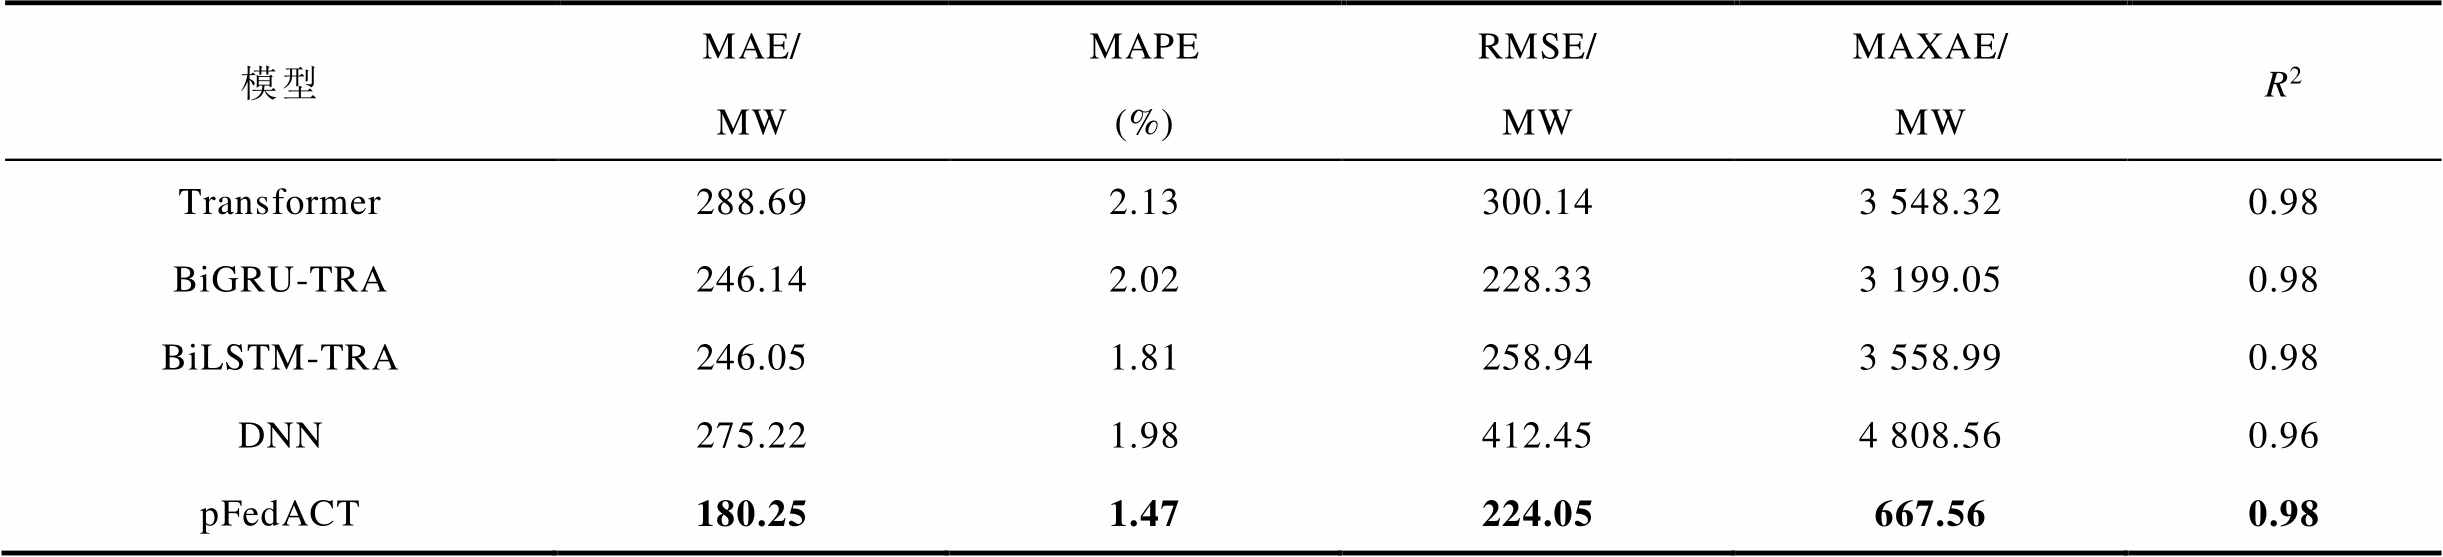
模型MAE/MWMAPE(%)RMSE/MWMAXAE/MWR2 Transformer288.692.13300.143 548.320.98 BiGRU-TRA246.142.02228.333 199.050.98 BiLSTM-TRA246.051.81258.943 558.990.98 DNN275.221.98412.454 808.560.96 pFedACT180.251.47224.05667.560.98
pFedACT相较于集中式建模方法表现更优,其关键在于引入了张量分解机制,对模型参数进行低秩表示与高效特征提取,从而有效地缓解了DNN模型在集中式训练中易出现的过拟合问题,使模型在充分训练后能够更精准地捕捉负荷数据的时序变化规律。此外,集中式建模往往倾向于拟合大多数用户的共性模式,削弱了对少数用户或特殊用电行为的个性化特征刻画能力。这种“平均化”效应使得集中式方法在负荷剧烈波动场景下表现不足。这一局限性在MAXAE中得到了直观的体现。
3.3.3 模型鲁棒性评估
1)不平衡数据集上的性能评估
在电力系统中,各客户端数据集不仅表现出Non-IID特性,而且存在数据规模异质性。这种异质性可能导致全局模型偏向于数据量较大的客户端。为评估数据不平衡的影响,本文通过在特定数据量范围内(1 000~3 000)随机分配客户端数据量,模拟现实环境中数据不平衡场景。
数据不平衡场景下模型性能评估见表5,在RD上,模型的关键性能指标处于优异水平。其中,MAE为180.25 MW,MAPE为1.47%,RMSE为224.05 MW,MAXAE为667.56 MW,R2高达0.98。值得注意的是,在数据不平衡工况下,模型的性能不仅没有下降,反而在部分关键指标上呈现具有统计学意义的改善:RMSE降低至220.49 MW,MAXAE降低至655.67 MW,同时MAE、MAPE和R2均保持了与其在RD上一致的高精度预测水平,表明pFedACT对数据不平衡场景具有较强的鲁棒性。
表5 数据不平衡场景下模型性能评估
Tab.5 Model performance evaluation in data imbalance scenario
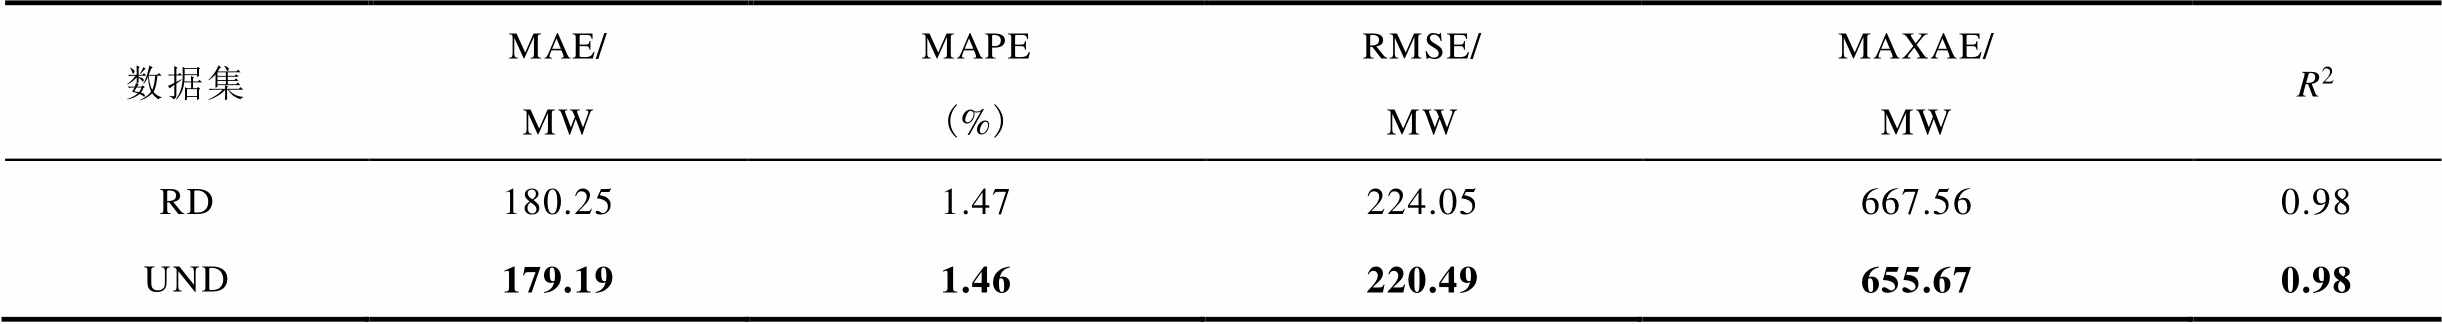
数据集MAE/MWMAPE(%)RMSE/MWMAXAE/MWR2 RD180.251.47224.05667.560.98 UND 179.191.46220.49655.670.98
2)多时间粒度预测性能评估
为评估模型在不同时间粒度数据集上的预测鲁棒性,图7进一步对比了pFedACT在RD、QD、SHD、HD上相较于基线模型的性能表现。图7中①、②、③、④分别代表MAE、MAPE、RMSE、MAXAE。在RD上,相较于FedAvg和pFedMe,MAE分别降低21.34%和35.36%,MAPE分别降低20.11%和35.24%,验证了所提方法对高频负荷数据波动特性的精确捕捉能力。随着时间粒度扩大至15 min(QD)和30 min(SHD),RMSE相对于pFedMe仍保持23.71%~45.63%的降幅,MAXAE较FedAvg最高降低46.50%,体现了pFedACT优异的多时间粒度预测稳定性。即使在1 h粗粒度数据(HD)中,所有误差指标较基准模型仍系统性降低20.83%~38.44%,且R2稳定维持在0.96以上,充分证明了pFedACT在多时间粒度负荷预测中的可行性和工程实用价值。
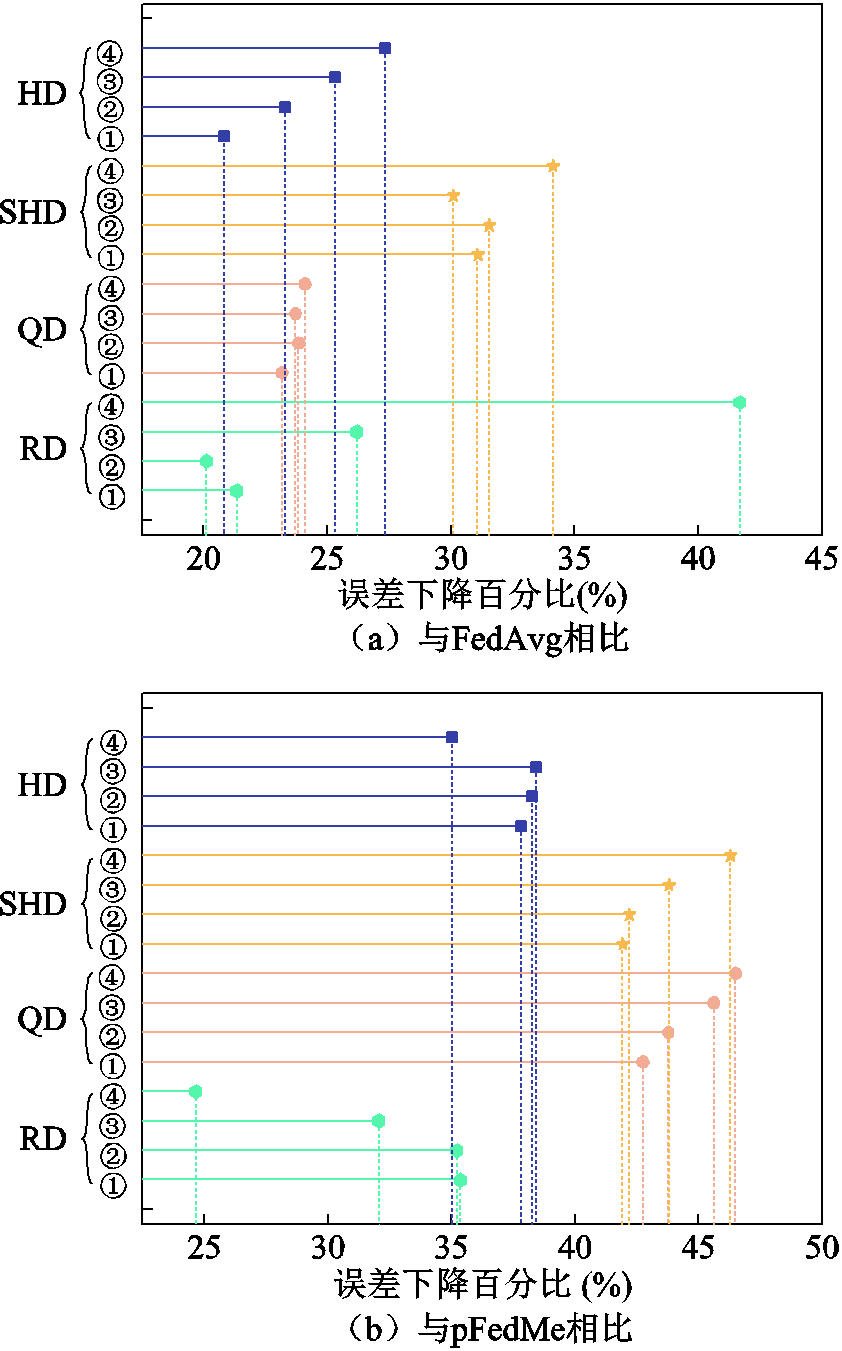
图7 多时间粒度数据集上模型性能对比
Fig.7 Performance comparison of models across multi-granularity time-series datasets
pFedACT在不平衡数据集与多时间粒度负荷预测场景下展现出卓越的鲁棒性,其核心优势在于其独特的双层损失函数设计。该设计通过引入正则化项,在最小化本地数据拟合误差的同时,可有效约束并对齐个性化模型与全局模型。由此,不仅显著缓解了数据分布不平衡带来的负面影响,确保预测结果的稳定性与准确性,同时显著提升了模型在跨时间粒度数据上的泛化能力与鲁棒性。
3)多类型负荷预测性能评估
为验证所提方法在不同类型负荷场景下的适应性,本研究在电负荷、冷负荷与热负荷三类典型负荷数据上开展预测实验。多类型负荷预测性能评估见表6。在三类负荷预测场景中,pFedACT的整体预测性能均优于FedAvg与pFedMe。
表6 多类型负荷预测性能评估
Tab.6 Multi-type load forecasting performance evaluation
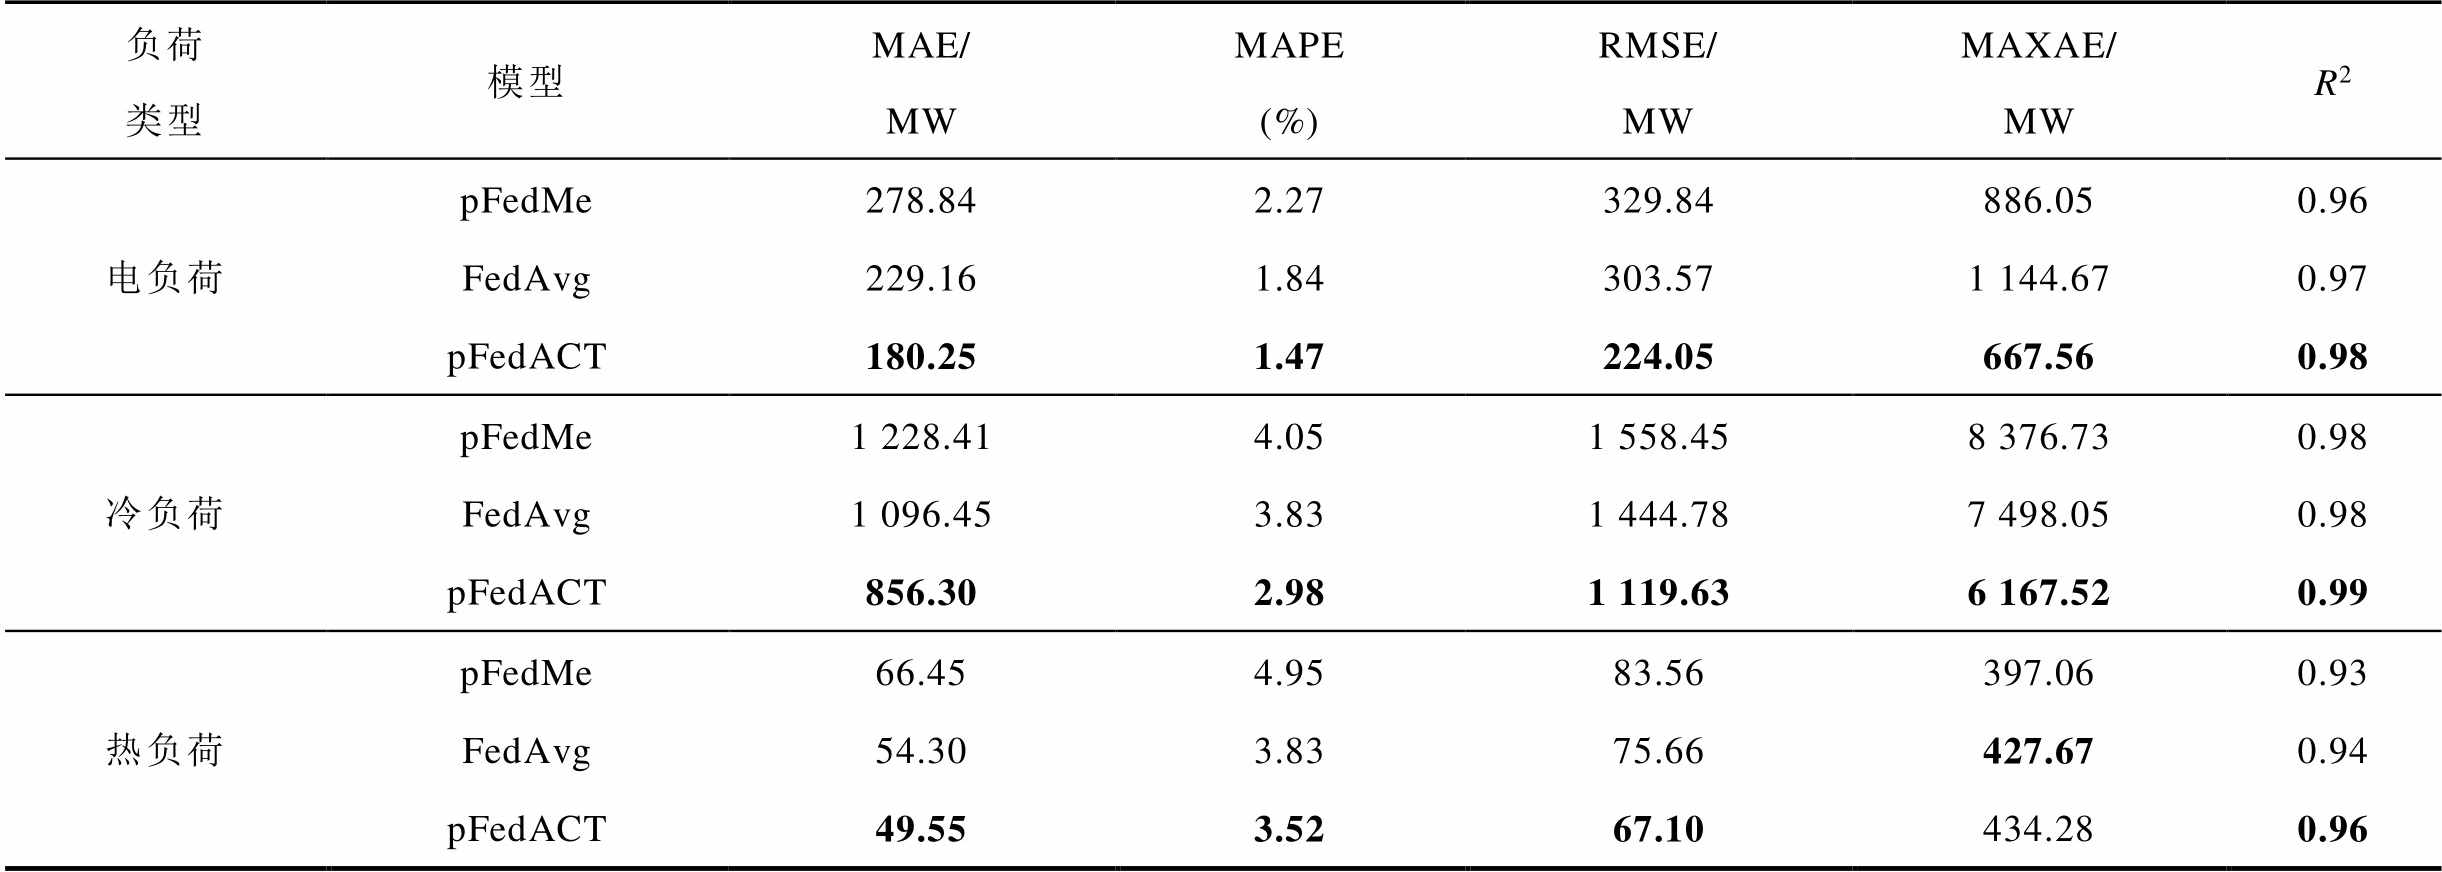
负荷类型模型MAE/MWMAPE(%)RMSE/MWMAXAE/MWR2 电负荷pFedMe278.842.27329.84886.050.96 FedAvg229.161.84303.571 144.670.97 pFedACT180.251.47224.05667.560.98 冷负荷pFedMe1 228.414.051 558.458 376.730.98 FedAvg1 096.453.831 444.787 498.050.98 pFedACT856.302.981 119.636 167.520.99 热负荷pFedMe66.454.9583.56397.060.93 FedAvg54.303.8375.66427.670.94 pFedACT49.553.5267.10434.280.96
在电负荷预测方面,pFedACT的MAE、MAPE与RMSE分别为180.25 MW、1.47%与224.05 MW,相比FedAvg分别下降约21.3%、20.1%与26.2%,且R2提升至0.98,表明其能够更准确地捕捉电力需求的动态变化。在冷负荷预测方面,pFedACT 的MAE与RMSE分别为856.30 MW与1 119.63 MW,较FedAvg分别降低21.9%与22.5%,R2提升至0.99,说明所提方法在高波动性和强非线性的冷负荷场景下同样具备较强的建模能力。在热负荷预测方面,pFedACT在各指标上也取得最优表现,其MAE、MAPE与RMSE分别为49.55 MW、3.52%与67.10 MW均显著优于基线方法,尤其在RMSE上相较FedAvg降低了约11.3%,R2提升至0.96。
4)多场景数据集下预测性能评估
本小节引入加拿大阿尔伯塔省的电力负荷数据集[28]、摩洛哥地区电力消费数据集[29]以及欧盟成员中11个国家或地区的电力负荷数据[30],三个数据集的时间分辨率分别为1 h、10 min、15 min。为了最大程度地模拟真实场景,实验仅对数据集中的缺失值进行线性插值,其余数据特征皆保持不变,从而评估pFedACT在多工况场景中的鲁棒性。
多场景数据集上预测性能评估见表7。在加拿大阿尔伯塔地区的负荷数据集上,pFedACT的MAE、MAPE和RMSE分别较FedAvg降低约14.77%、10.84%和9.93%,表明该方法在1 h时间分辨率下能够更有效地捕捉负荷的时序变化规律;在摩洛哥多区域用电数据集上,pFedACT同样取得最低的MAE、MAPE与RMSE,进一步体现出其在高频率、非均匀采样数据条件下的稳定泛化能力;在欧盟地区负荷数据集上,pFedACT在MAE、MAPE与RMSE三项指标上相较次优模型分别提升约8.22%、18.91%与6.91%。此外,在多场景数据集上,pFedACT均取得了最小的MAXAE,展现出最优的预测稳定性,并获得最高的决定系数R2=0.99,进一步验证了该模型在跨区域、多时间尺度非独立同分布数据下的鲁棒性与适应性。
表7 多场景数据集上预测性能评估
Tab.7 Prediction performance evaluation on multi-scenario datasets

数据来源模型MAE/kWMAPE(%)RMSE/kWMAXAE/kWR2 阿尔伯塔pFedMe6.894.2611.32113.950.99 FedAvg6.234.1510.57120.380.99 pFedACT5.313.709.52103.640.99 摩洛哥pFedMe5.717.289.39124.560.97 FedAvg5.217.199.08144.320.98 pFedACT4.556.807.19109.240.99 欧盟地区pFedMe368.522.83625.684 227.670.95 FedAvg309.732.01556.323 560.210.96 pFedACT284.261.63517.873 336.690.99
3.3.4 算法收敛性分析
为验证所提方法的收敛性,本文在RD、QD、SHD和HD四个数据集上,对比分析了pFedACT与 FedAvg和pFedMe三种方法在训练过程中的收敛稳定性与收敛效率。
1)收敛稳定性分析
本文从收敛速度和最终损失函数值两方面综合评估模型的收敛稳定性。通过采样步长为10的滑动窗口,计算模型MAE在测试集上的滚动平均值,并将达到最小值时对应的训练轮次作为潜在收敛点。为了确保收敛点的确定具有稳定性与一致性,本文进一步引入误差容限判据:当滚动平均MAE达到最小值后,在后续20个滑动窗口内误差降低幅度不超过1%时,则确认该训练轮次为最终收敛点。图8中 、
 、
 分别表示pFedACT、FedAvg、pFedMe的收敛点,并在图中以橙色五角星标注。pFedACT始终展现出最高的收敛稳定性,在RD、QD、SHD、HD上分别以535、748、724、648轮训练完成收敛。对比分析发现,在RD上,虽然FedAvg与pFedMe分别在第64轮、第486轮完成收敛,但其收敛时的损失函数值显著高于pFedACT。值得注意的是,在相同训练轮次(64轮、486轮)时,pFedACT已能取得更优的预测效果。在QD上,pFedACT在收敛速度和最终损失值方面均显著优于基准方法。对于SHD和HD,pFedACT在训练初期即表现出卓越的损失收敛速度,且最终收敛时的损失值低于FedAvg,而pFedMe则一直处于较高损失值状态,预测精度与收敛速度均低于pFedACT。
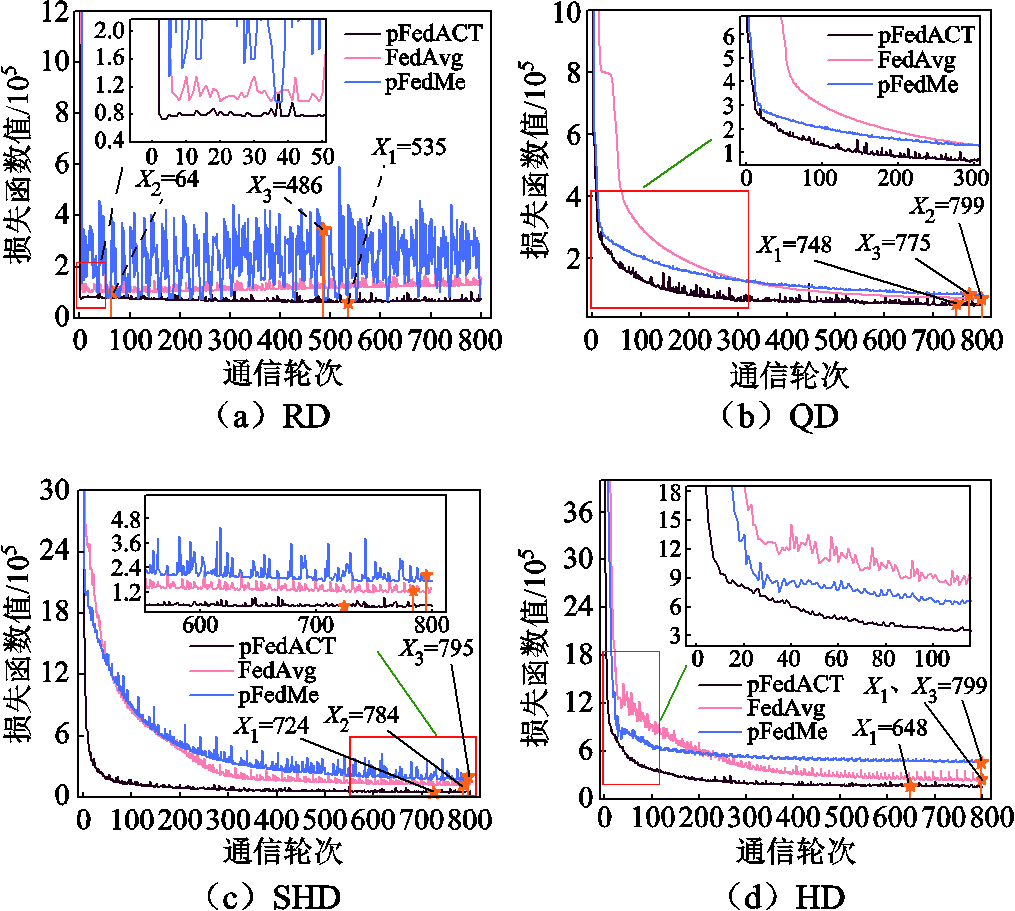
图8 不同数据集上算法收敛效果分析
Fig.8 Analysis diagram of algorithm convergence effect on different datasets
2)收敛效率分析
表8展示了模型在不同数据集上的收敛效率。pFedACT在不同时间粒度数据集上均展现出不同程度的收敛效率优势。在RD上,pFedACT仅在第一轮训练后就实现了98.56%的MAE下降,而pFedMe和FedAvg分别为82.09%和98.35%。在前5轮训练中,pFedACT的MAE下降率稳定在98.60%,而pFedMe和FedAvg分别为97.15%和98.34%。值得注意的是,pFedACT在前5轮训练中已接近其最终收敛性能,而其他方法需要更多轮次才能达到类似水平。类似趋势在QD、SHD和HD上同样明显:在QD上,pFedACT前5轮下降率为96.64%,显著高于pFedMe的95.57%和FedAvg的95.38%;在SHD和HD上,pFedACT前5轮下降率分别达到95.33%和94.77%,而pFedMe仅为93.00%和90.74%。
表8 MAE下降率随训练轮次的变化
Tab.8 MAE decline rate across training epochs

数据集模型MAE下降率(%)初始MAE/MW 首轮前5轮前10轮前15轮 RDpFedMe82.0997.1597.6397.4514 314.73 FedAvg98.3598.3498.3298.42 pFedACT98.5698.6098.6098.62 QDpFedMe88.5495.5796.0495.9215 871.17 FedAvg95.3895.3895.4495.45 pFedACT96.1596.6497.0697.46 SHDpFedMe91.9293.0093.2293.3815 201.27 FedAvg86.4691.9092.1092.46 pFedACT93.2595.3396.4196.59 HDpFedMe87.8090.7692.0392.6015 496.64 FedAvg84.6688.2890.2292.00 pFedACT90.5994.7795.5195.83
从表8中可以发现,pFedACT在时间粒度较大、数据量较少的数据集上(SHD、HD)的收敛优势更为突出。这表明pFedACT的张量分解机制在数据稀疏场景下具有更强的表征能力,能有效提取粗粒度数据中的深层特征,而基准方法在样本有限时容易陷入局部最优。
3.3.5 模型泛化能力分析
为检验pFedACT在面对不同客户端异质数据时的泛化能力,本文进一步在不同客户端规模的RD上对比与分析全局模型和个性化模型性能。全局模型较个性化模型性能增益如图9所示,全局模型在各类评价指标上均较个性化模型取得了显著的性能提升。在客户端数量为20时,MAE、RMSE、MAPE与MAXAE分别提升了45.49%、49.08%、44.11%和60.04%;在50客户端设置下,各项指标仍保持超过38%以上的提升。其中MAXAE提升幅度高达50.89%。随着客户端数量进一步增加至80与100,性能提升幅度虽有所回落,但仍保持在29%~43%之间,表明全局模型在较大规模分布式场景中仍具备稳定的泛化优势。这一结果说明,pFedACT能够有效利用跨客户端信息,在高度异构的数据环境中依然保持较强的泛化与预测能力。
进一步从表9可以看出,全局模型在不同客户端规模下均保持出色的预测性能。在20客户端场景下,全局模型的MAE为180.25 MW,RMSE为224.05 MW,R2达到0.98,显示出优异的拟合效果。随着客户端规模扩展至50、80及100,全局模型在MAE、MAPE、RMSE及MAXAE等指标上仍保持明显优势,R2最高可达0.99,表明在大规模异构数据条件下模型依然具备高精度和稳定性。整体而言,pFedACT能够兼顾预测精度与稳健性,有效地体现了其在不同客户端规模和数据异质性条件下的泛化能力。这主要得益于pFedACT通过双层损失函数动态平衡本地数据拟合与全局约束,实现了用户特异性与共性模式的协同优化;同时,集成张量聚合机制能够高效表征各客户端的特征差异,显著提升了全局模型对各客户端Non-IID数据的拟合能力。
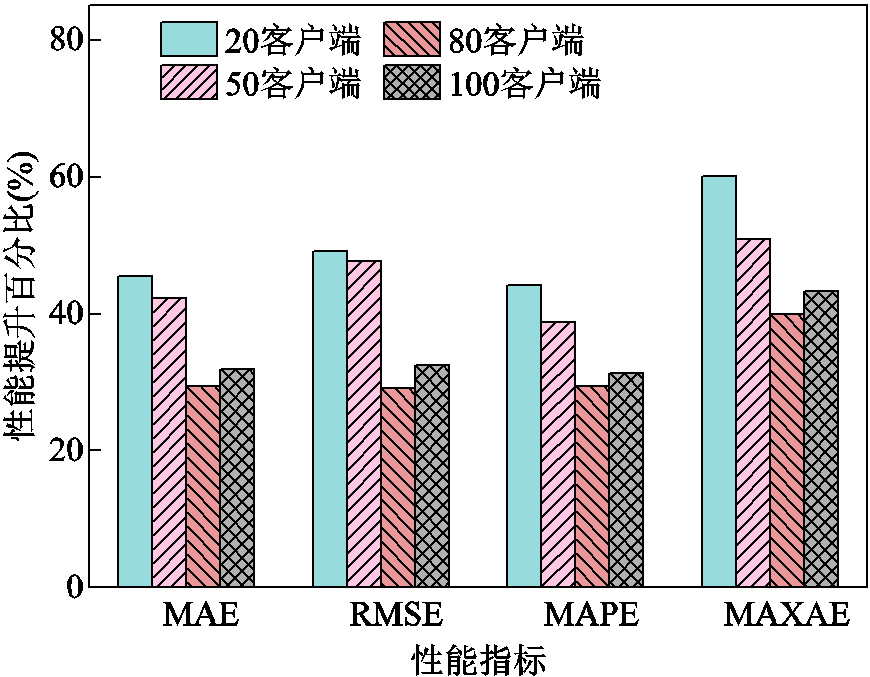
图9 全局模型较个性化模型性能增益
Fig.9 Performance gain of global model over personalized models
表9 不同规模客户端下模型泛化能力评估
Tab.9 Model generalization evaluation across client scales
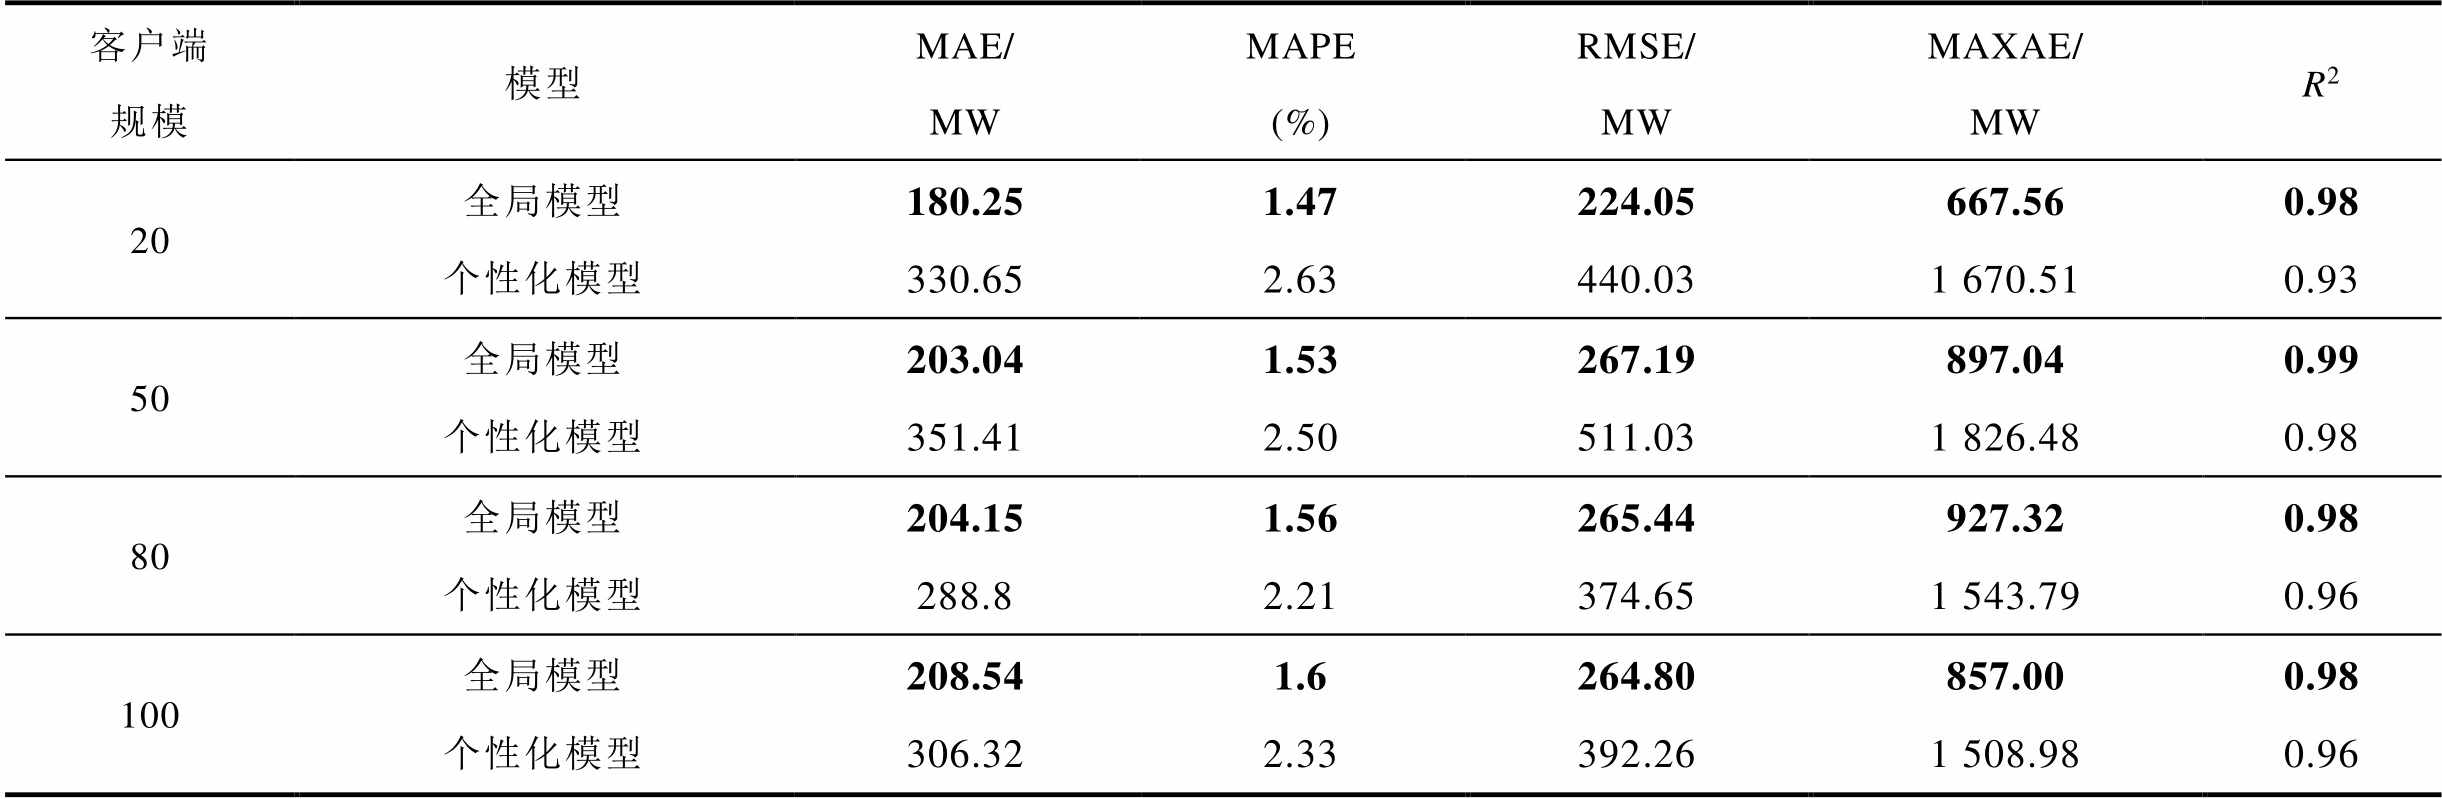
客户端规模模型MAE/MWMAPE(%)RMSE/MWMAXAE/MWR2 20全局模型180.251.47224.05667.560.98 个性化模型330.652.63440.031 670.510.93 50全局模型203.041.53267.19897.040.99 个性化模型351.412.50511.031 826.480.98 80全局模型204.151.56265.44927.320.98 个性化模型288.82.21374.651 543.790.96 100全局模型208.541.6264.80857.000.98 个性化模型306.322.33392.261 508.980.96
3.3.6 不同基础模型在pFedACT中的性能评估
为验证所提pFedACT方法在不同基础模型下的适用性与鲁棒性,本文进一步比较了卷积神经网络(Convolutional Neural Network, CNN)与LSTM在集中式建模时的预测性能与其在 pFedACT框架下的性能差异。不同基础模型在pFedACT中的预测性能评估见表10,pFedACT 在不同基础模型上均展现出稳定的性能提升。以CNN为基础模型时,pFedACT在MAE、RMSE和MAXAE上分别实现了18.98%、26.86% 和49.96%的改善,表明该框架能够在精度与鲁棒性方面显著提升模型表现。而在以LSTM为基础模型的场景下,尽管LSTM的预测性能整体偏弱,集中式建模下误差水平较高,但pFedACT仍在MAE、RMSE与MAXAE三个指标上分别取得了34.90%、24.96%和21.72%的提升。
表10 不同基础模型在pFedACT中的预测性能评估
Tab.10 Performance evaluation of different base models in pFedACT
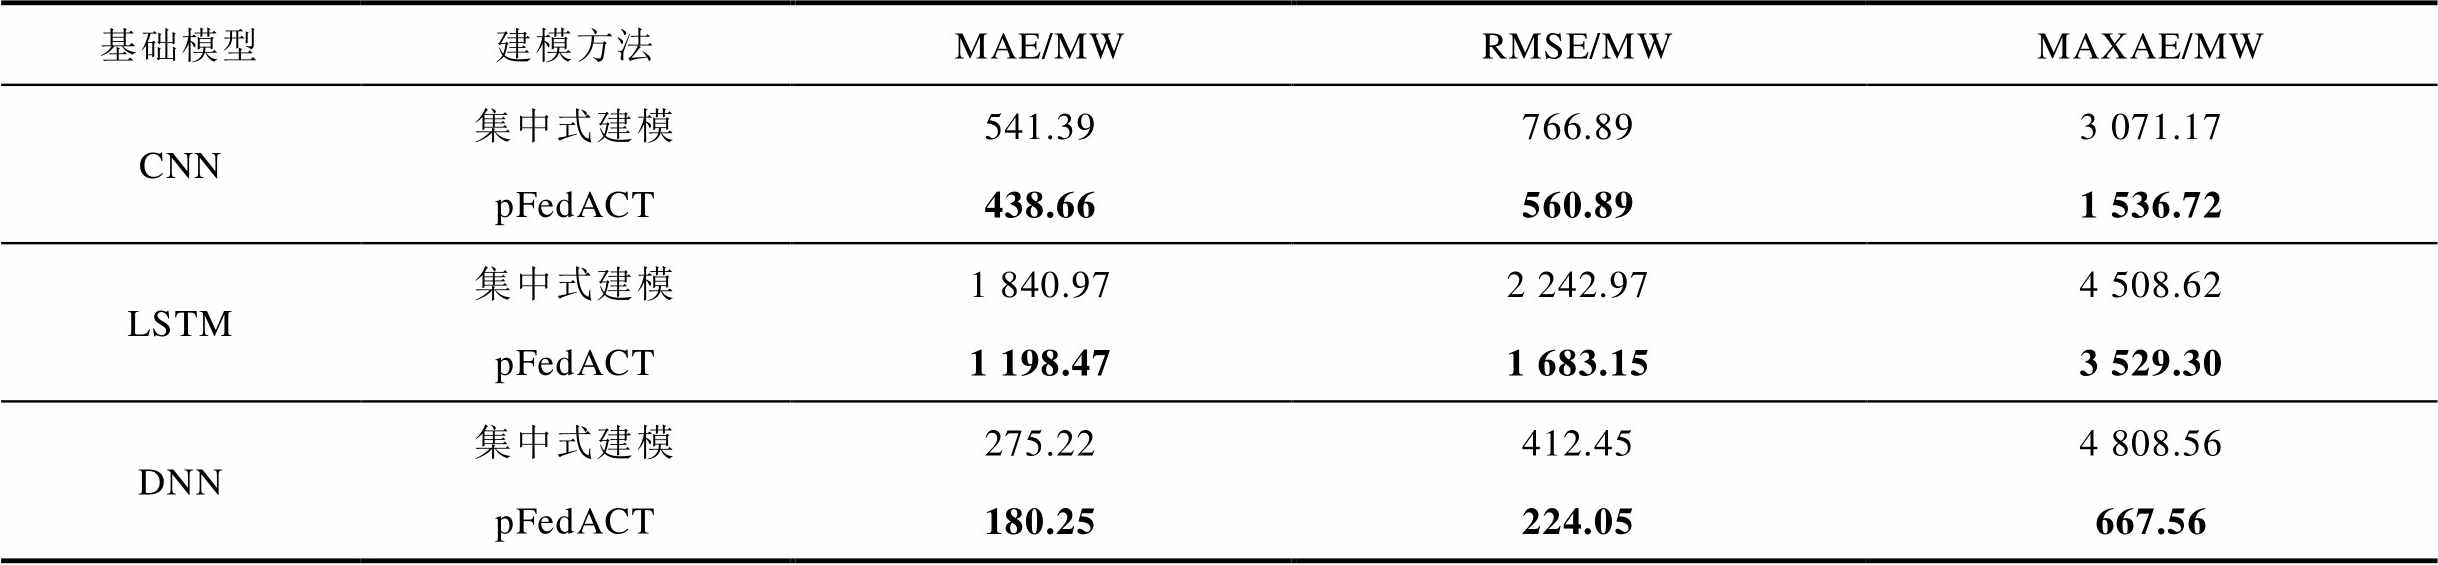
基础模型建模方法MAE/MWRMSE/MWMAXAE/MW CNN集中式建模541.39766.893 071.17 pFedACT438.66560.891 536.72 LSTM集中式建模1 840.972 242.974 508.62 pFedACT1 198.471 683.153 529.30 DNN集中式建模275.22412.454 808.56 pFedACT180.25224.05667.56
上述结果表明,pFedACT在不同类型的基础模型上均展现出一致且显著的性能增益。无论是以CNN为代表的局部特征提取模型,还是以LSTM为代表的时序依赖模型,pFedACT均能够有效降低预测误差并提升鲁棒性。这充分说明pFedACT具有较强的跨模型架构适应性与普适性增强作用,能够在多样化的建模框架下稳定改善性能,从而验证了所提方法在复杂分布式预测场景中的广泛适用性与稳健性。
3.3.7 不同客户端规模下的可行性评估
由于电力系统规模存在不一致性,为验证所提pFedACT在实际应用场景中的可行性,本文在原有20客户端实验组基础上,设计了50、80、100个客户端场景的模型性能评估实验。不同规模客户端实验中模型性能分析如图10所示。在不同客户端规模的实验中,pFedACT相较于FedAvg和pFedMe表现出更平稳的收敛趋势与更高的优化效率。图10中标记①、②、③分别对应pFedACT、FedAvg和pFedMe。

图10 不同规模客户端实验中模型性能分析
Fig.10 Performance analysis of the model in experiments with varying client scales
进一步从表11的对比结果可以看出,pFedACT在各客户端规模下均表现出显著的性能优势。在预测精度方面,pFedACT的MAE、MAPE、RMSE表现显著优于FedAvg和pFedMe。在预测稳定性方面,pFedACT的MAXAE始终大幅低于其他方法,说明其预测结果波动性更小,面对极端值具有更强的鲁棒性。在拟合优度方面,pFedACT在所有客户端规模下 均接近最优值1,进一步验证了其对不同规模电力系统负荷数据变化模式的准确建模能力,能有效地适应电力系统规模的变化,具备良好的可扩展性。
表11 不同规模客户端下模型可行性评估
Tab.11 Feasibility evaluation of the model under different client scales
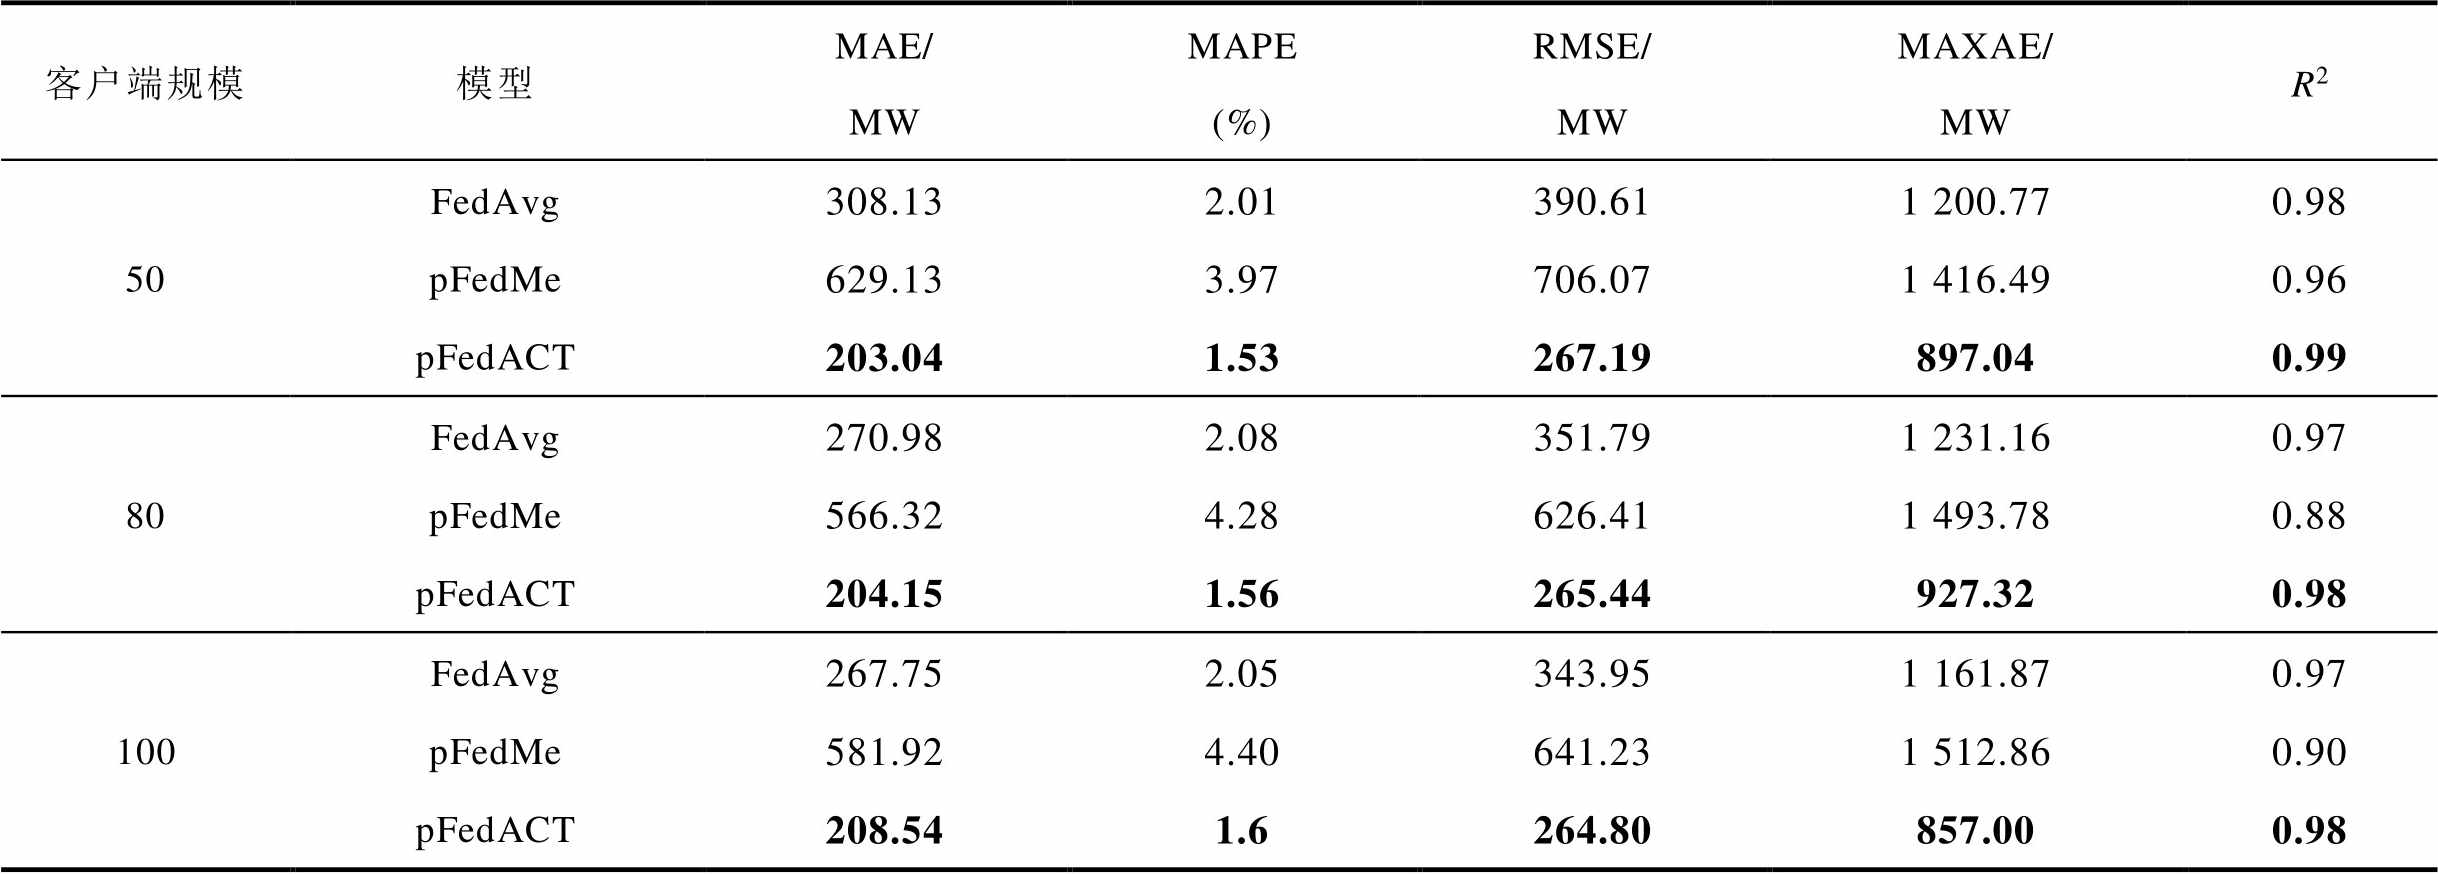
客户端规模模型MAE/MWMAPE(%)RMSE/MWMAXAE/MWR2 50FedAvg308.132.01390.611 200.770.98 pFedMe629.133.97706.071 416.490.96 pFedACT203.041.53267.19897.040.99 80FedAvg270.982.08351.791 231.160.97 pFedMe566.324.28626.411 493.780.88 pFedACT204.151.56265.44927.320.98 100FedAvg267.752.05343.951 161.870.97 pFedMe581.924.40641.231 512.860.90 pFedACT208.541.6264.80857.000.98
3.3.8 通信成本分析
为进一步分析pFedACT在通信成本方面的优势,本文使用压缩率来表示经张量分解后模型参数的缩减程度。对于由CP分解的权重参数构成的网络结构,压缩率定义为原始网络总参数量与张量分解后的网络参数量比率。例如,全连接层权重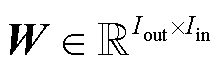 ,原始权重参数量是
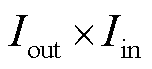 ,CP分解后的参数量是
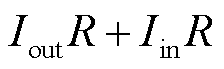 ,那么全连接层的压缩率CR可表示为
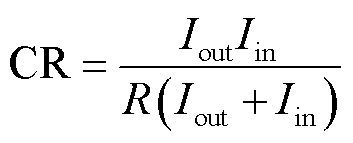 (36)
根据模型超参数的设置,算例分析中张量分解的秩均设置为3,模型的中间层权重参数 与
 皆为10,由此可得出所提方法对于全连接层参数的压缩率为1.67。
由于本文所用DNN模型的输出层秩为1,无法进行压缩,所以中间层的压缩率无法完全代表整体模型的压缩率。为此,本文进一步从模型训练过程中参数传输数据量方面分析所提方法在通信成本方面的优势。pFedACT在模型训练过程中,单个客户端单次向服务器传输的模型参数大小为328 B,而FedAvg与pFedMe为484 B,实际压缩率为1.48。服务器向客户端广播参数时的数据量与压缩率与客户端向服务器上传数据时一致。通信成本分析如图11所示。以100个客户端训练800轮为例,pFedACT全程训练共需传输52 480 000 B参数,而传统方法则需传输77440000 B参数,降低通信成本24 960000 B。相比于基线模型,pFedACT大约降低了32.23%的通信成本。
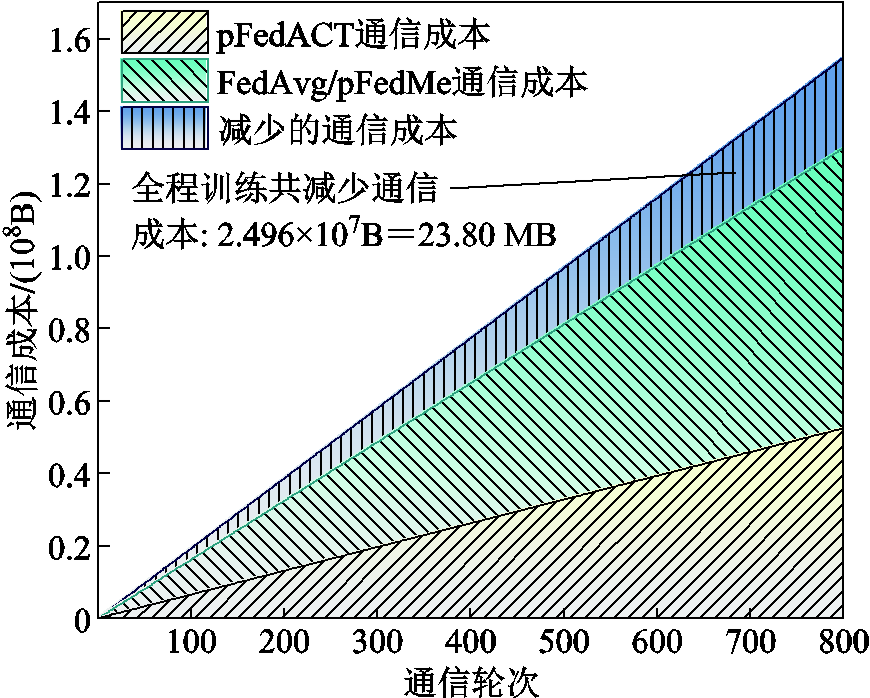
图11 通信成本分析
Fig.11 Communication cost analysis
在更大规模的模型中,pFedACT对于通信成本降低的优势将更为明显。以本文实验中得到的32.23%通信成本削减率为例,若在更大规模模型场景下假设模型参数量为100 MB,则单轮通信中可节省约32.23 MB的数据传输。在百兆(100 Mbit/s)网络条件下,这部分数据量对应的传输时间约为2.58 s。在弱网环境中,例如10 Mbit/s带宽下,相同的数据量节省则可缩短约25.78 s的传输时延;在仅1 Mbit/s的极端受限条件下,时延缩减甚至可达257.84 s。由此可见,随着模型参数规模的扩大和网络条件的恶化,通信成本削减的相对优势将被进一步放大,从而显著提升联邦学习在大规模客户端与实际电力系统环境下的可扩展性和可行性。
为降低联邦学习过程中的通信成本,并提升模型收敛效率,增强鲁棒性与泛化能力,本文提出了一种考虑低通信成本的张量分解个性化联邦学习超短期电力负荷预测方法,基于多工况运行场景数据集进行了多维度模型性能验证。本文总结如下:
1)相较于经典联邦学习策略,pFedACT通过双层损失函数对局部张量模型与个性化模型间距离施加正则化约束,使各客户端能在共享全局知识的基础上持续优化本地模型,有效地增强了模型对电力系统多工况场景负荷曲线的拟合能力,显著提升了模型鲁棒性与收敛效率。
2)通过模型泛化能力分析发现,pFedACT的全局模型性能优于各客户端的个性化模型,表明该方法通过引入张量分解技术,有效地增强了模型参数的时空表达能力。同时,基于集成张量聚合机制实现全局模型的有效聚合与更新,显著提升了模型在应对Non-IID数据场景下的泛化能力。
3)在不同客户端规模实验中,pFedACT均维持优异的性能,且pFedACT全局模型预测精度始终大幅领先各客户端的个性化模型,充分验证了其在不同规模电力系统场景下的适应性与工程实用价值。
4)通过对模型训练过程通信成本分析发现,pFedACT相比经典联邦学习模型,其训练过程中的通信成本降低约32.23%。在客户端数量进一步增加及模型复杂度显著提升的应用场景下,该方法在通信成本方面的优势将更加突出。
附 录
附表1 基于pFedACT的超短期负荷预测算法
App.Tab.1 Ultra-short-term load forecasting algorithm based on pFedACT

算法:本文所提基于pFedACT的超短期负荷预测算法伪代码 输入:步骤1:初始化。模型超参数设置;//数据降噪;If 需要数据降采样//执行数据降采样;//分配数据;Then or //分配数据;//全局模型参数初始化;;;//执行张量分解。步骤2:客户端模型训练。for 全局训练for 客户端模型训练for 个性化模型训练//优化器梯度清零;;//计算当前批次损失函数值;loss.backward()//反向传播,计算损失函数关于参数的
(续)
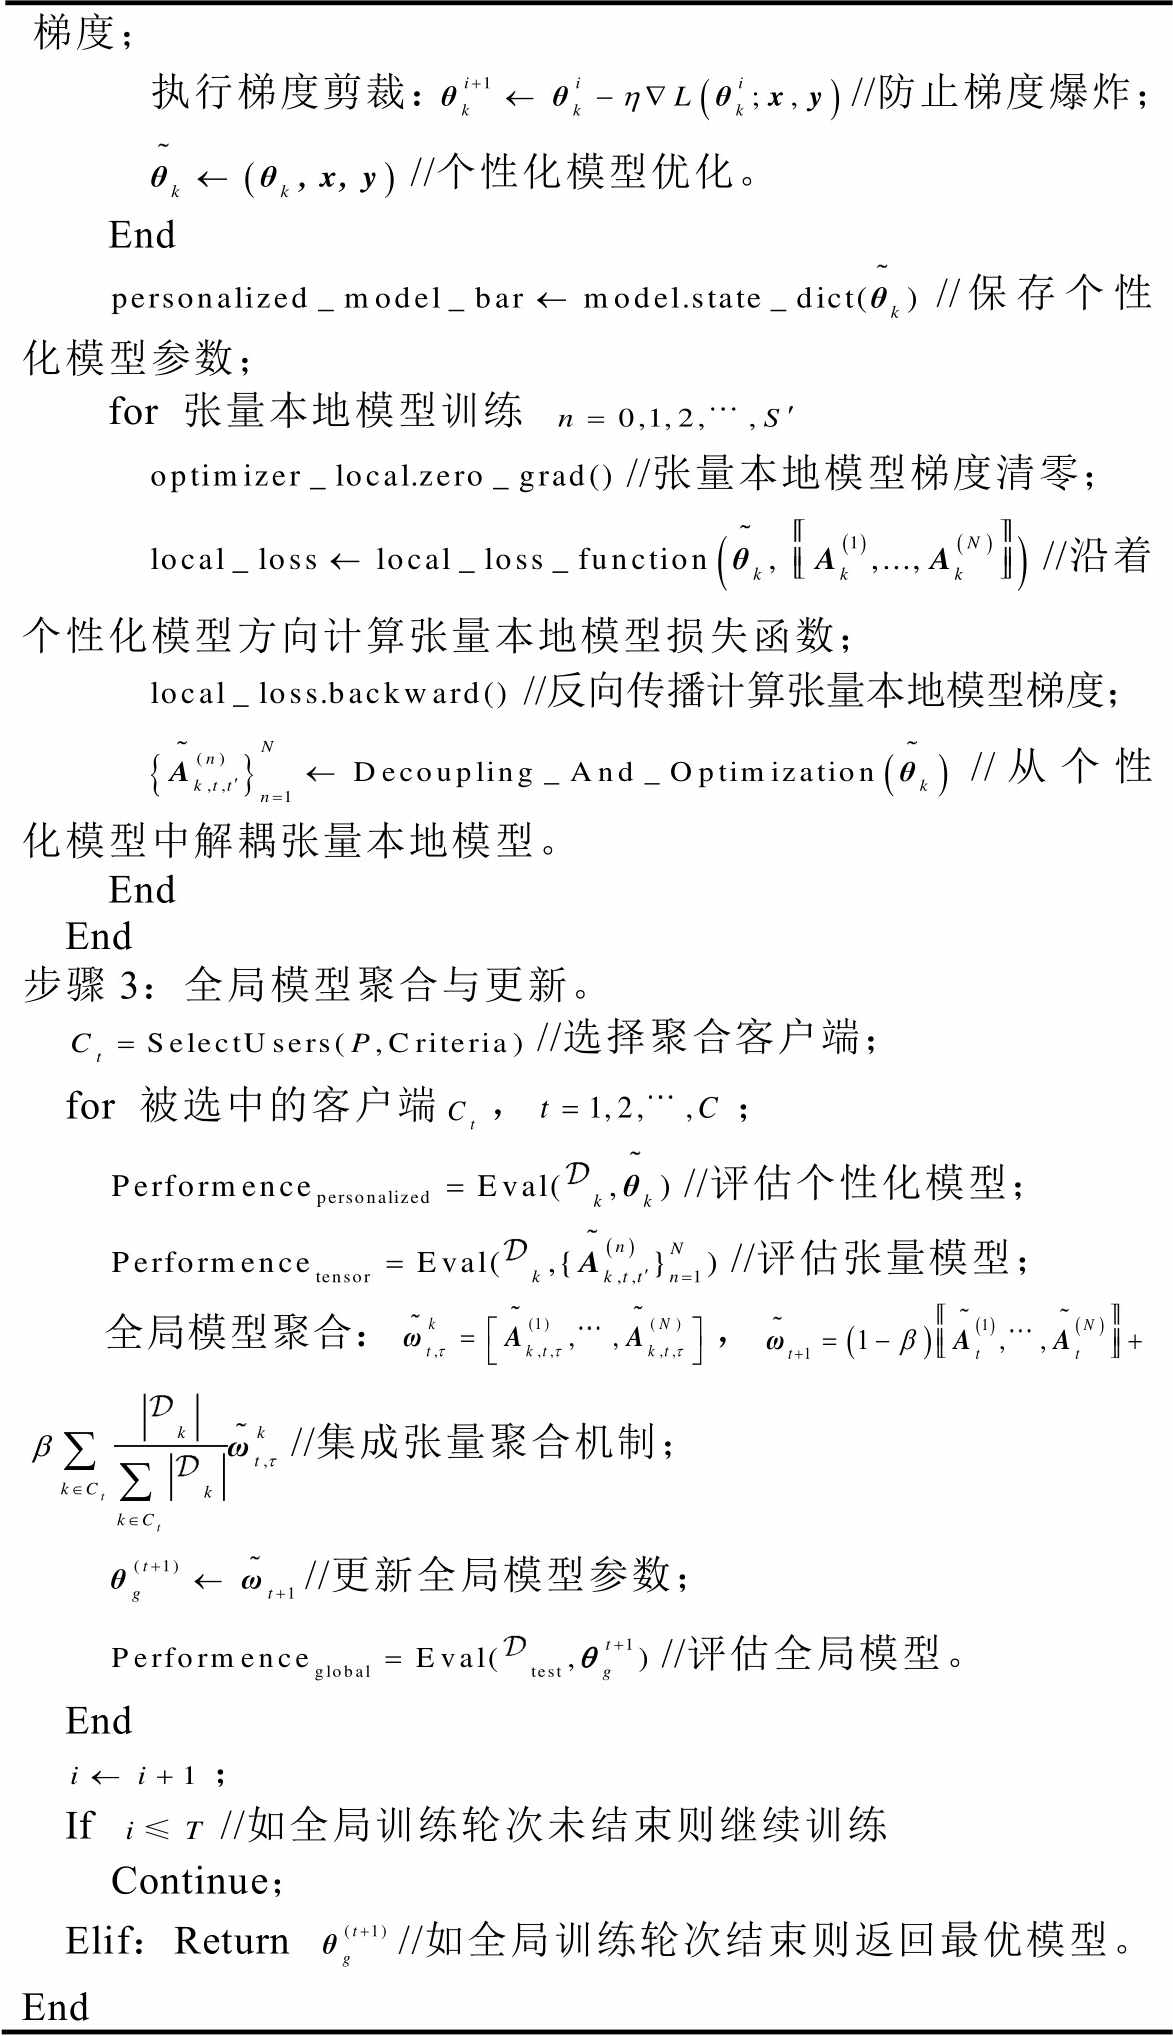
梯度;执行梯度剪裁://防止梯度爆炸;//个性化模型优化。End//保存个性化模型参数;for 张量本地模型训练//张量本地模型梯度清零;//沿着个性化模型方向计算张量本地模型损失函数;//反向传播计算张量本地模型梯度;//从个性化模型中解耦张量本地模型。EndEnd步骤3:全局模型聚合与更新。//选择聚合客户端;for 被选中的客户端,;//评估个性化模型;//评估张量模型;全局模型聚合:,//集成张量聚合机制;//更新全局模型参数;//评估全局模型。End;If //如全局训练轮次未结束则继续训练 Continue;Elif:Return //如全局训练轮次结束则返回最优模型。End
附表2 集中式建模所用模型超参数设置
App.Tab.2 Hyperparameter settings of the centralized modeling

模型参数名称超参数最优参数值 TransformerTransformer编码器注意力头大小256 注意力头数量4 前馈网络维度4 编码器层数4 Dropout比率0.25 MLP回归层隐藏层单元数128 Dropout比例0.4 输出层输出单元数1 激活函数selu 训练配置损失函数MSE 优化器Adam 学习率0.001
(续)

模型参数名称超参数最优参数值 BiGRU-TRATransformer编码器注意力头大小256 注意力头数量4 前馈网络维度4 编码器层数4 Dropout比率0.25 BiGRU分支GRU隐藏单元数128 全连接层激活函数linear MLP回归层隐藏层单元数128 Dropout比例0.4 输出层输出单元数1 激活函数selu 训练配置损失函数MSE 优化器Adam 学习率0.001 BiLSTM-TRATransformer编码器注意力头大小256 注意力头数量4 前馈网络维度4 编码器层数4 Dropout比率0.25 BiLSTM分支LSTM隐藏单元数5 全连接层激活函数linear MLP回归层隐藏层单元数128 Dropout比例0.4 输出层输出单元数1 激活函数selu 训练配置损失函数MSE 优化器Adam 学习率0.001 DNN输入层神经元数量10 中间层神经元数量10 输出层神经元数量1 训练配置激活函数ReLU 学习率0.001 学习率0.001
参考文献
[1] Akyol H B, Preist C, Schien D. Avoiding overconfidence in predictions of residential energy demand through identification of the persistence forecast effect[J]. IEEE Transactions on Smart Grid, 2023, 14(1): 228-238.
[2] Kim N, Park H, Lee J, et al. Short-term electrical load forecasting with multidimensional feature extraction [J]. IEEE Transactions on Smart Grid, 2022, 13(4): 2999-3013.
[3] 李云松, 张智晟. 考虑综合需求响应的Transformer-图神经网络综合能源系统多元负荷短期预测[J]. 电工技术学报, 2024, 39(19): 6119-6128. Li Yunsong, Zhang Zhisheng. Transformer based multi load short-term forecasting of integrated energy system considering integrated demand response[J]. Transactions of China Electrotechnical Society, 2024, 39(19): 6119-6128.
[4] de Vilmarest J, Browell J, Fasiolo M, et al. Adaptive probabilistic forecasting of electricity (net-) load[J]. IEEE Transactions on Power Systems, 2024, 39(2): 4154-4163.
[5] 李延珍, 王海鑫, 杨子豪, 等. 基于非侵入式负荷分解的家庭负荷两阶段超短期负荷预测模型[J]. 电工技术学报, 2024, 39(11): 3379-3391.Li Yanzhen, Wang Haixin, Yang Zihao, et al. Two-stage ultra-short-term load forecasting model of household appliances based on non-intrusive load disaggregation[J]. Transactions of China Electro-technical Society, 2024, 39(11): 3379-3391.
[6] 赵洪山, 吴雨晨, 温开云, 等. 基于时空注意力机制的台区多用户短期负荷预测[J]. 电工技术学报, 2024, 39(7): 2104-2115. Zhao Hongshan, Wu Yuchen, Wen Kaiyun, et al. Short-term load forecasting for multiple customers in a station area based on spatial-temporal attention mechanism[J]. Transactions of China Electrotechnical Society, 2024, 39(7): 2104-2115.
[7] 钟吴君, 李培强, 涂春鸣. 基于EEMD-CBAM-BiLSTM的牵引负荷超短期预测[J]. 电工技术学报, 2024(21): 6850-6864. Zhong Wujun, Li Peiqiang, Tu Chunming. Traction load ultra-short-term forecasting framework based on EEMD-CBAM-BiLSTM[J]. Transactions of China Electrotechnical Society, 2024, 39(21): 6850-6864.
[8] Oreshkin B N, Dudek G, Pełka P, et al. N-BEATS neural network for mid-term electricity load forecasting[J]. Applied Energy, 2021, 293: 116918.
[9] 冯昌森, 钱燚飞, 邵亮, 等. 考虑特征缺失的个性化居民短期负荷预测[J]. 电力系统自动化, 2025, 49(16): 75-84. Feng Changsen, Qian Yifei, Shao Liang, et al. Personalized short-term residential load forecasting considering missing feature[J]. Automation of Electric Power Systems, 2025, 49(16): 75-84.
[10] Husnoo M A, Anwar A, Hosseinzadeh N, et al. A secure federated learning framework for residential short-term load forecasting[J]. IEEE Transactions on Smart Grid, 2023, 15(2): 2044-2055.
[11] Zhang Yigong, Cui Qiushi, Shi Lixian, et al. PPenergyNET: privacy-preserving multi-energy load forecasting in energy Internet considering energy coupling[J]. IEEE Transactions on Power Systems, 2024, 39(5): 6235-6248.
[12] Wang Renjun, Qiu Haifeng, Gao Hongjun, et al. Adaptive horizontal federated learning-based demand response baseline load estimation[J]. IEEE Transactions on Smart Grid, 2023, 15(2): 1659-1669.
[13] Qin Dalin, Wang Chenxi, Wen Qingsong, et al. Personalized federated DARTS for electricity load forecasting of individual buildings[J]. IEEE Transactions on Smart Grid, 2023, 14(6): 4888-4901.
[14] Si C, Wang Haijin, Chen Lei, et al. Robust co-modeling for privacy-preserving short-term load forecasting with incongruent load data distributions[J]. IEEE Transactions on Smart Grid, 2024, 15(3): 2985-2999.
[15] He Yu, Luo Fengji, Sun Mingyang, et al. Privacy-preserving and hierarchically federated framework for short-term residential load forecasting[J]. IEEE Transactions on Smart Grid, 2023, 14(6): 4409-4423.
[16] Dinh C T, Tran N H, Nguyen T D. Personalized federated learning with moreau envelopes[J]. Advances in neural information processing systems, 2020, 33: 21394-21405.
[17] Tchaye-Kondi J, Zhai Yanlong, Shen Jun, et al. Adaptive period control for communication efficient and fast convergent federated learning[J]. IEEE Transactions on Mobile Computing, 2024, 23(12): 12572-12586.
[18] Zhang Weishan, Zhou Tao, Lu Qinghua, et al. FedSL: a communication-efficient federated learning with split layer aggregation[J]. IEEE Internet of Things Journal, 2024, 11(9): 15587-15601.
[19] Pei Jiaming, Li Wei, Mumtaz S. From routine to reflection: pruning neural networks in communication-efficient federated learning[J]. IEEE Transactions on Artificial Intelligence, 2025, 6(11): 2896-2905.
[20] Deng Yongheng, Lyu Feng, Xia Tengxi, et al. A communication-efficient hierarchical federated learning framework via shaping data distribution at edge[J]. IEEE/ACM Transactions on Networking, 2024, 32(3): 2600-2615.
[21] Bubeck S. Convex optimization: algorithms and complexity[J]. Foundations and Trends® in Machine Learning, 2015, 8(3/4): 231-357.
[22] Karimireddy S P, Kale S, Mohri M, et al. SCAFFOLD: stochastic controlled averaging for federated learning [C]//International Conference on Machine Learning, Vienna, Austria, 2020: 5132-5143.
[23] Fallah A, Mokhtari A, Ozdaglar A. Personalized federated learning: a meta-learning approach[J]. arXiv preprint arXiv, 2002: 07948, 2020.
[24] Yu Hao, Jin Rong, Yang Sen. On the linear speedup analysis of communication efficient momentum SGD for distributed non-convex optimization[C]//International Conference on Machine Learning, PMLR, California, USA, 2019: 7184-7193.
[25] Jiang Yuang, Wang Shiqiang, Valls V, et al. Model pruning enables efficient federated learning on edge devices[J]. IEEE Transactions on Neural Networks and Learning Systems, 2023, 34(12): 10374-10386.
[26] Li Guanzheng, Li Bin, Li Chao, et al. Battery state of charge probabilistic estimation using natural gradient boosting[J]. IEEE Transactions on Industrial Electronics, 2023, 71(9): 10636-10646.
[27] 全睿, 程功, 周宇龙, 等. 基于增强型鲸鱼优化算法CNN-BiGRU-AT模型的燃料电池衰退预测[J]. 电工技术学报, 2025, 40(19): 6342-6358. Quan Rui, Cheng Gong, Zhou Yulong, et al. Enhanced whale optimization algorithm-based CNN-BiGRU-AT model for aging prediction of fuel cell[J]. Transactions of China Electrotechnical Society, 2025, 40(19): 6342-6358.
[28] Shirin Y. 2011-2017-load: Electricity load datasetof areas in Alberta, Canada for 2011-2017[EB/OL]. Hugging Face, (2024-10-15)[2025-10-16]. https://huggingface. co/datasets/ShirinYamani/2011-2017-load.
[29] Bensalah M, Hair A, Rabie R, et al. High-resolution smart meter load dataset collected from multiple cities in Morocco[J]. Data in Brief, 2025, 62: 112067.
[30] Muehlenpfordt J. Time series: Load, wind and solar, prices in hourly resolution[EB/OL]. Open Power System Data, (2020-10-06)[2025-10-15]. https://data. open-power-system-data.org/time_series/2020-10-06.
Abstract With the continuous growth of electricity demand, high-precision ultra-short-term load forecasting plays a vital role in improving grid dispatching efficiency, enhancing operational flexibility, and ensuring the reliability of power supply. However, due to the data island problem, individual power suppliers typically have access to only limited user load data, making it difficult to effectively conduct data-driven load forecasting and thus significantly restricting forecasting accuracy. Although centralized data aggregation by power companies can partially alleviate this issue, the growing emphasis on data security has introduced strict regulatory constraints on centralized data collection. Moreover, the potential risk of data leakage during the transmission of critical equipment data remains a crucial concern. Federated learning (FL) provides an effective solution to the data island problem by enabling cross-domain collaboration through distributed joint modeling under the principle of data locality, thereby avoiding both the risk of data leakage during transmission and the high storage costs associated with centralized data collection. Nevertheless, existing FL frameworks often overlook the communication costs incurred during parameter exchanges between clients and the central server throughout the training process. Furthermore, they fail to fully account for the data heterogeneity among clients during global model aggregation, resulting in slow convergence and limited generalization performance.
To address these challenges, this paper proposes a low-communication-cost tensor decomposition-based personalized federated learning method for ultra-short-term load forecasting. The proposed approach aims to achieve efficient and robust distributed forecasting while ensuring data privacy and security. Firstly, a novel tensorized local model based on tensor decomposition is designed to extract and compress spatiotemporal features, thereby enhancing the representational capacity of model parameters and reducing communication costs during FL training. Secondly, a dual-loss optimization framework is constructed to alternately optimize the personalized model and the tensorized local model, constraining their distance to decouple personalized optimization from global model learning. Finally, leveraging the tensor characteristics of model parameters, an efficient personalized FL training strategy and an integrated tensor aggregation mechanism are developed to achieve efficient model training and aggregation, thereby improving the generalization capability of the global model.
To systematically evaluate the comprehensive performance of the proposed model, a series of multi-dimensional comparative experiments were conducted. Firstly, pFedACT was compared with several state-of-the-art federated learning methods in the field of power load forecasting to assess its capability in capturing the spatiotemporal variability of load data. Secondly, the predictive performance of pFedACT was compared with that of centralized modeling approaches to evaluate its learning effectiveness under privacy-preserving conditions. Thirdly, the model’s robustness was verified across four dimensions: data imbalance, temporal granularity, load diversity, and scenario variability. Next, a convergence analysis is conducted from two perspectives, namely convergence stability and convergence efficiency, to evaluate the algorithm’s behavior during training. Then, by comparing the performance of the global model and personalized models under heterogeneous client data distributions, the generalization ability of pFedACT was examined. Subsequently, the effectiveness of the proposed method in distributed modeling was then validated by comparing the performance differences between various base models trained in centralized settings and within the pFedACT framework. Furthermore, experiments with varying numbers of clients were conducted to evaluate the model’s feasibility and scalability across diverse power system scenarios. Finally, a detailed communication cost analysis was performed to quantify the advantages of pFedACT in terms of communication efficiency.
Extensive simulation results demonstrate that the proposed method not only achieves rapid model convergence but also exhibits excellent robustness and generalization capability across power system datasets under various operating conditions. Meanwhile, it enhances prediction stability and reduces communication costs during the training process. The simulation analysis leads to the following conclusions: (1) The proposed pFedACT employs a dual-loss function to impose regularization between the personalized model and the tensorized model, thereby enhancing the model’s adaptability to diverse load scenarios and significantly improving both robustness and convergence speed. (2) The tensor decomposition and integrated tensor aggregation strategies strengthen the model’s spatiotemporal representation ability, enabling superior generalization performance under non-independent and identically distributed data conditions. (3) Compared with baseline federated learning methods, pFedACT reduces communication costs by approximately 32.23%, and this advantage becomes increasingly prominent as the number of clients grows or the model complexity increases.
keywords:Federated learning, tensor decomposition, personalized learning strategy, low communication cost, load forecasting
DOI: 10.19595/j.cnki.1000-6753.tces.251325
中图分类号:TM743
国家自然科学基金(52207130)和江西省自然科学基金(20253BA C260014)资助项目。
收稿日期 2025-07-26
改稿日期 2025-10-25
罗光浩 男,1995年生,博士研究生,研究方向为人工智能技术在新型电力系统的应用。E-mail:luoguanghao@tju.edu.cn
崔明建 男,1987年生,教授,博士生导师,研究方向为电力系统运行控制、电力系统优化运行、电力系统数据分析等。E-mail:mjcui@tju.edu.cn(通信作者)