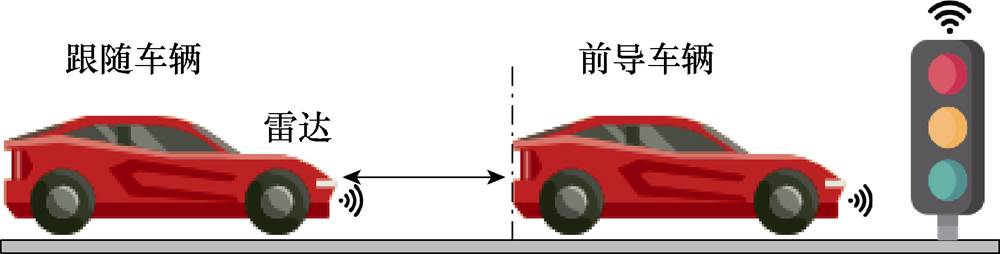
图1 跟车驾驶场景
Fig.1 Car-following driving scenario
摘要 针对电动汽车在城市路况智能驾驶时面临的能耗高、续航受限及驾驶舒适性不足等问题,该文提出一种基于环境感知的主动强化学习能效优化方法,通过对环境具身感知、实时交互与在线训练,实现节能控制策略的主动进化。首先,提出基于环境模型的城市路况感知框架,通过与环境交互学习逐渐感知环境、理解环境、提取特征,实现对高维路况信息的低维表征。其次,建立节能控制马尔科夫决策模型,并映射到深度强化学习框架实现数据驱动训练。对强化学习软演员-评论家(SAC)算法进行改进,使用孪生分布式值函数以缓解Q值过高估计以增加训练效果。最后,将主动学习与强化学习结合,通过结合KL(Kullback-Leibler)散度的样本选择策略实现对困难状态样本的采样,并通过定时离线策略训练,不断优化策略,增加系统的稳定性及收敛速度。通过CARLA平台进行验证,所提方法能够有效地提取城市路况的环境特征,且在主动学习框架下模型的收敛速度显著增加,同时在循环工况中汽车的能耗、荷电状态(SOC)以及电池容量下降率均显著降低,有效地提高了能效优化效果。
关键词:电动汽车 深度强化学习 环境感知 能效优化 主动学习 软演员-评论家(SAC)算法
近年来,电动汽车(Electric Vehicle, EV)凭借其零排放和高能量转换效率[1-4]实现了快速发展[5-7],并逐渐成为城市交通中智能驾驶的主流选择。然而,随着电动汽车在城市交通中的广泛应用,复杂的交通环境对其能效表现提出了更高的要求。首先,城市道路的动态特性,如频繁启停和低速行驶,会导致电机频繁切换工作状态,增加电能消耗。其次,城市交通中的不确定因素,如实时路况变化、行人干扰和突发拥堵,进一步加剧了能耗的不稳定性。此外,电动汽车的电池容量有限,频繁的能耗波动不仅缩短续航里程,还可能增加车主的“里程焦虑”,从而限制其在城市中的推广应用。最后,通过实时能耗优化,电动汽车可与智能交通信号、车联网等实现高效协同,提升了单车能效,同时也有助于缓解城市交通拥堵,提高整体交通系统的运行效率。因此,开发高效的节能技术,通过智能化手段优化能量管理,不仅是提升电动汽车实用性和用户接受度的迫切需求,而且在交通效率和能源管理等多个社会价值维度上具有重要意义。
在城市驾驶场景中,复杂多变的环境与交通因素要求电动汽车能够从高维感知数据中有效提取有助于能效优化的特征信息,从而实现能效控制策略的优化。表征学习[8]能够基于数据驱动机制,自动学习具有物理意义和判别能力的潜在特征。将表征学习方法与能效优化策略相结合,可有效实现城市路况下电动汽车的实时能效控制,提升整体节能效果。早期的表征学习研究主要集中于将表征学习作为辅助任务,通过多任务学习来增强表征的丰富 性[9-12]。然而,这类任务通常依赖先验经验,难以应对环境的动态变化。为此,研究者逐步将表征学习与马尔可夫决策过程的结合作为研究重点,以应对这一挑战。文献[13]提出了一种基于TD7算法的方法,通过在低维状态输入任务中学习状态-动作表征,构建了状态与动作间的交互框架,从而进一步提升了强化学习算法的性能。文献[14]提出了面向控制的时间对齐(Temporal Alignment for Control, TACO)算法框架,将对比学习引入强化学习中,从而同时学习状态和动作的表征。文献[15]则是使用一种基于潜变量模型的方法,通过优化一个目标函数,使得学习到的潜在空间既能够预测奖励,又能够预测未来潜在状态,从而提高策略学习效率。然而,该方法学到的潜在特征是连续的高维向量,缺乏可解释性且泛化能力不足。此外,上述表征学习方法普遍存在计算开销较大的问题,制约了整体计算效率的提升。
电动汽车能效优化的主要实现方式可以分为三类:基于规则、基于优化和基于学习[16-18]。基于规则的方法可以分为确定性规则与模糊逻辑规则,具有结构简单、逻辑明确、响应快速的优点。虽然基于规则的方法能够较快地计算出控制决策,但其适应性和灵活性有限,难以实现全局最优的能效优化效果。基于优化的方法可以分为全局优化和局部优化,通过优化算法求解能效优化问题,能够获得接近全局最优的控制策略,从而提升整车的能效表现。然而,由于其计算过程的复杂性,在面对快速变化的城市驾驶环境时,实时性较差,应用受到约束。
随着人工智能与机器学习技术的迅速发展[19-21],基于学习的能效优化方法开始受到广泛关注[22-24]。其中,深度强化学习(Deep Reinforcement Learning, DRL)以其能够处理高维、连续的状态和动作空间,并适应复杂多变工况的优势,逐渐成为了城市中EV能效优化问题的最优策略[25-26]。文献[27]提出一种基于改进TD3算法的混合动力汽车节能驾驶方法,通过多经验回放机制提高训练效率与泛化能力。然而,该方法中算法训练过于复杂,依赖高算力支持,在实际工况下难以获得全局最优解。文献[28]提出了一种基于全球速度优化和道路坡度适应的电动汽车增强型分层生态驾驶控制方法,通过动态规划与强化学习相结合的方法完成分层控制,实现节能驾驶。然而,该方法对训练时间和数据要求过高,在实际应用中可能会受到环境变化的影响。文献[29]提出一种深度融合交通信息的网络物理系统,构建由网络层和物理层组成的协同框架以提高能效经济性。然而,该方法泛化能力较差,仅验证单车道多信号灯路况,未设计城市交通中更复杂的跟车以及拥堵场景。此外,在现有城市路况EV能效优化的研究中,较少有将环境感知方法与强化学习相结合的探索,导致智能体难以根据动态外界环境实时调整节能策略。
综上所述,虽然现有基于DRL的电动汽车能效优化方法有很多优点,但受限于收敛速度较慢,计算开销过大等问题,同时结合环境感知的研究较少,无法达到最优的能效优化效果。同时,现有基于马尔科夫决策的表征学习方法在面对城市复杂环境时往往会出现一定的不稳定性和泛化性差的问题。基于以上分析,本文提出融合环境感知与强化学习的电动汽车节能优化控制方法,具体工作和创新点 如下:
(1)构建了基于环境模型(World Model, WM)的城市路况环境感知模块,通过对比学习与耦合强化学习联合训练,实现对城市高维交通信息的低维高效表征,使感知过程直接服务于能效优化目标。
(2)提出基于环境感知的孪生分布式值函数软演员-评论家(Soft Actor-Critic, SAC)改进算法,通过分布建模与双Q网络相结合有效抑制Q值过高估计现象,提升了算法在复杂城市工况下的收敛速度与策略稳定性。
(3)提出了深度融合强化学习的主动学习框架,将基于KL散度预测的主动学习机制与改进的SAC算法有机结合,构建了双分布式软演员-评论家主动学习(Twin Distributional Soft Actor-Critic Active Learning, TD-SAC-AL)算法。通过在Actor网络各层附加KL散度预测网络,实现对困难样本的精准筛选与优先训练,从而显著提升样本利用效率与策略的持续进化能力。
在城市路况行车环境下,电动汽车需频繁应对复杂动态的交通状况,尤其是在跟车、交通拥堵以及交通信号灯等典型场景中。此类场景常常引发频繁的停车-启动模式,迫使车辆持续调整车速以维持安全车距,进而显著增加了能耗。
(1)跟车场景如图1所示:跟车场景是城市道路驾驶环境中最为常见的路况之一,前导车辆的行为对后方跟随汽车的能耗产生影响。若前导车辆不稳定,跟随车辆需频繁调整速度,从而造成能量损失。相反,跟随的电动汽车若能够提前预判前车运动趋势,通过D档滑行或匀速驾驶保持稳定安全车距,减少急加速和急刹车操作,则能提升整体驾驶能效。因此,能效优化在跟车场景下需要提前预判前车运动趋势和交通路况,提前采取最优驾驶策略,尽可能地减少急加速和急减速事件的发生,使车辆运行更为平稳且节能。
图1 跟车驾驶场景
Fig.1 Car-following driving scenario
(2)交通拥堵场景:交通拥堵作为城市道路典型低效场景,具有车速波动大、启停频繁及路况不确定性等特点。在此工况下,电动汽车能效显著下降,主要原因包括:①驶入拥堵路段后,频繁的启停使驱动系统不断进行动能重构,导致大量能量在制动与加速过程中以热能形式被耗散;②智能驾驶系统在对前方拥堵路段进行预判并作出响应时,所采取的减速、变道等规避策略可能因路径变更而导致行驶距离或时间增加,从而进一步提高单位能耗。因此,优化策略应聚焦于两方面:一是精确感知识别交通流状态,在不可避免的拥堵中采用D档滑行或匀速控制策略,减少误判动作,降低高频操作带来的能耗波动;二是通过感知分析前方车流路况与交通信号灯变化,预测前方堵点情况,提前采取 措施。
(3)交通信号灯场景(如图2所示):除跟车与交通拥堵外,交通信号灯控制也是城市道路中极为常见的驾驶场景。车辆在接近路口时需根据灯色变化调整行驶状态,从而扰乱行驶连续性并增加能耗。
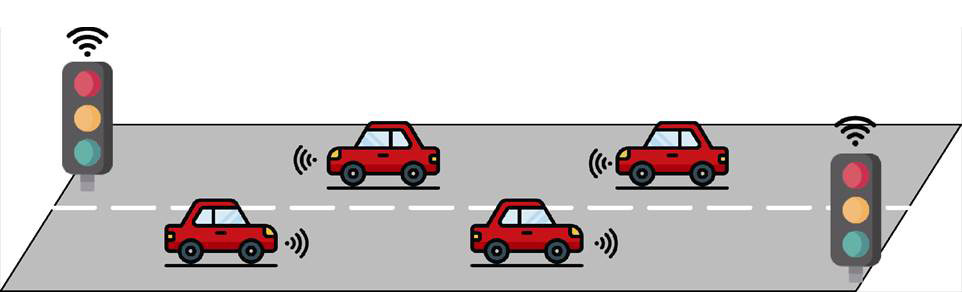
图2 交通信号灯驾驶场景
Fig.2 Traffic light driving scenario
交通信号灯转换为红灯期间,车辆需减速、停止并等待,制动过程中的急刹车导致动能的大量损耗。信号转绿后,车辆重新起步需克服静止惯性,电机短时内输出高功率,造成显著电能消耗,特别在荷电状态(State of Charge, SOC)较低或启停频繁时表现得更为明显。黄灯状态则因持续时间短、决策窗口窄而引发较大不确定性。车辆常在加速通过与紧急制动之间徘徊,易导致非连续的控制模式,如加速—减速—再启动等行为,进而放大加速度波动与能量损耗。综上所述,交通信号灯控制场景下的能耗主要来源于信号变化引发的加减速波动与策略不确定性。能效优化策略的关键在于增强电动汽车对信号变化的感知与预测能力,降低不必要的启停频率,从而优化城市驾驶过程中的整体能量利用效率。
通过对上述三类典型城市交通场景的分析与解构,可以看出电动汽车在城市路况环境下具有较大的节能增效空间,节能控制策略的优化潜力十分可观。其能效优化控制机理如图3所示。车辆通过驾驶场景信息以及车内状态信息作为输入,由强化学习智能体进行决策,智能体输出控制指令作用于车辆动力系统,从而实现对车辆运行状态的调节,达到提升能效的控制目标。
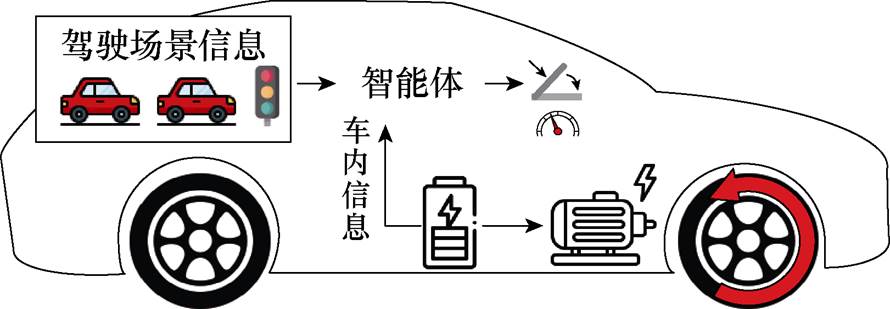
图3 能效优化操控示意图
Fig.3 Illustration of energy-efficient control
基于以上场景分析,本文提出一种基于环境感知的主动强化学习能效优化框架,旨在最大程度地实现电动汽车在城市路况下智能驾驶的节能效果。
能效优化整体框图如图4所示。图4中,ot、ot+1、zt、zt+1为t时刻以及t+1时刻的观测状态及潜在状态,at为动作, 为编码器,T为环境模型。该框架由环境感知模块、强化学习模块以及主动学习模块共同组成。环境感知模块负责对城市路况进行实时观测与感知,通过表征学习将高维观测状态ot压缩为低维路况特征表示zt。强化学习模块在深度强化学习框架下完成策略优化,而主动学习模块则通过困难样本优先回放实现节能控制策略的持续迭代更新。在实际车辆部署中,所提算法框架将布局于车辆中央域控制器的决策规划层,上游接收环境感知模块输出的低维表征状态zt,下游直接输出连续加速度指令at,交由底层线控执行机构执行,以实现能效优化控制。在工程实现层面,能效优化策略所生成的纵向控制指令在实际执行过程中需受到动力电池管理系统(Battery Management System, BMS)对电池电流、电压及瞬时功率等安全约束的实时限制。BMS负责对电池荷电状态、温度及健康状态等关键运行指标进行监测与管理,并在必要时对功率输出进行限幅或调整,以保证动力电池系统的安全性与可靠性。能效优化策略则通过优化上层驾驶决策过程,减少不必要的功率波动与能量损耗,从而在系统层面间接改善电池的运行工况。通过这种分层控制与约束反馈机制,所提方法可与现有BMS架构实现自然兼容,在不改变底层安全控制逻辑的前提下,实现整车能效与电池安全之间的协同优化。
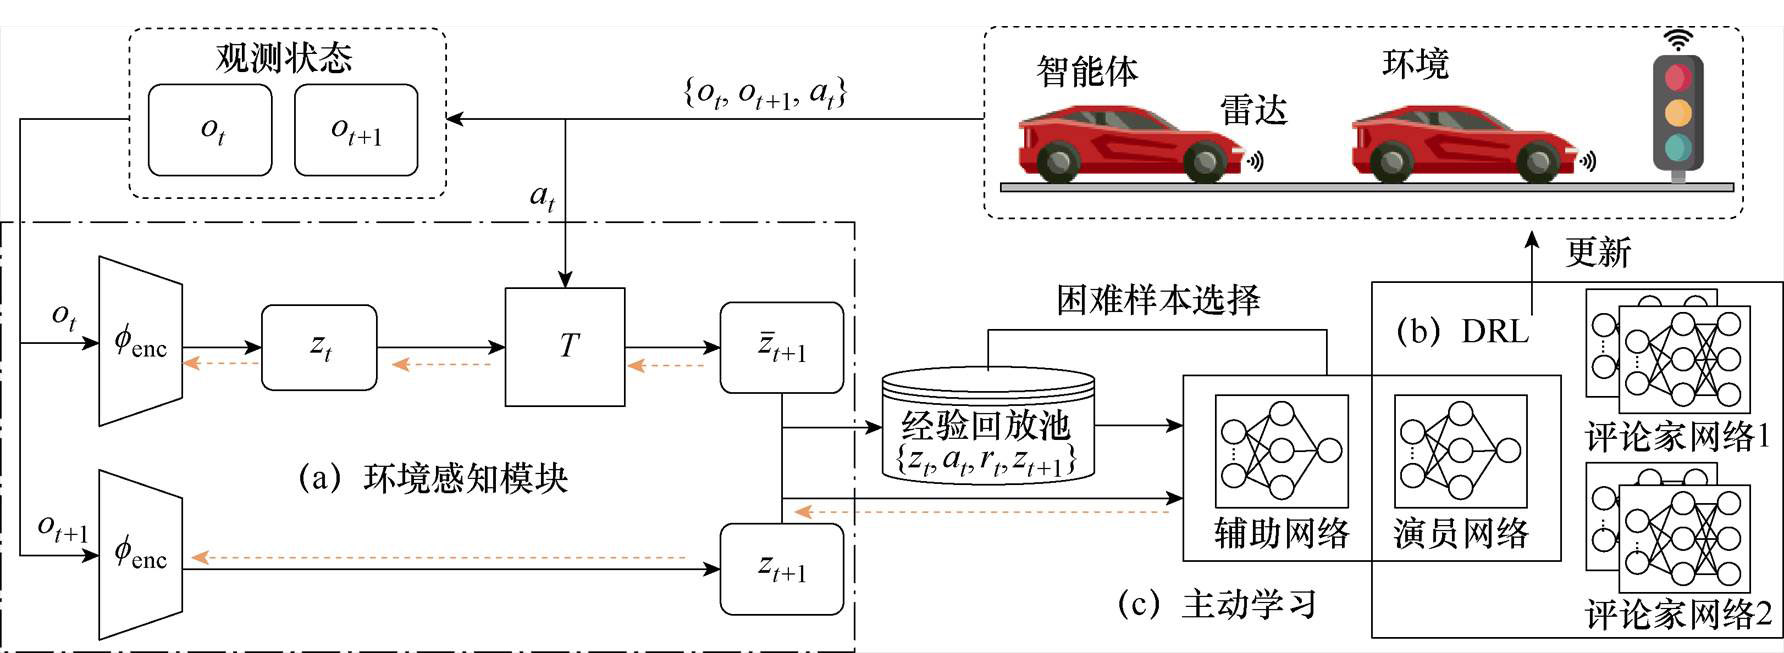
图4 能效优化整体框图
Fig.4 Overall block diagram of energy-efficient optimization
本文将电动汽车智能驾驶的能效优化决策问题建模为一个马尔科夫决策过程(Markov Decision Process, MDP)即MDP=(S, A, P, R),其中,S为状态空间,表示车辆感知到的环境信息以及车内系统信息;A为动作空间,用于控制汽车在不同路况环境中的驾驶行为;P为状态转移概率,表示环境对当前驾驶动作的响应;R为奖励函数,表示能效优化目标导向的奖励。在MDP框架下,智能体通过累计状态s所能获得的最大期望回报实现最优能效优化策略,即
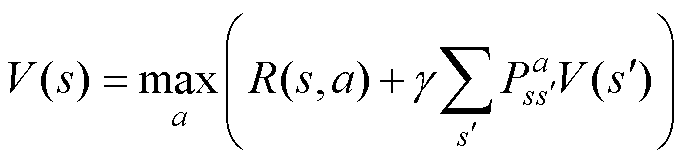 (1)
式中,V(s)为最优价值函数,表示从状态s开始执行策略后能获得的最大期望回报; 为折扣因子,用于控制未来奖励的重要性;
 表示下一时刻的状态。动作a在最优策略下获得的最大期望回报为
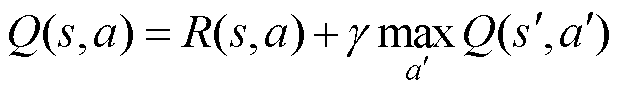 (2)
式中,Q(s, a)为最优Q值函数,表示在状态s下执行动作a后,按照最优策略执行后续动作所能够获得的最大期望回报。根据时间差分方法反复迭代更 新为
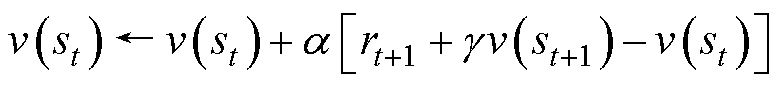 (3)
式中,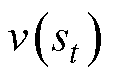 为当前状态st的价值估计状态值函数,表示在t时刻状态s的当前价值;
 为即时奖励,
表示在时刻t执行动作后,到达下一时刻获得的奖励; 为学习率,用于控制更新幅度的大小收敛至最优值函数。最终,系统生成能效优化策略,实现城市路况下智能驾驶的节能控制目标。
城市驾驶环境复杂且多变,传统的特征提取方法难以有效捕捉其内在规律,为此,本文构建深度耦合强化学习的城市路况感知模块,使用对比学习与耦合强化学习的方法进行联合训练,具体流程 如下:
1)对比学习训练
对比学习训练如图5所示,模型主要由环境模型T和编码器两部分组成。
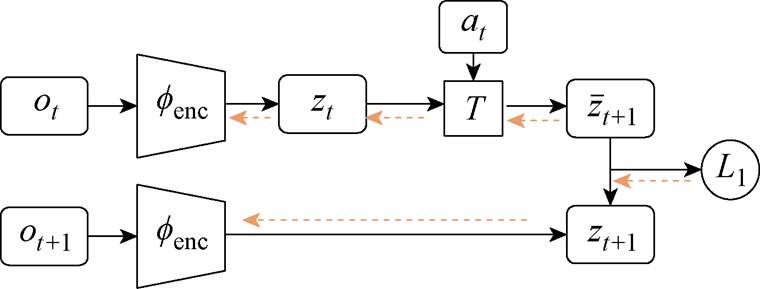
图5 对比学习训练
Fig.5 Contrastive learning training
环境模型旨在将复杂的外部环境映射为抽象表示,从而在给定当前时刻状态zt和动作at条件下预测下一时刻响应状态。编码器则将ot映射到潜在空间,转化为低维度高信息量的潜在状态,以实现高维信息向低维潜在表示的压缩映射。
随后,基于能效优化的目标,编码器将zt和智能体t时刻的动作at共同输入环境模型T中以学习潜在状态的动态状态转移关系,从而预测出下一时刻的潜在状态 。同时,下一时刻的观测状态ot+1也被输入编码器进行映射转化,生成低维状态zt+1。借助损失函数L1以使zt+1与之间的差距最小化,通过反向传播算法完成对编码器参数的优化更新。L1设置为
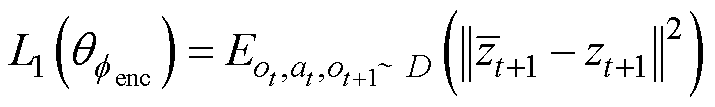 (4)
2)耦合强化学习训练
在对比学习完成初步训练后,为进一步增强模型对环境不确定性和动态路况的感知能力,本文引入了一种深度耦合强化学习的训练范式,通过梯度流动机制,将环境感知模块与强化学习策略优化过程进行端到端整合,实现模型的协同优化,耦合强化学习训练如图6所示。
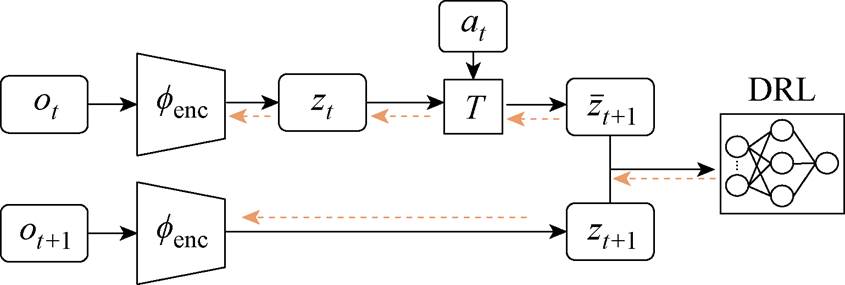
图6 耦合强化学习训练
Fig.6 Coupled reinforcement learning training
价值网络评估Q值,通过反向传播强化学习损失的梯度来同步更新环境感知模块参数,即
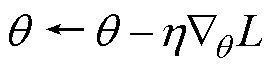 (5)
式中, 为模型参数;
 为学习率;
 为参数的梯度;L为强化学习总损失函数。这种梯度流动机制能够促使潜在表征zt逐步优化为能效导向的特征,提升训练稳定性、探索效率和泛化能力。
强化学习建模的实质就是将电动汽车智能控制及与环境交互过程映射到马尔科夫决策模型,为智能体优化策略、探索多样性提供一个清晰、可控的框架,状态拼接如图7所示。首先,为实现环境路况与行车状态统一表征,模型将外部路况信息与车内驾驶数据进行融合,形成统一的观测状态ot,随后,表征学习模块将该高维观测映射为紧凑的低维状态表示zt,并将其作为强化学习框架中的状态空间输入,得
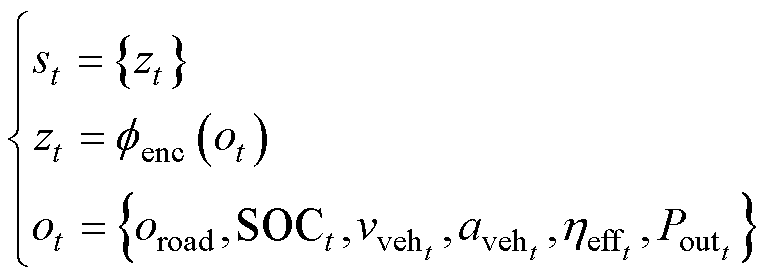 (6)
式中,ot包括车外路况状态oroad以及电池SOCt、输出功率 、电动汽车行驶速度
 、加速度
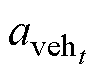 、电机效率
 在内的车内驾驶状态。
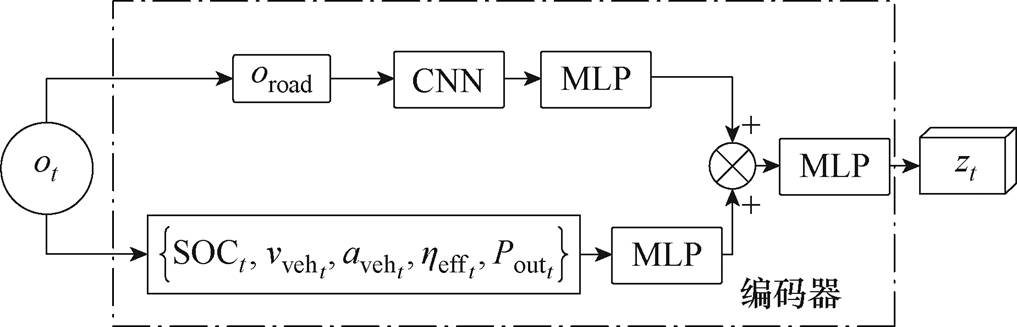
图7 状态拼接
Fig.7 State concatenation
电动汽车动力变化作用于车辆的直接影响就是车辆加速度,将加速度变化量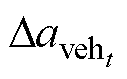 设置为本文的动作空间A,其范围为-1~1 m/s2。
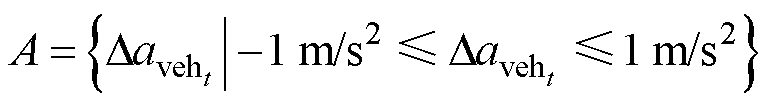 (7)
为稳定训练提升学习效果,对状态空间和动作空间做归一化处理,使其数值范围相似。
为了使能效优化策略达到最优,智能体的核心目标为在保证驾驶安全性的前提下降低能量消耗,提升能量使用效率。因此本文设置包括能量损耗r1、驾驶舒适性r2、动力系统效率r3在内的总奖励函数R,具体设置如下:
能效优化的目标是减少能量损耗,提升能量使用效率,被赋予最高的奖惩值,即
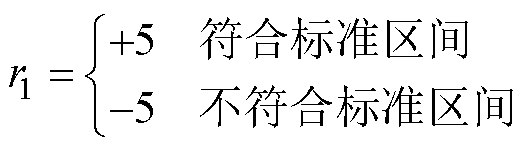 (8)
如果能耗率在设定的标准区间内,智能体获得奖励;如果消耗过高,则给予惩罚。标准区间设置为[130, 170] W·h/km。
为了提升驾驶的舒适性,设计奖励函数r2,鼓励智能体平稳加速或减速,避免过度剧烈的急加速、急刹车。
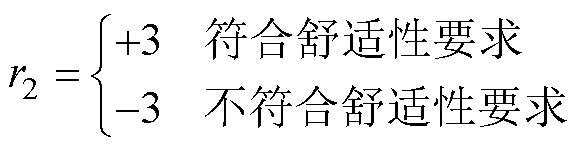 (9)
设定当|Da|≤1.5 m/s2且-2 m/s2<a<2 m/s2时符合舒适性要求。最后,为了防止智能体因过度强调能效而陷入局部最优,设置动力系统效率奖励函数r3为
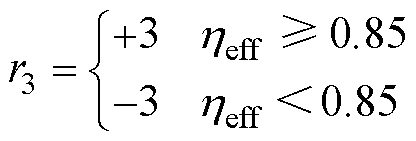 (10)
式中, 为电机效率,当效率高于阈值0.85时给予奖励;反之,则给予智能体惩罚。综上所述,总奖励函数为
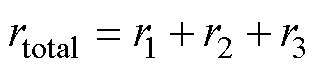 (11)
为了提高智能体探索效率,增强训练稳定性,本文选用强化学习SAC[30-32]来引导智能体实现能效优化策略。算法引入最大熵强化学习的目标函数,鼓励策略在获得高回报的同时保持一定的随机性,从而增强探索能力,完成节能任务。目标函数设计为
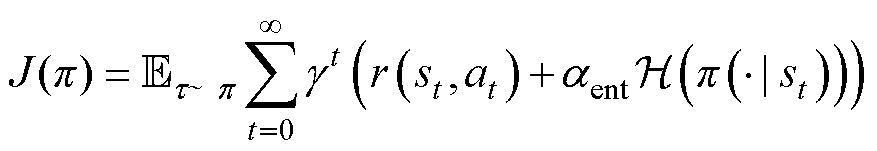 (12)
式中, 为温度参数,用于控制探索与利用的平衡,
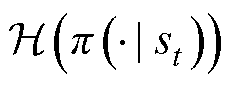 为策略在st下的熵,定义为
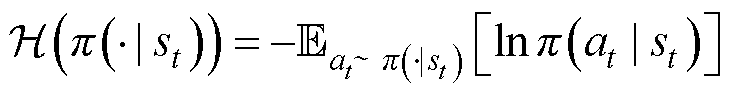 (13)
SAC使用两个Critic网络来估计Q值,通过最小化预测值与目标值之间的方均误差进行更新,损失函数为
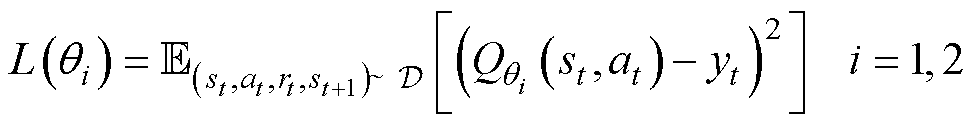 (14)
式中, 表示经验回放池中的数据分布。
Actor网络则通过输出动作分布,并基于最大熵框架更新策略,以最大化期望的回报和动作熵的加权和。
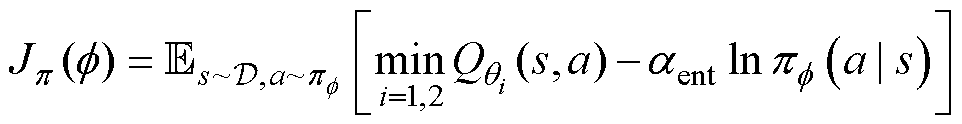 (15)
随后,通过软更新方法更新目标Q值网络的参数,以确保训练过程的稳定性,即
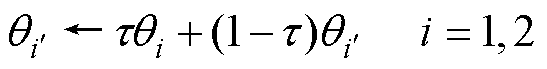 (16)
式中,i=1, 2分别表示两个Critic网络。
在SAC算法的支持下,智能体通过多次迭代更新,逐步完善并形成EV能效优化的最优策略。
在训练过程中,针对SAC算法中存在的Q值过估计导致生成次优策略问题,本文对原有算法进行改进,提出一种孪生分布式值函数SAC(Twin Distributional Soft Actor-Critic, TD-SAC)算法,通过引入分布建模与双Q网络结合以缓解Q值高估问题,并增强策略的鲁棒性。
首先,对Critic网络进行改进,将原本网络输出Q值标量通过高斯分布建模来输出Q值的概率分布,得
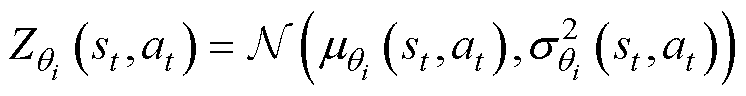 (17)
式中,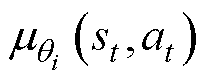 为Critic网络对状态st和动作at的期望Q值;
 为均值,表示Q值的期望;
 为方差,反映不确定性。用目标回报的期望值代替随机目标回报计算均值梯度以减小梯度方差。改进后的目标函数为
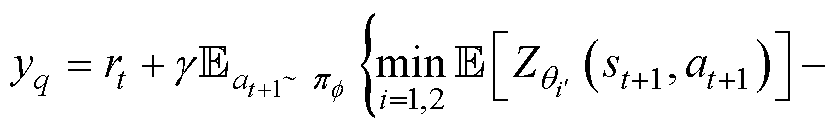
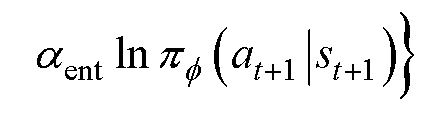 (18)
损失函数为
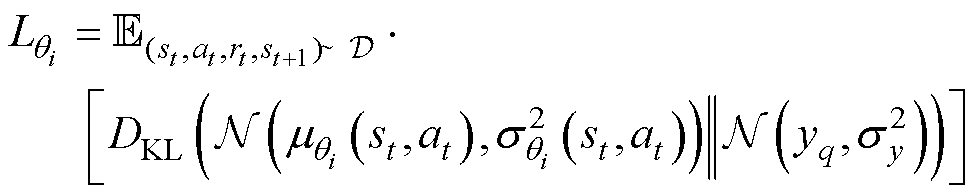 (19)
式中,DKL为两个高斯分布之间的KL散度; 为目标Q值。
为了防止残留过估计导致生成次优策略,使用双值分布网络的结构对Critic网络进行改进。通过选取两个Critic网络高斯分布的均值,选择较小的分布减少高估误差以增强学习稳定性,即
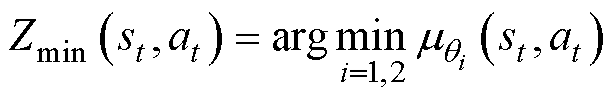 (20)
TD-SAC算法可以显著降低梯度方差,提升学习稳定性,从根本上抑制过估计的问题。算法描述见表1。
主动强化学习的目的是让系统实现自主训练,主动进化。结合强化学习的城市路况感知框架能够获取并感知城市交通环境特征,累积 (s, a, r,  ) 样本离线训练强化学习模型。但是,没有筛选的样本包含大量冗余信息,增加了模型的计算负担,影响训练。针对这一问题,本文提出一种主动强化学习(Active Reinforcement Learning, ARL)模型,框架如图8所示。
表1 TD-SAC算法
Tab.1 TD-SAC algorithm
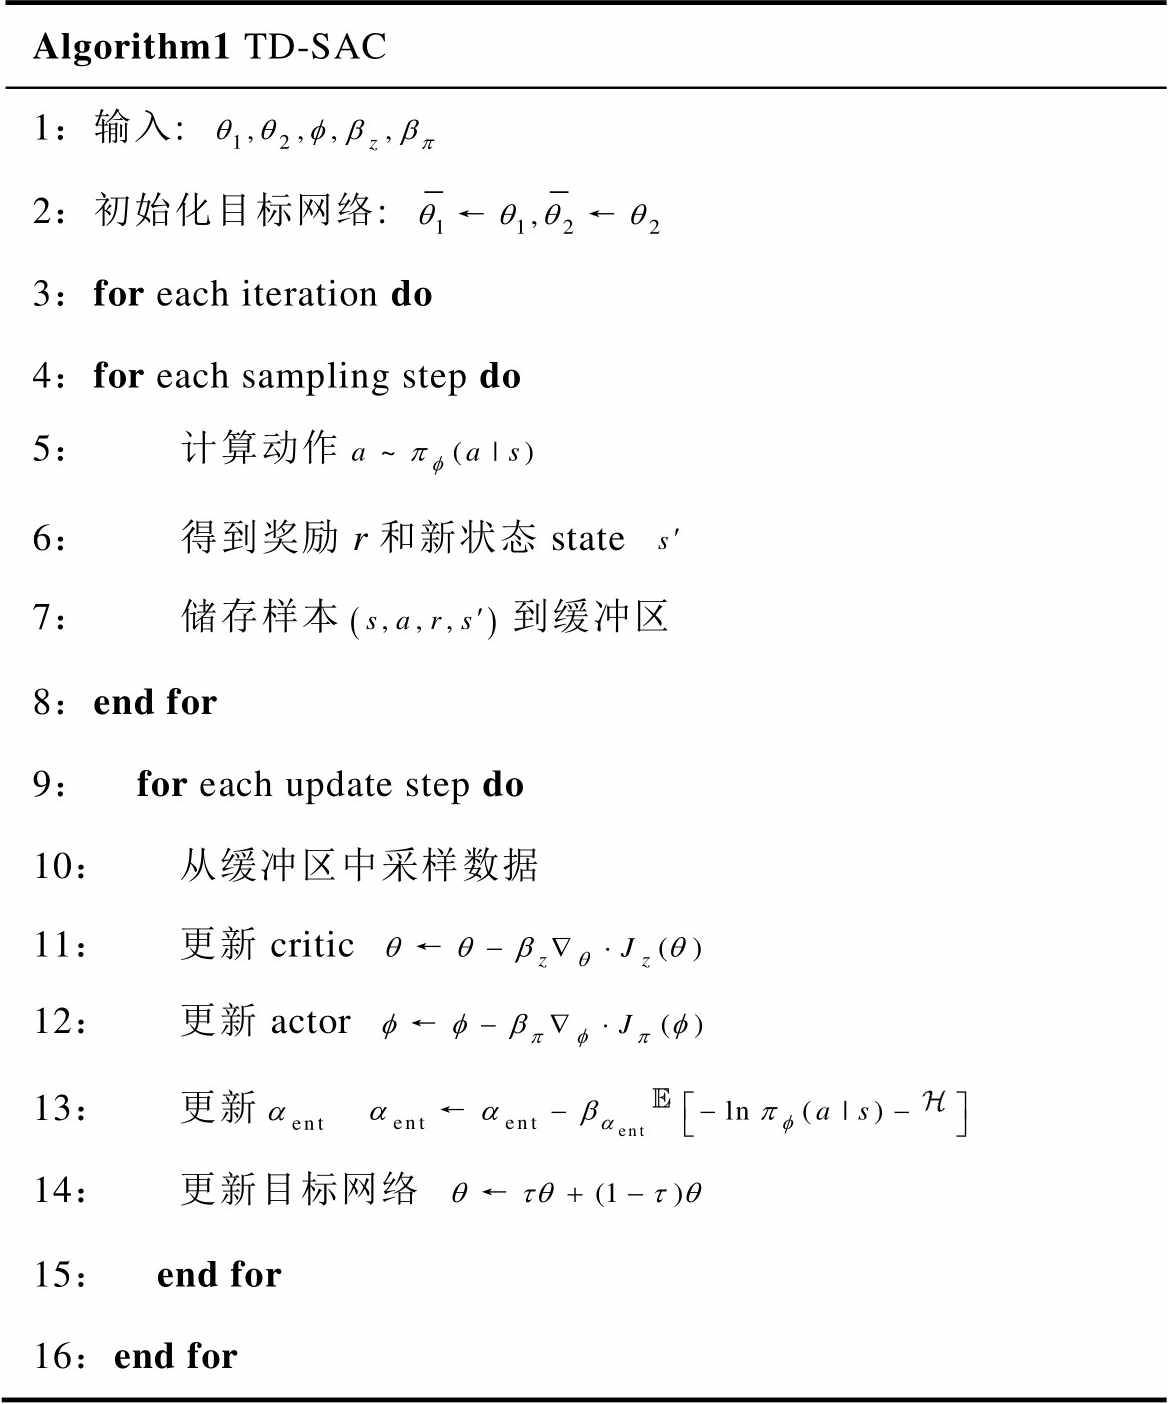
Algorithm1 TD-SAC 1:输入: 2:初始化目标网络: 3:for each iteration do 4:for each sampling step do 5: 计算动作 6: 得到奖励r和新状态state 7: 储存样本到缓冲区 8:end for 9: for each update step do 10: 从缓冲区中采样数据 11: 更新critic 12: 更新actor 13: 更新 14: 更新目标网络 15: end for 16:end for
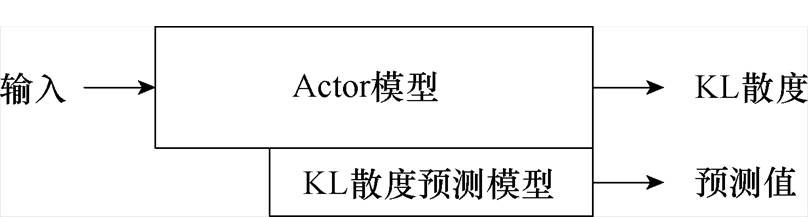
图8 主动强化学习模型
Fig.8 Active reinforcement learning model
该框架由Actor主模型上附加一个基于KL散度预测值进行样本筛选的辅助模型构成。核心目标是通过主动学习策略,优先选取对深度强化学习最具价值的样本,以提升强化学习的训练效果。主模型由SAC算法中的Actor网络构成,以状态样本作为输入。经过多层Actor网络的处理,模型能够输出当前状态下对应的电动汽车控制策略。每一层Actor网络均与KL散度预测模型相连接,以实现对样本KL散度的有效预测,从而辅助识别困难样本。在该框架下,模型能够根据KL散度评分样本的“困难”度,并以此筛选样本放入经验回放池,以供离线强化学习训练。
KL散度是衡量神经网络输出分布与真实标签分布差异的有效指标。其大小受样本特性影响:特征明显、类别清晰的样本通常对应较小的KL散度,表示模型预测与真实分布一致、置信度高。而边界样本、含噪声样本或类别相似样本则容易导致较大的KL散度,反映出较高的不确定性。因此,高KL散度样本可作为识别困难样本的依据。通过分析KL散度的分布,可有效筛选模型预测效果不佳的样本子集,为主动学习提供高质量训练数据。基于此,本文设计了KL散度预测附加模型,通过与主模型进行联合训练,实现对困难样本的有效识别。与传统主动学习方法主要依赖启发式规则从未标注样本中进行选择不同,该模型通过直接估计Actor网络在未标注样本上的KL散度来完成训练,从而实现更高效的样本筛选过程。
KL散度预测模型如图9所示,在主模型中,Actor网络根据采样得到的观测状态输出对应动作的概率分布,并计算其KL散度用于训练附加模型,即
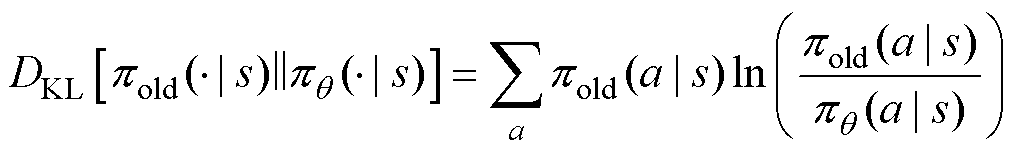 (21)
训练过程中,每个Actor网络层的输出均被输入到对应预测模型的Transformer模块中,通过自注意力机制捕捉其内在关系,对不同的特征分别进行KL散度预测。在预测出每个Actor网络层输出特征对应的KL散度值之后,将其进行拼接以得到最终的KL预测值 。
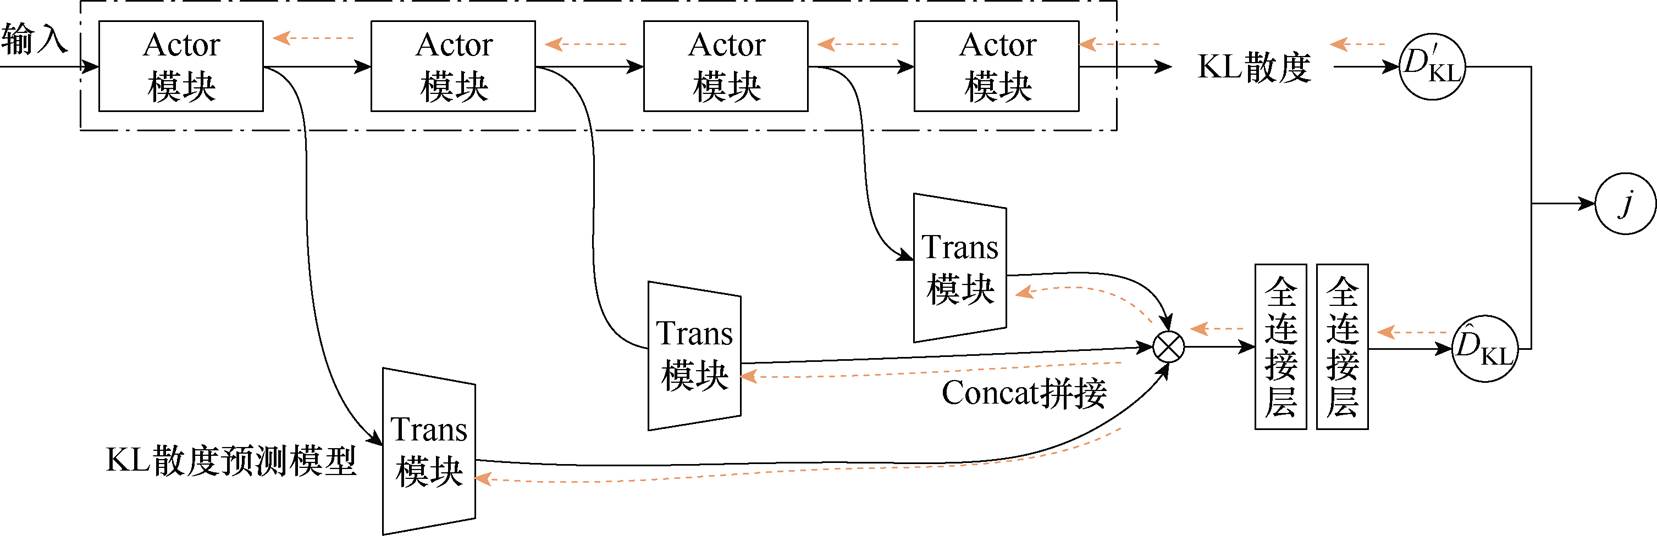
图9 KL散度预测模型
Fig.9 KL divergence prediction model
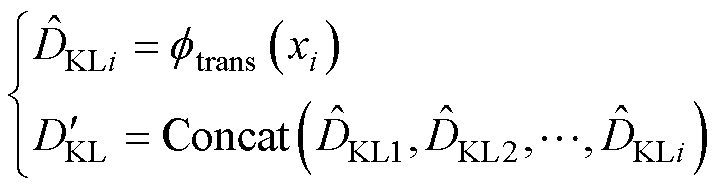 (22)
通过附加模型输出与主模型输出DKL的差值做为损失函数,引导完成附加模型的训练。
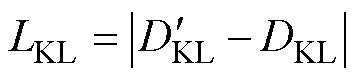 (23)
通过式(21)~式(23),模型实现对不同状态样本对应输出的精准KL散度预测,并以此实现困难样本的选择。主动学习框架的整体优化函数为
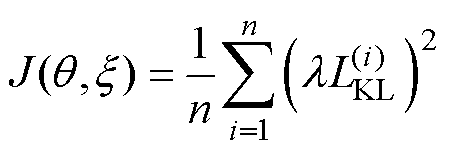 (24)
式中,、 分别为主模型和附加模型的参数;
 为系数,用于调节KL散度对优化的影响强度。
在KL散度预测模型完成训练之后,模型可以对经验回放池中的状态样本数据进行KL散度值估计并排序,选取前10%的样本作为困难样本。
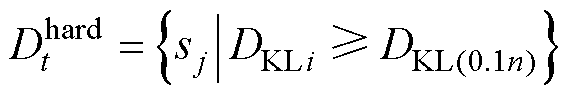 (25)
式中,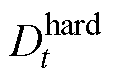 为基于KL散度的困难样本合集。通过使用该困难样本集对经验回放池进行更新,在保留高价值样本的同时有效剔除冗余数据,不仅降低了计算开销,还提升了模型的鲁棒性,加快能效优化策略的收敛速度,从而实现对电动汽车的主动式智能优化控制。
4.1.1 仿真参数设置
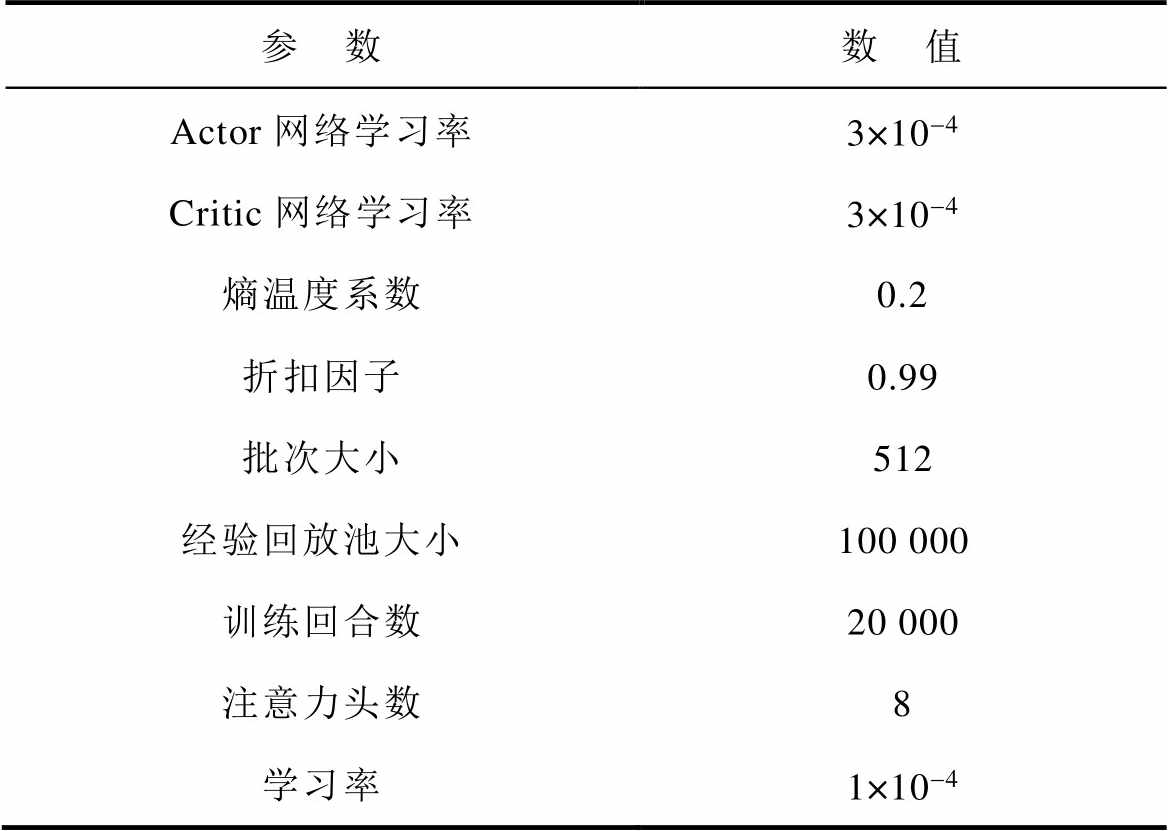
为了进一步验证融合环境感知与主动强化学习的能效优化方法是否达到节能驾驶的效果,本文使用CARLA平台进行仿真。相关的算法网络参数、动力电池单体参数以及电动汽车整车参数见表2~表4。
4.1.2 电动汽车能耗设计
为了验证能效优化效果,进行了能耗系统建模。首先对车辆进行运动学建模得
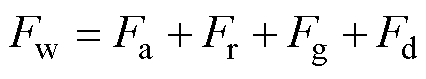 (26)
式中,Fw为车辆总牵引力;Fa为车辆惯性力;Fr为滚动阻力;Fg为坡度阻力;Fd为空气阻力,各项定义为
表2 算法网络参数
Tab.2 Algorithm network parameters
参 数数 值 Actor网络学习率3×10⁻⁴ Critic网络学习率3×10⁻⁴ 熵温度系数0.2 折扣因子0.99 批次大小512 经验回放池大小100 000 训练回合数20 000 注意力头数8 学习率1×10⁻⁴
表3 动力电池单体参数
Tab.3 Power battery cell parameters
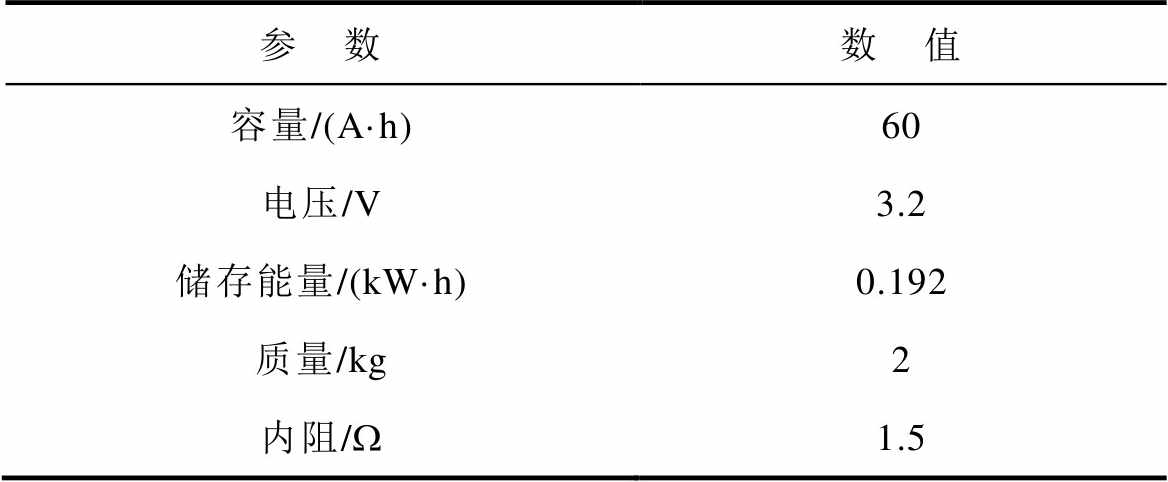
参 数数 值 容量/(A·h)60 电压/V3.2 储存能量/(kW·h)0.192 质量/kg2 内阻/W1.5
表4 电动汽车整车参数
Tab.4 Electric vehicle specifications
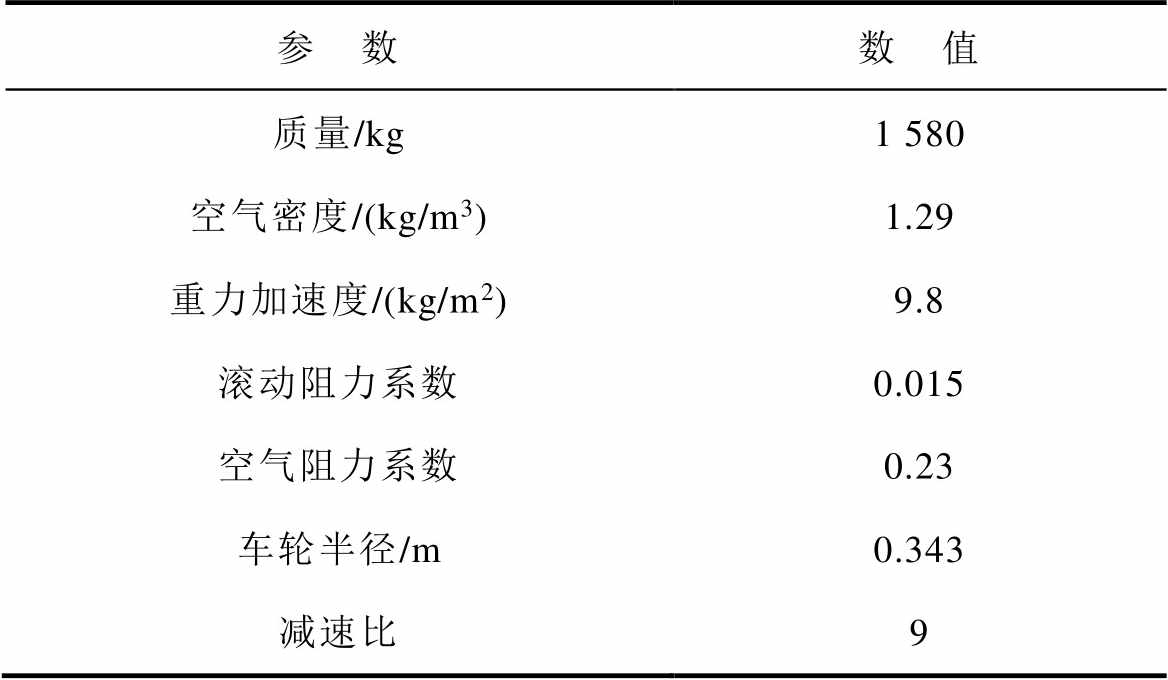
参 数数 值 质量/kg1 580 空气密度/(kg/m3)1.29 重力加速度/(kg/m2)9.8 滚动阻力系数0.015 空气阻力系数0.23 车轮半径/m0.343 减速比9
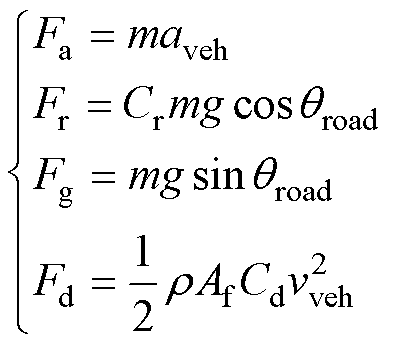 (27)
式中,m为汽车质量; 为汽车加速度;Cr为滚动阻力系数;
 为坡度角;g为重力加速度;
 为空气密度;Af为迎风面积;Cd为空气阻力系数;
 为车速。该模型能够综合反映不同道路坡度、空气扰动以及车辆加速等对功率需求的影响。电机输出功率模型为
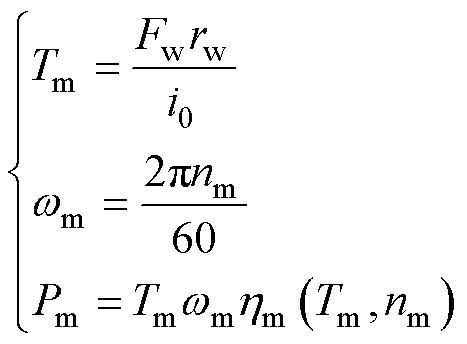 (28)
式中,Tm为电机输出转矩; 为电机角速度;nm为电机转速;rw为车轮半径;i0为整车固定减速比;
 为电机二维效率映射函数。在循环工况下,电动汽车的能耗公式为
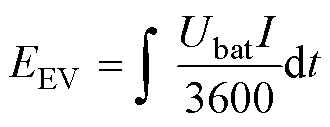 (29)
式中,Ubat为电池端电压;I为电池电流。
节能率可由优化后的能耗与未优化时的能耗的比率差异来表示,即
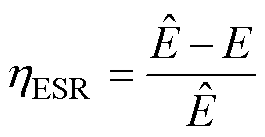 (30)
式中, 为优化前的能耗;E为优化后的能耗。此外,为了保证策略的物理可行性、安全性以及舒适性,本文引入了合理的动力系统约束条件为
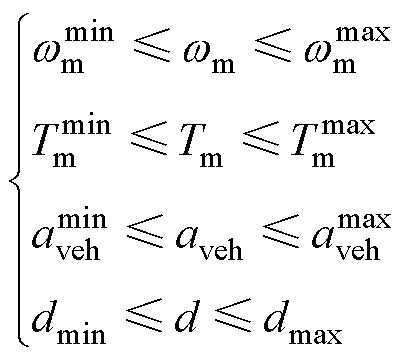 (31)
式中,d为当前车距;上标“min”、“max”分别表示对应变量的最小值及最大值。
4.1.3 工况轨迹设置
为验证城市路况驾驶条件下可以达到节能操控的效果,选择城市道路地图(Town10)进行中国轻型车行驶工况(China Light-duty Vehicle Test Cycle,CLTC)、新欧洲行驶循环(New European Driving Cycle, NEDC)、城市动态驾驶循环(Urban Dynamo- meter Driving Schedule, UDDS)以及全球统一轻型车测试循环(Worldwide Harmonized Light Vehicles Test Cycle, WLTC)循环工况能耗验证仿真。同时为了模拟一个更加真实的场景,即汽车周围随时可能有其他车辆,设置在整个地图上随机分布50辆自动驾驶车辆,并且这些车辆会在整个地图范围内进行随机路线的行驶,测试车辆则按照规定路线分别进行标准工况测试。由于所选工况各具特点,因此本文针对不同工况设计了具有针对性的驾驶轨迹,以更好地适应各自特性,不同工况下的运行轨迹如图10所示。

图10 不同工况下的运行轨迹
Fig.10 Operating trajectories under different working conditions
选用CLTC和NEDC工况来训练智能体,UDDS和WLTC工况来验证训练后的智能体。其中,CLTC为中国轻型汽车测试循环,NEDC侧重于平稳的市区和高速工况,UDDS模拟城市交通拥堵频繁启停,WLTC为全球统一轻型车测试循环,所选工况各有特点。CARLA仿真平台的时间步长设置为0.1 s,智能体在循环工况中每隔0.1 s与环境交互,采样得到事件序列st, at, rt, st+1,并将其保存在经验回放池中。分别使用TD-SAC-AL、TD-SAC、SAC进行20 000个回合的训练来分析模型的收敛性。训练结果如图11所示。从训练过程中的平均奖励表现可以看出,TD-SAC相较于原始SAC算法具有更快的收敛速度和更高的奖励水平,表明其在提升算法收敛性方面具有积极作用。而TD-SAC-AL的波动性更小,在更早的回合就趋于稳定,且其平均奖励明显优于其他算法。表明引入主动学习策略相比于传统的均匀采样策略能够有效提升算法的收敛效率以及样本效率,增强了算法的全局最优策略的搜索能力。
4.3.1 四种工况循环下能耗对比验证
为了验证能效优化策略在不同工况下的节能效果,本文在四种不同工况下分别验证了能耗的变化情况。训练过程实景如图12所示。
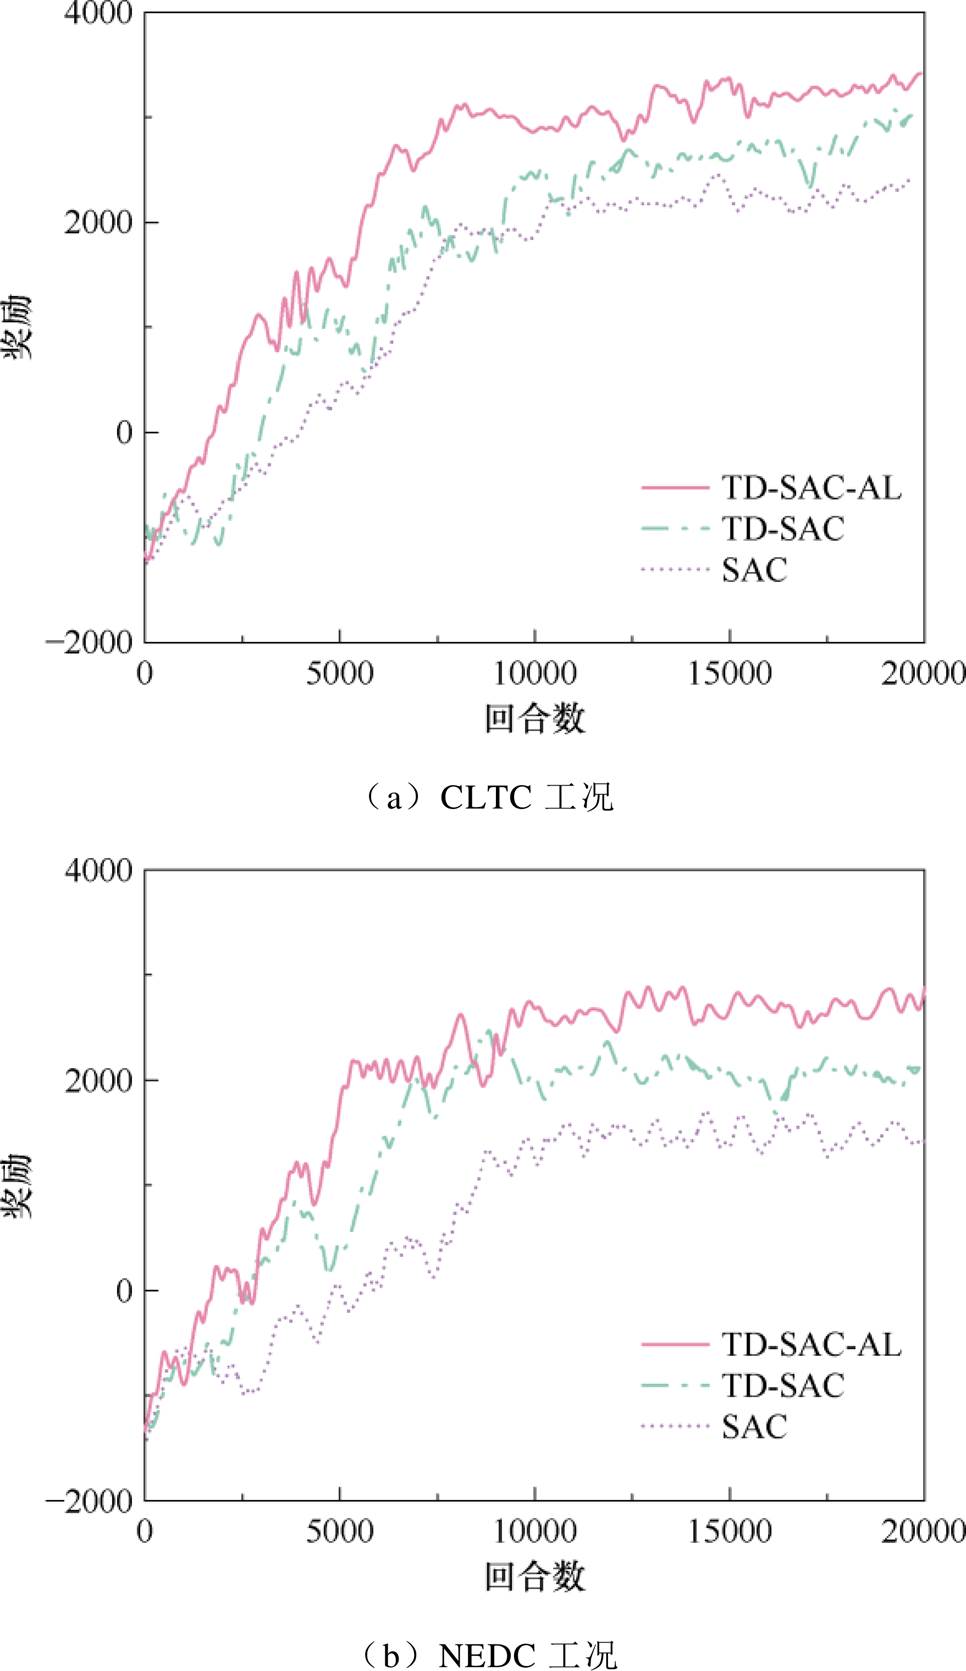
图11 训练结果
Fig.11 Training results
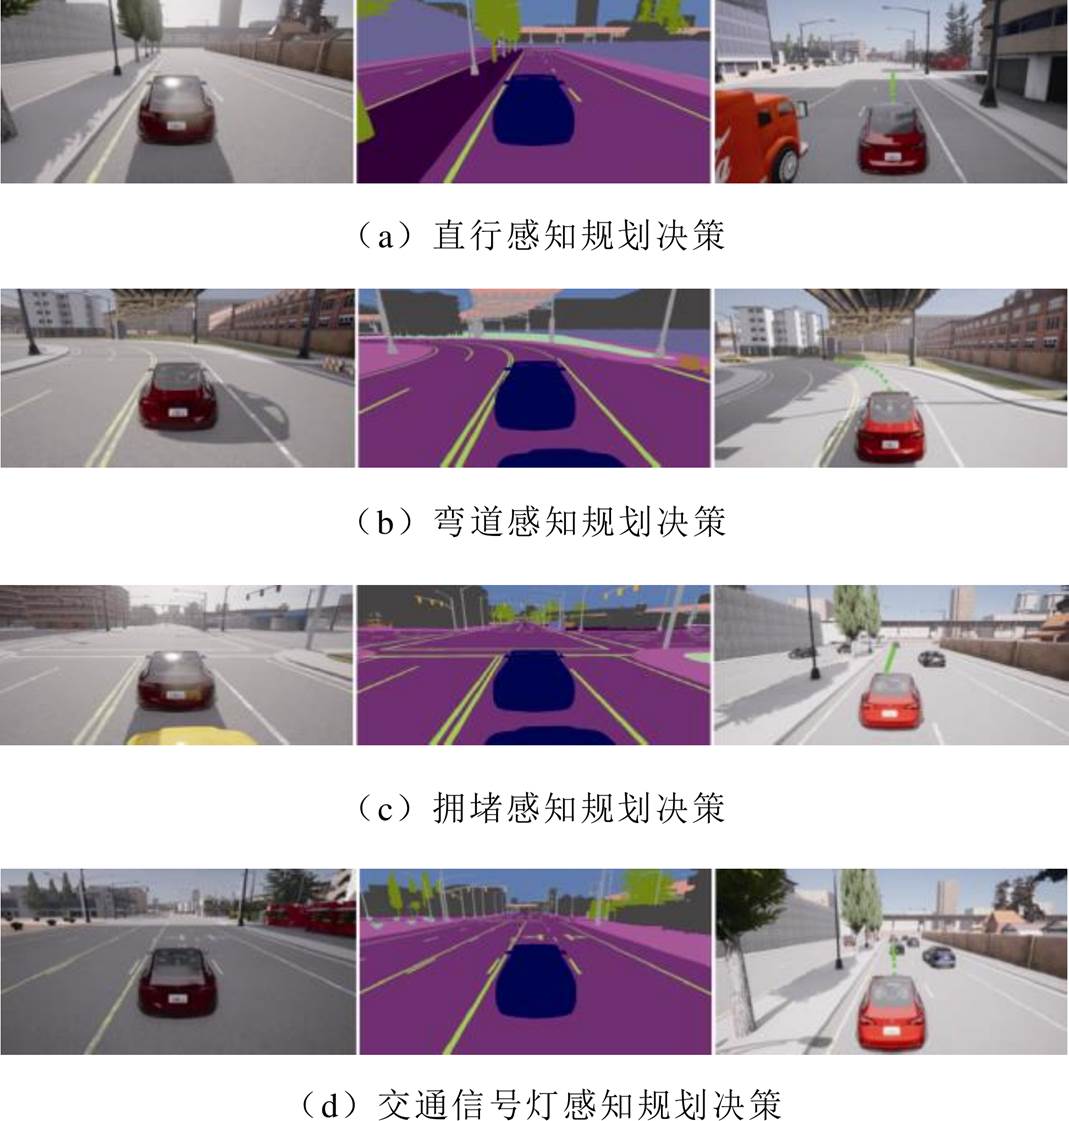
图12 训练过程实景
Fig.12 Real-world scenarios during training
不同工况能耗对比如图13所示。从图13可以看出,在WLTC工况下,电动汽车的单位时间能耗为四种工况中最高。此外,在所有工况循环中,电动汽车的整体能耗均较为显著。为了验证该方法在能耗优化方面的有效性,本文对四种工况下优化前后的能耗及节能率进行了详细计算,具体结果见表5。
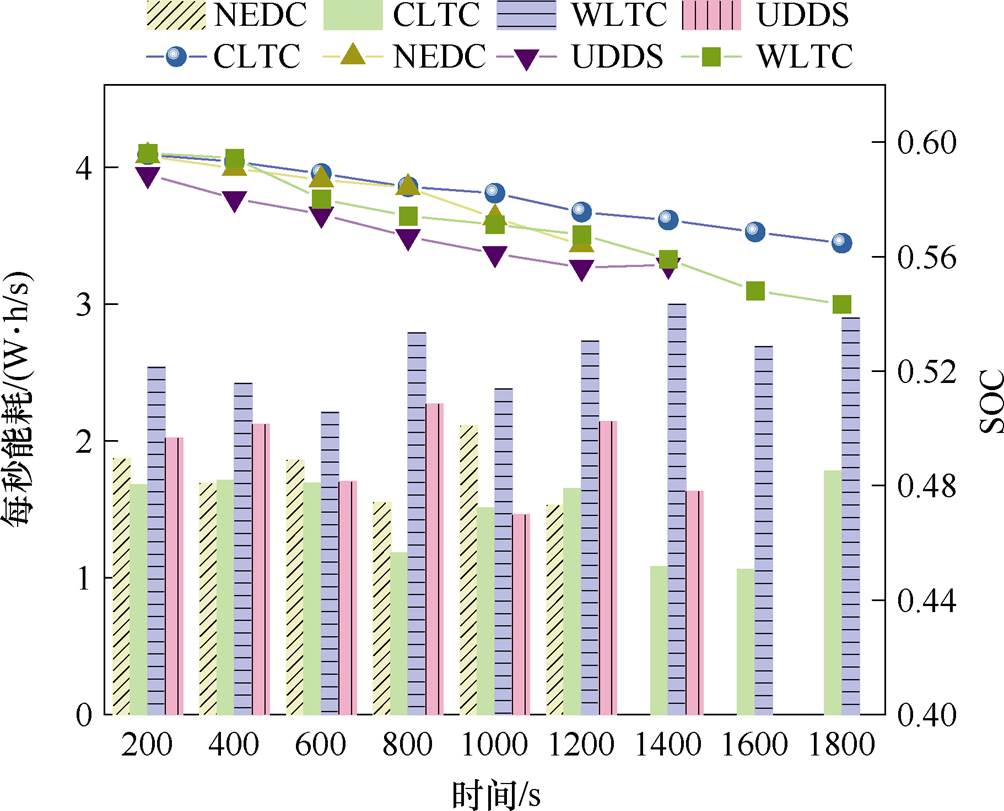
图13 不同工况能耗对比
Fig.13 Energy consumption comparison under different operating conditions
表5 能耗对比数据
Tab.5 Energy consumption and energy saving rate comparison data
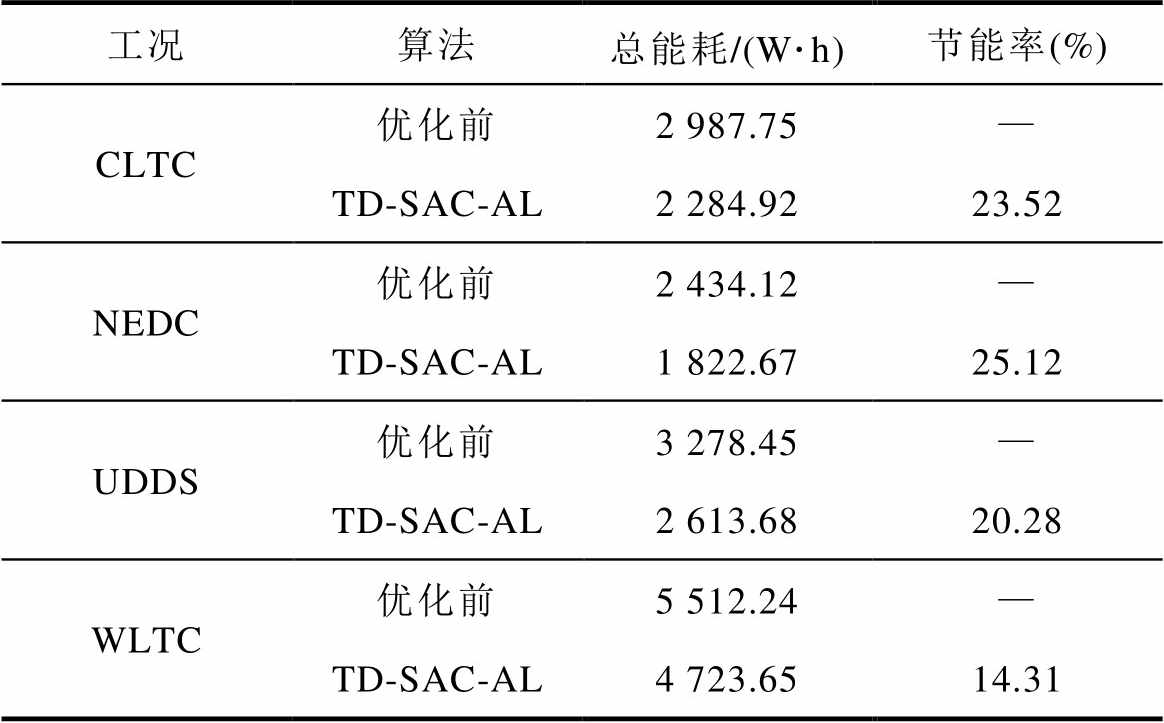
工况算法总能耗/(W·h)节能率(%) CLTC优化前2 987.75— TD-SAC-AL2 284.9223.52 NEDC优化前2 434.12— TD-SAC-AL1 822.6725.12 UDDS优化前3 278.45— TD-SAC-AL2 613.6820.28 WLTC优化前5 512.24— TD-SAC-AL4 723.6514.31
在所使用循环工况中,最低的节能率数据为14.31%,表明在所有工况下均能达成节能的目的,说明本文方法能够显著提高电动汽车能效优化的效果。
4.3.2 不同算法下能耗对比验证
为了验证所用方法相比其他强化学习算法拥有更佳的节能能力,选用TD3、SAC、DDPG以及DP算法作为基线方法在UDDS和WLTC工况下进行能耗率对比验证,如图14所示。
结果显示,TD-SAC-AL算法的实时能耗在测试工况循环下相比其他算法均保持一定的能耗优势,说明训练后的智能体存在一定的泛化能力。从表6所示节能详细对比数据可以看出,在所使用循环工况中,相比于DP控制,所有强化学习算法均能耗更小、节能率更高,表明强化学习在能效优化方面更有潜力。本文所用TD-SAC-AL算法在测试工况中的总能耗均为最小,且最小值为2 613.68 W·h。同时节能率均为最高,最高值为20.28%。这一结果充分证明了该方法在电动汽车行驶能耗方面的有效性和优越性。
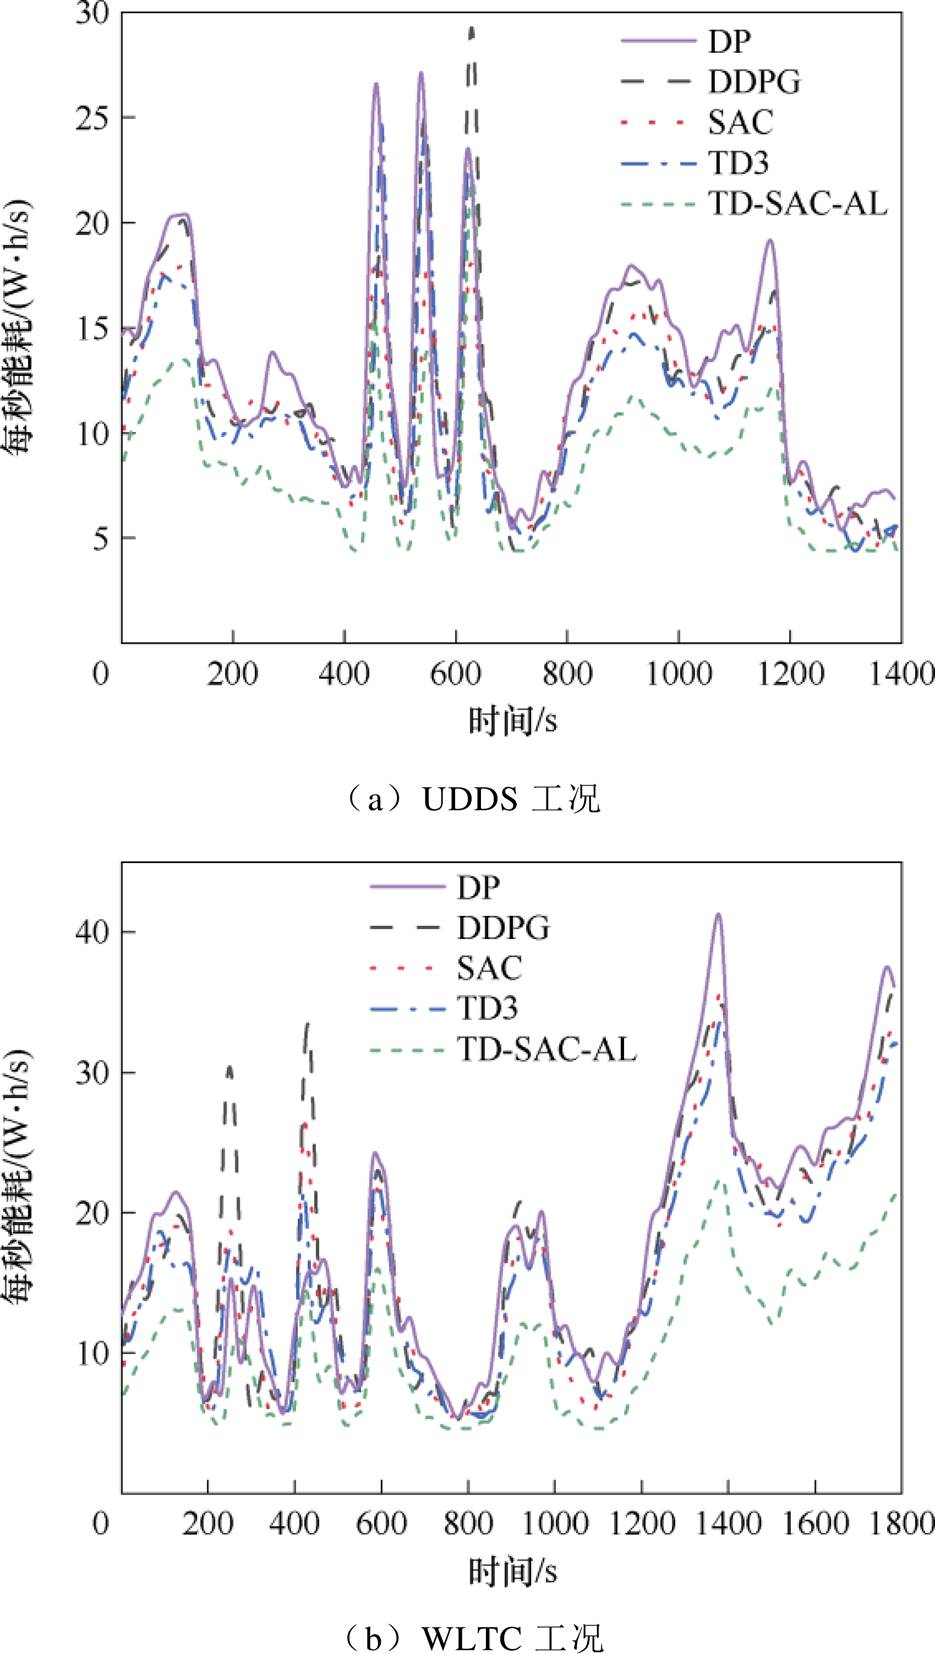
图14 不同基线方法能耗对比
Fig.14 Energy consumption comparison of different baseline methods
表6 不同算法节能对比数据
Tab.6 Energy-saving comparison data of different algorithms
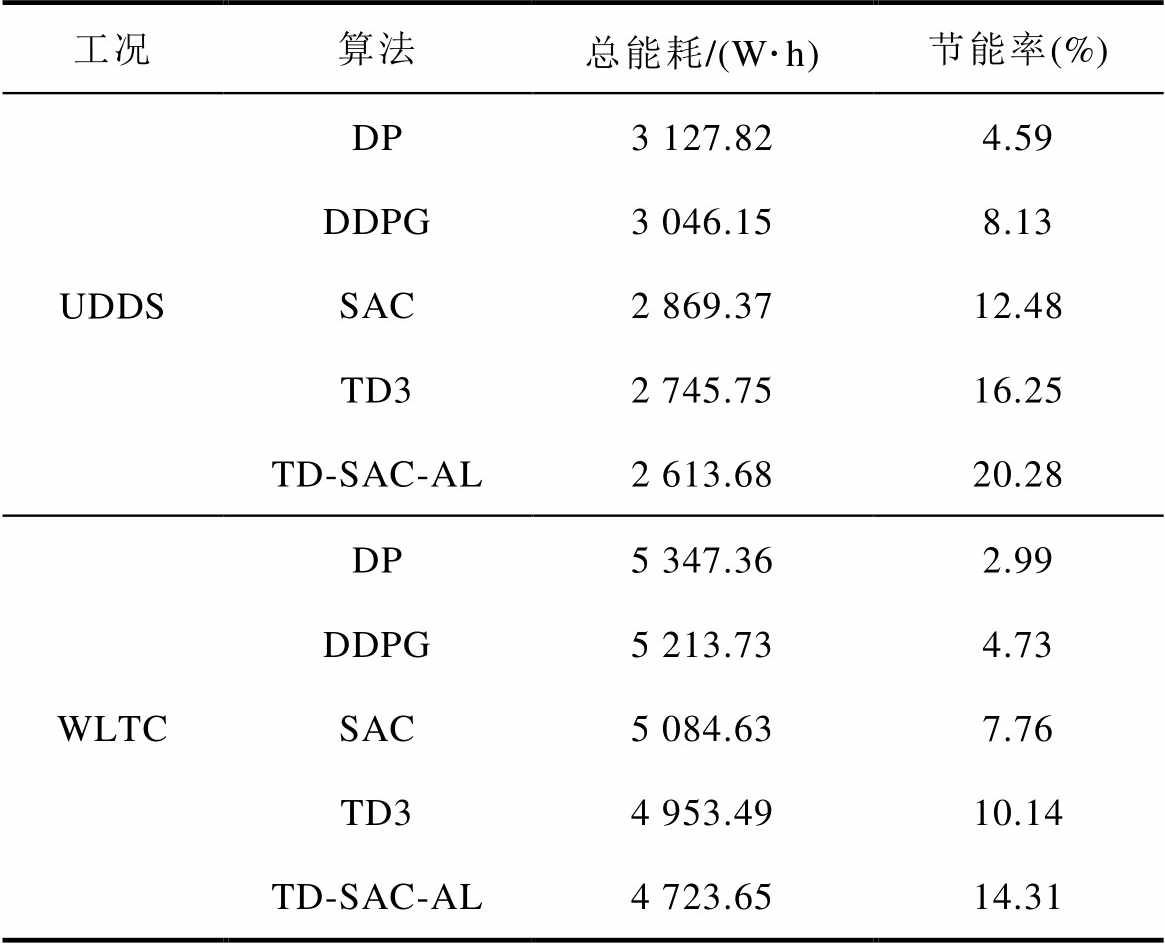
工况算法总能耗/(W·h)节能率(%) UDDSDP3 127.824.59 DDPG3 046.158.13 SAC2 869.3712.48 TD32 745.7516.25 TD-SAC-AL2 613.6820.28 WLTCDP5 347.362.99 DDPG5 213.734.73 SAC5 084.637.76 TD34 953.4910.14 TD-SAC-AL4 723.6514.31
4.3.3 驾驶舒适性对比验证
本文的核心目的是尽可能减少电动汽车急加速、急减速的频率以实现能效优化。因此,除能耗对比验证之外,还进行了驾驶舒适性对比验证,用于验证所用方法对于减少急刹车急加速情况的效果。首先分别在两种验证工况下测试电动汽车在优化前后的速度与加速度对比,并得到其实时曲线,如图15所示。
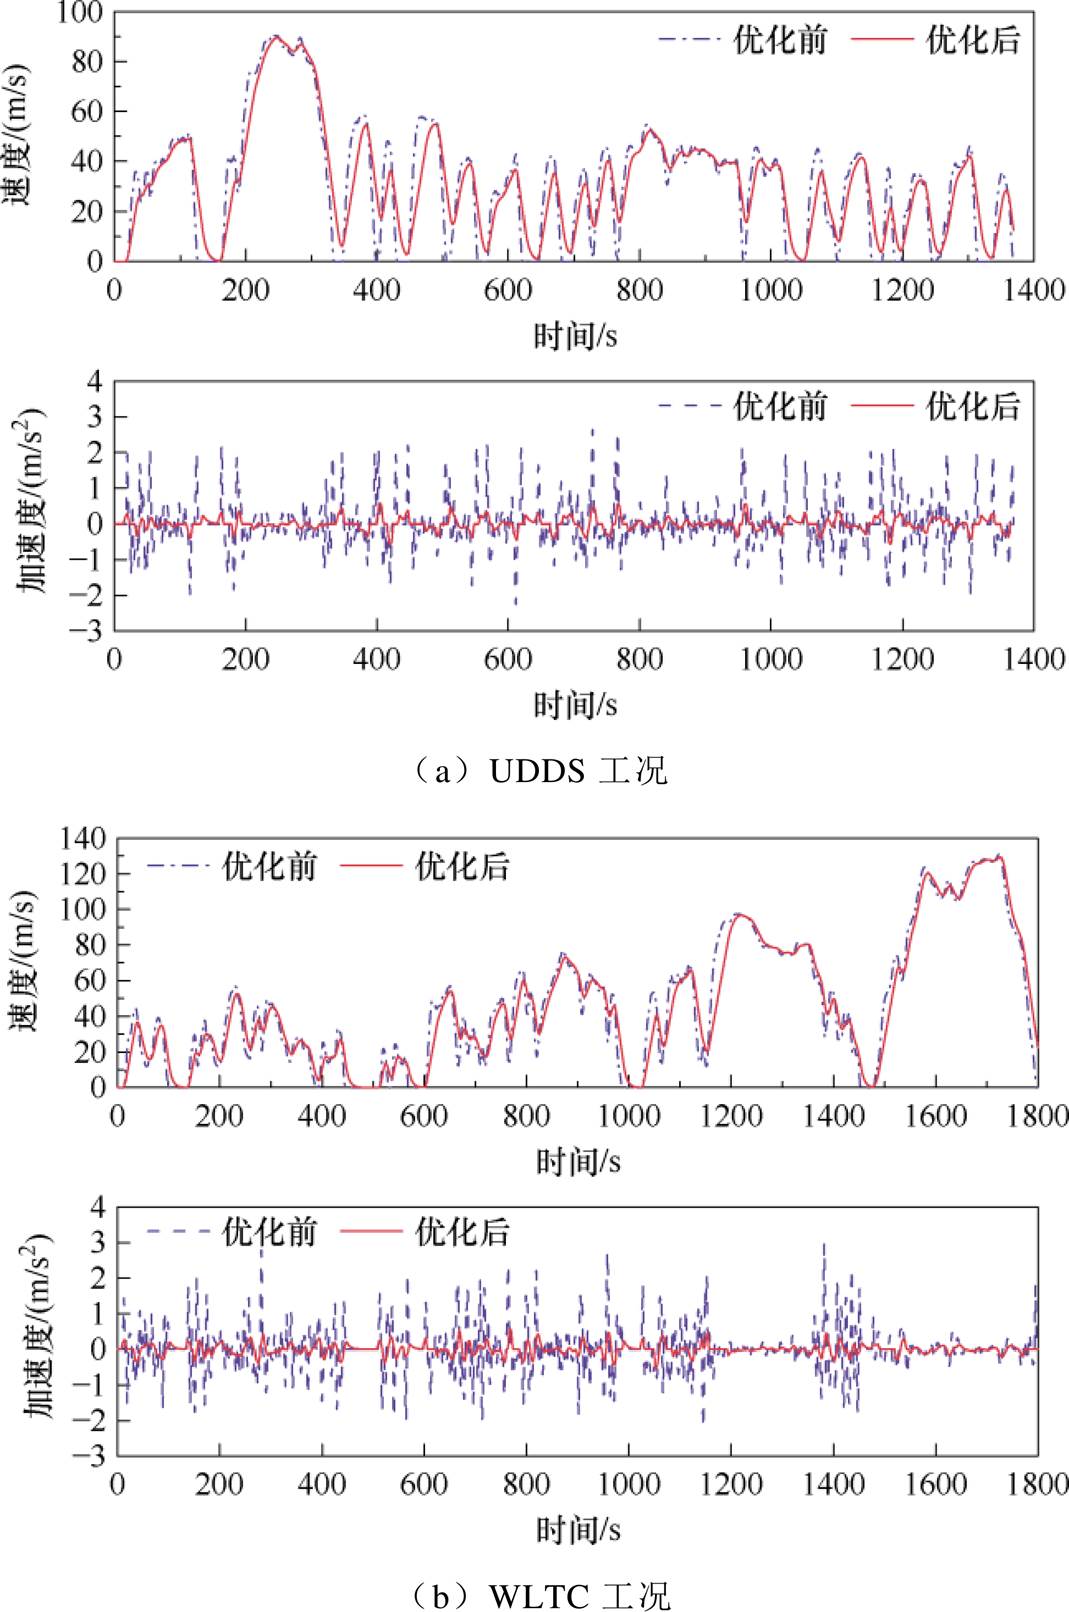
图15 两种验证工况下的实时速度、加速度对比
Fig.15 Comparison of real-time speed and acceleration under the two validation driving cycles
可以看出,通过TD-SAC-AL算法优化后,电动汽车急加速与急减速的次数均明显减少且速度、加速度的变化更加稳定。为了进一步验证其舒适性变化,本文还在两种验证工况下分别进行了冲击度(jerk)评估,其中冲击度指标采用方均根加加速度(RMS jerk)表示,用以量化车辆纵向加速度变化的平滑性。RMS jerk值越低,代表车辆在加减速过程中的变化越平缓,驾驶体验越舒适。
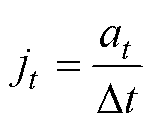 (32)
两种验证工况下的驾驶舒适度对比如图16所示,可以观察到,在能效优化决策的作用下,车辆在两种驾驶场景中急加速与急减速的次数均明显减少,同时冲击度指标(RMS jerk)显著低于未进行约束优化时的水平。这说明TD-SAC-AL算法不仅在能效方面取得了提升,还能够有效缓解因能量优化过度而可能引发的驾驶不适问题。
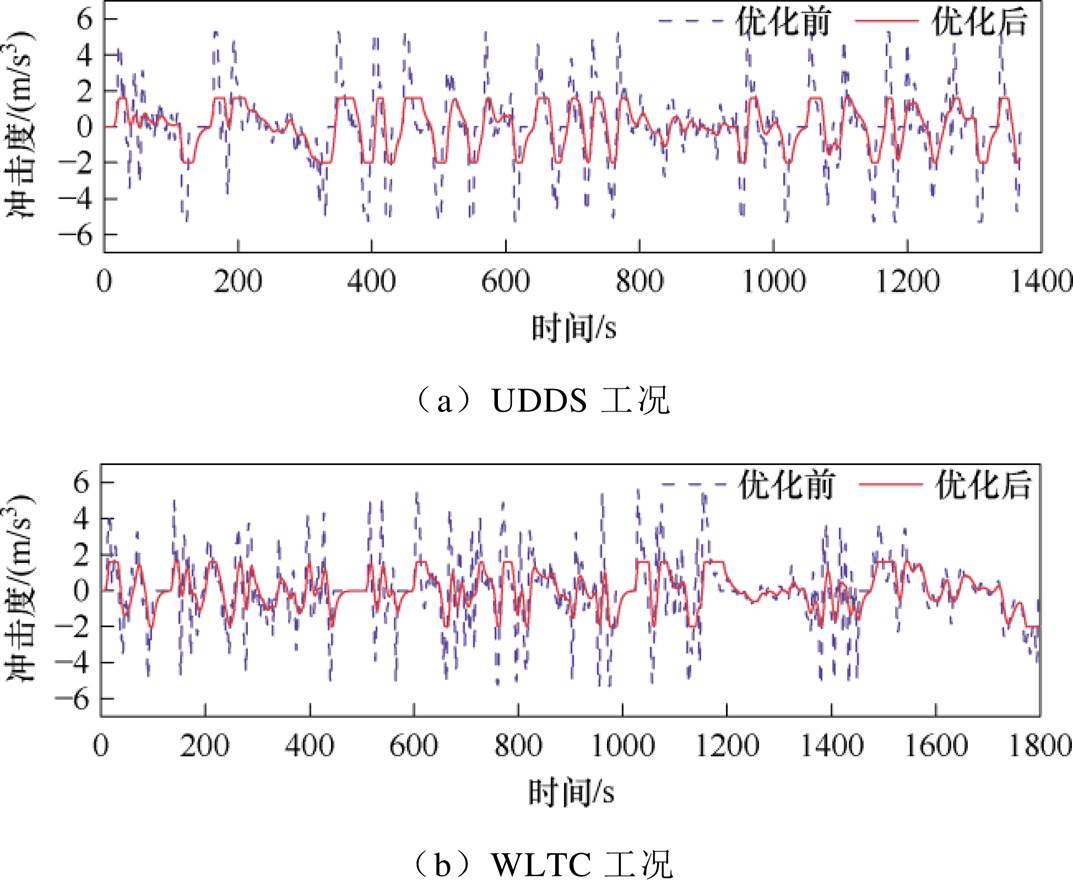
图16 两种验证工况下的驾驶舒适度对比
Fig.16 Comparison of driving comfort under the two validation driving cycles
TD-SAC-AL方法在对比验证中展现出最优的能效优化能力,证明了其在节能驾驶方面的潜力。为进一步验证基于环境模型的环境感知模块能够提高智能体在城市路况这类复杂视觉环境中提取特征的性能,本文将变分自编码器(Variational Auto- encoder, VAE)、多模态自编码器(Multimodal Auto- encoder, MA)、CLIP编码器作为基线方法与本文所用环境模型编码器在UDDS和WLTC工况循环中进行能耗与电池损耗对比验证,不同基线方法环境感知验证如图17所示。
结果表明,使用环境模型编码器的能效优化策略相比于使用几种基线方法在不同循环工况中每秒能耗均为最低,且电池容量损失均为最少。说明其拥有最佳的能效优化效果,即拥有最佳的城市路况感知能力。
为进一步验证方法中主动学习模块在能效优化方面的作用,对TD-SAC算法分别选取随机采样策略、TD误差采样策略以及KL散度主动学习采样策略进行训练,并在WLTC和UDDS工况下展开能耗与电池容量损失对比验证,工况循环下主动学习效果验证如图18所示。
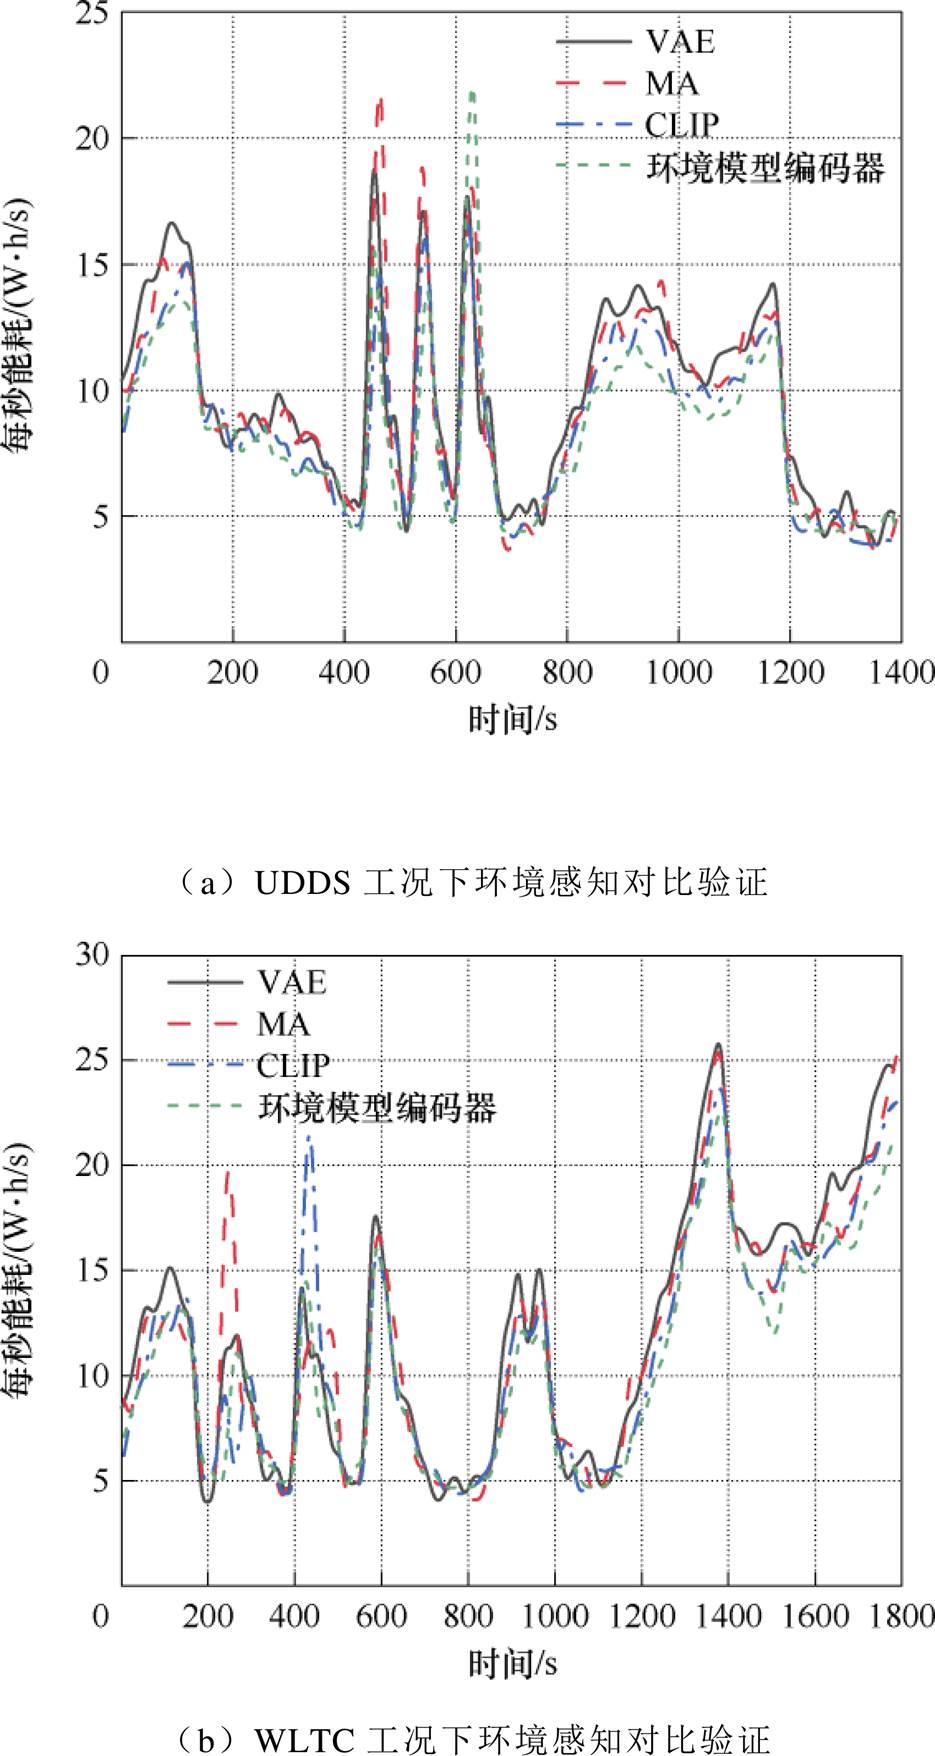
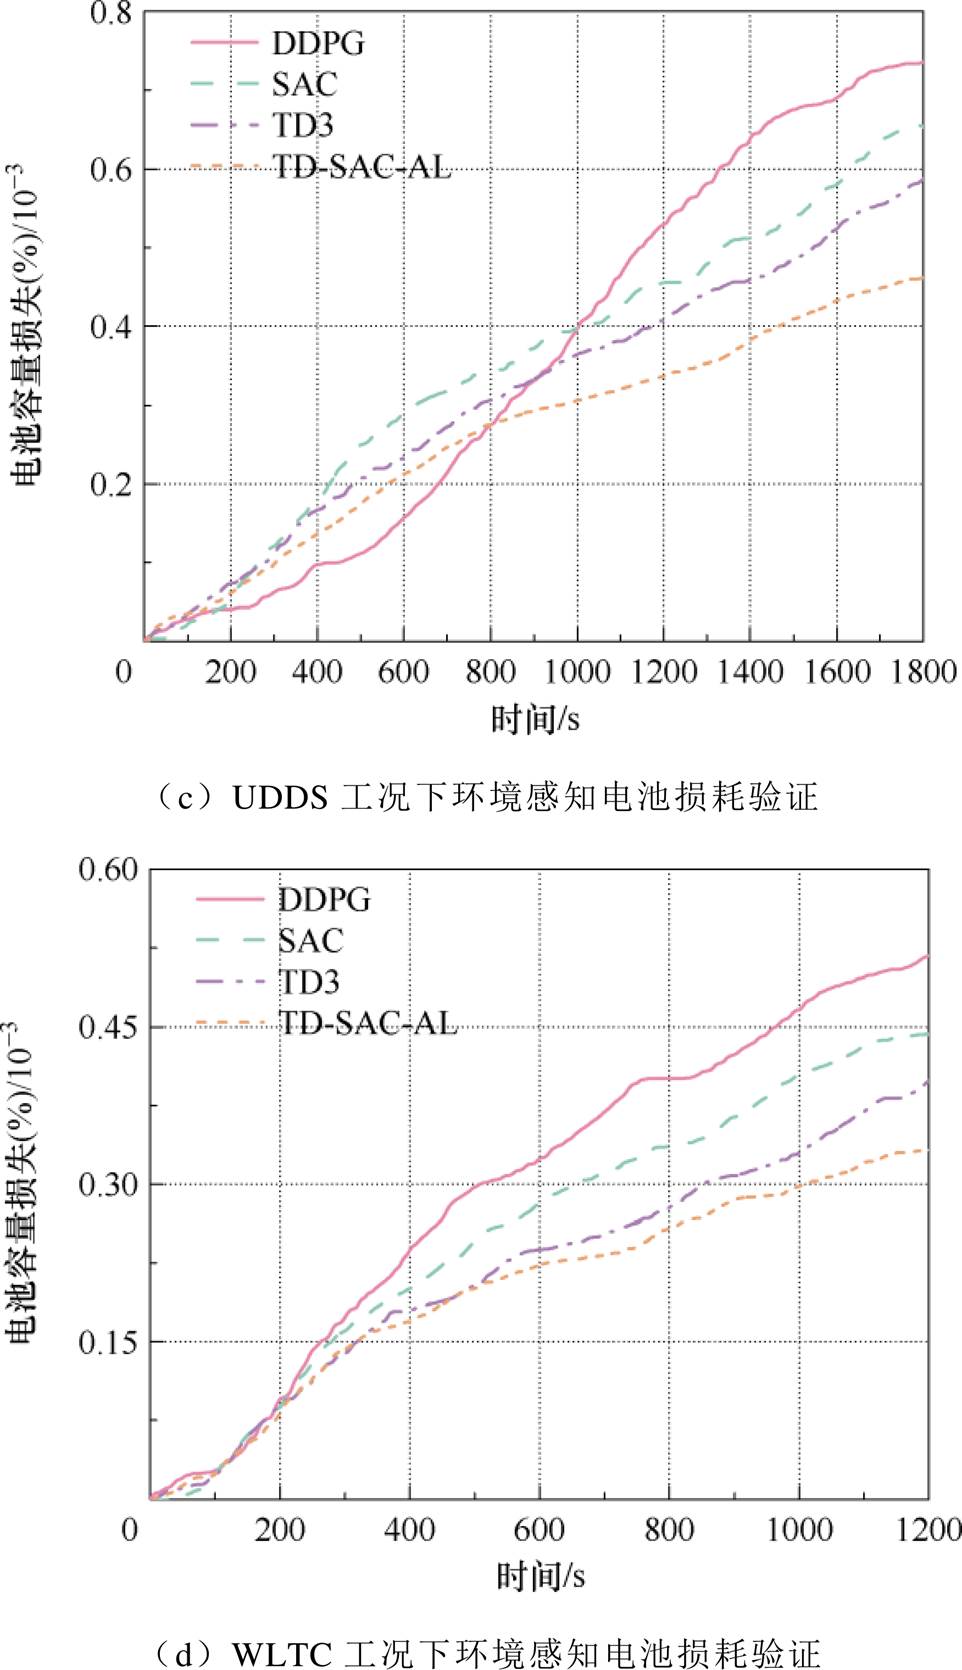
图17 不同基线方法环境感知验证
Fig.17 Environment perception validation using different baseline methods
从图18可以看出,在UDDS和WLTC循环工况下采用主动学习采样策略的每秒能耗与电池容量损失均为最小,展现了其优越的电池保护能力,确保电动汽车在城市路况下可以长时间高效运行。
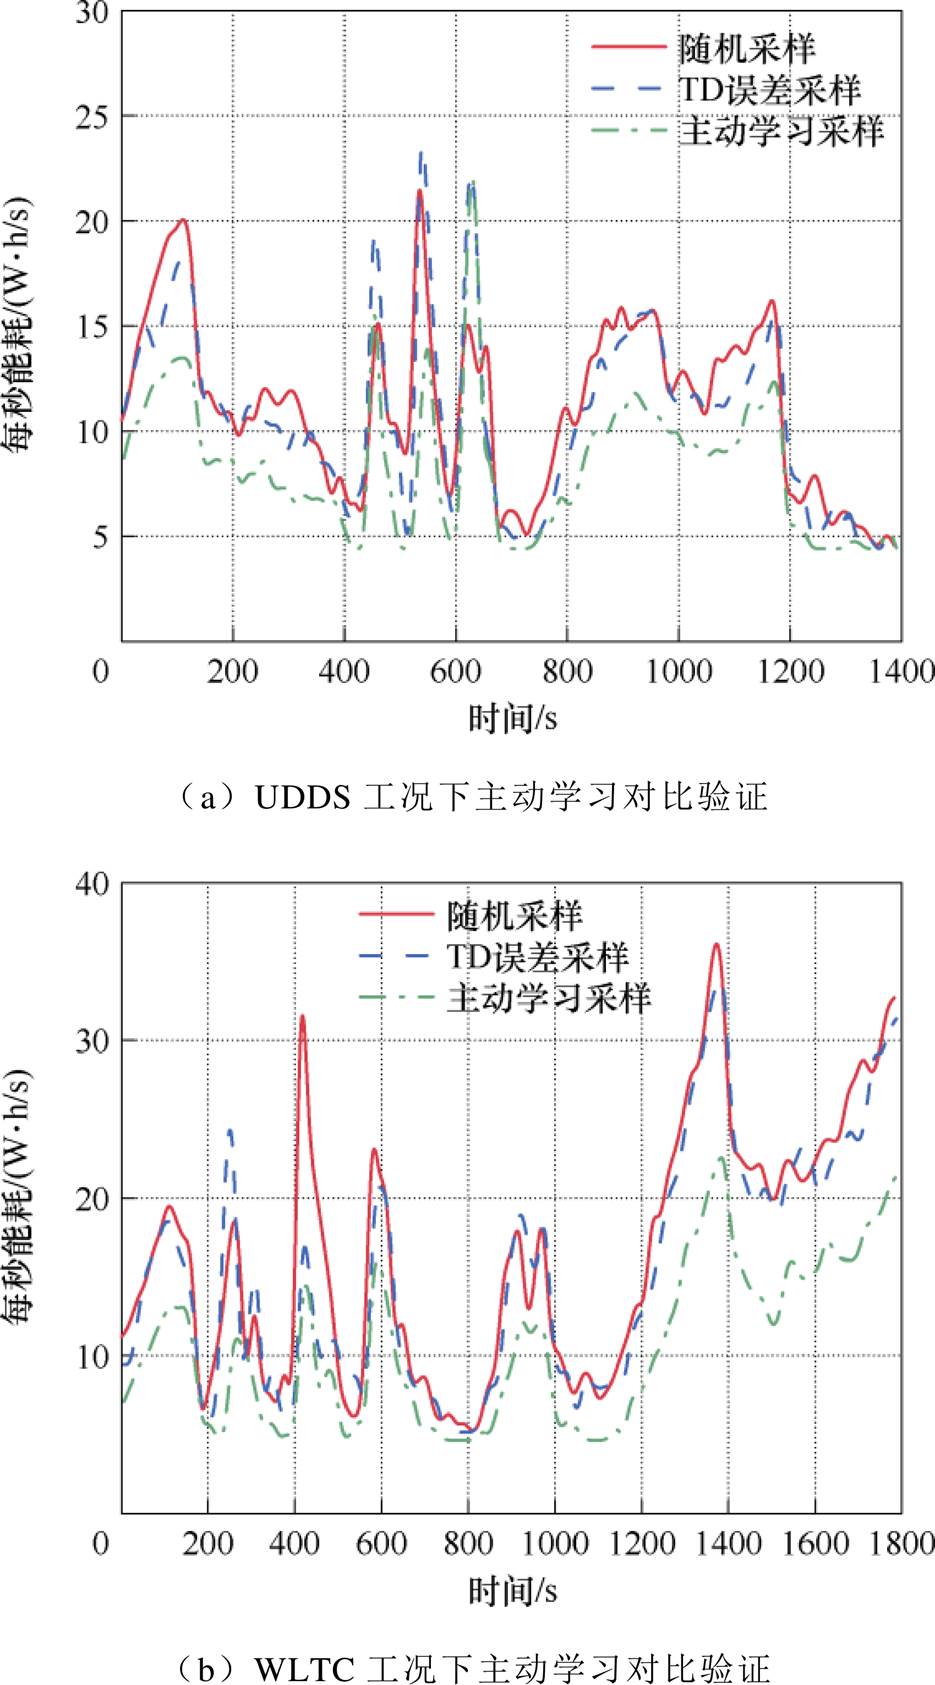
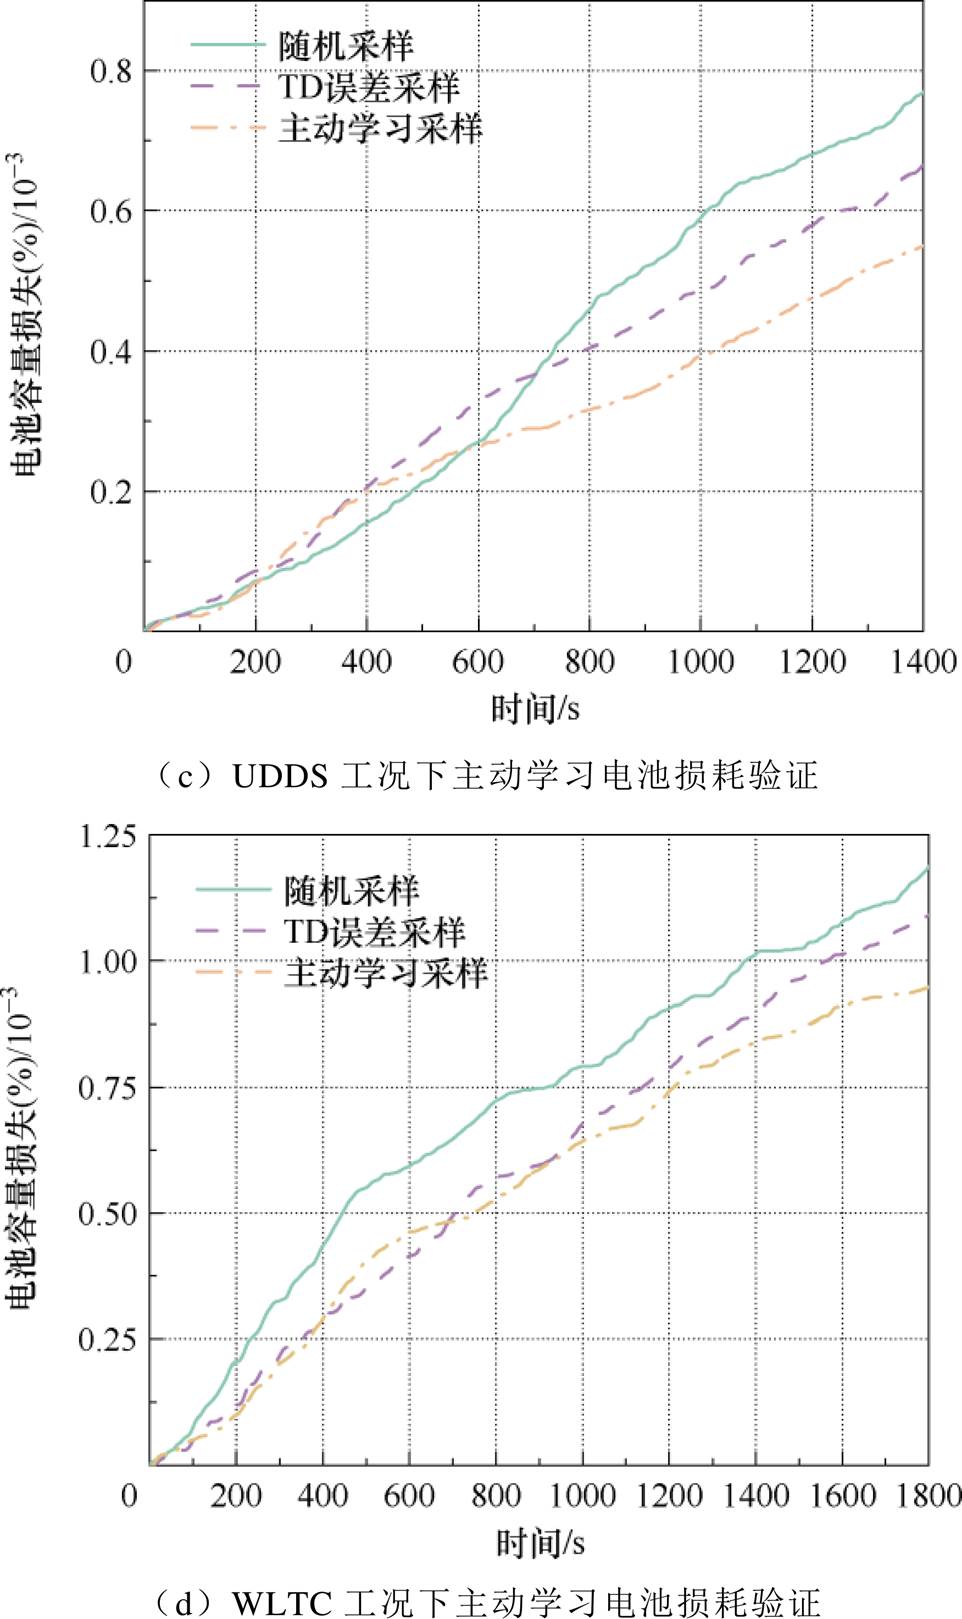
图18 工况循环下主动学习效果验证
Fig.18 Active learning effect verification under driving cycle
为进一步评估所提算法的工程应用可行性,本节对算法的计算资源占用和推理时间进行对比分析。所有算法均采用相同的三层全连接层骨干网络结构,测试平台为Intel Core i7-13700K CPU、NVIDIA RTX 4060 GPU。每种算法重复进行1 000次单步前向推理,取平均值,结果见表7。
表7 不同算法计算复杂度与推理时间对比
Tab.7 Comparison of computational complexity and inference time among different algorithms
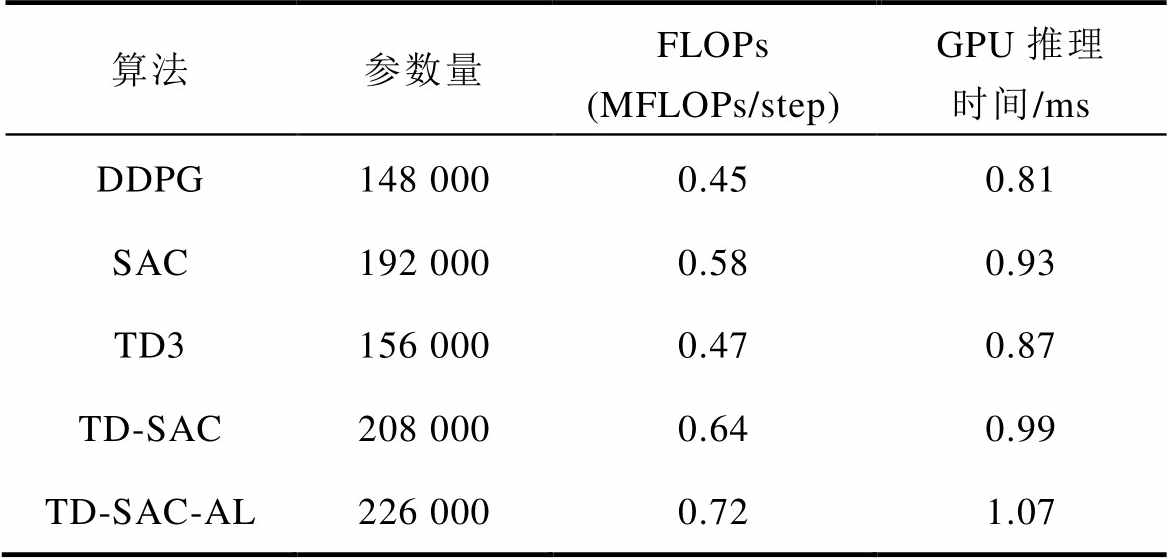
算法参数量FLOPs (MFLOPs/step)GPU推理时间/ms DDPG148 0000.450.81 SAC192 0000.580.93 TD3156 0000.470.87 TD-SAC208 0000.640.99 TD-SAC-AL226 0000.721.07
由表7可见,本文完整算法TD-SAC-AL相较原始SAC参数量仅增加约18%,FLOPs增加约24%,在车载级GPU上单步推理时间约为1.07 ms,远低于纵向控制常用周期,完全满足实时性要求。
针对当前电动汽车在城市路况智能驾驶时面临的能耗过大问题,本文提出了一种融合环境感知与主动强化学习的节能控制策略优化方法。首先,通过城市环境感知模块提取实时路况特征,使车辆能够根据动态路况自适应调整能效优化策略。其次,优化了强化学习算法,增强了模型的收敛性与鲁棒性。最后,引入主动学习机制实现了智能优化过程的自主升级进化。结果表明,在四种不同的循环工况中,所提能效优化策略表现出优异的节能效果。
然而,在建模与策略设计过程中主要从节能优化角度出发,未对私人车辆中驾驶习惯差异及人机协同决策问题进行显式建模。已有研究与工程实践表明,不同驾驶习惯往往对车辆能耗具有显著影响。例如,激进的驾驶行为通常伴随着频繁且幅度较大的加减速过程,容易引发动力系统功率波动并增加制动能量损失,从而抬升整车能耗水平。围绕上述节能机理,未来工作可进一步将驾驶习惯因素引入节能控制框架,在保持节能目标不变的前提下,探索面向不同驾驶风格的能效优化策略。此外,本文方法目前主要在仿真环境中进行验证,其工程适用性仍有待进一步评估。后续研究将进一步在硬件在环平台上对所提算法进行实时性与可靠性验证,并最终推动其在真实车载控制器中的工程部署与应用。
参考文献
[1] Garau M, Torsæter B N. A methodology for optimal placement of energy hubs with electric vehicle charging stations and renewable generation[J]. Energy, 2024, 304: 132068.
[2] Zhang Hengwei, Zhang Yisheng, Wang Zhigang, et al. A novel knowledge-driven flexible human-robot hybrid disassembly line and its key technologies for electric vehicle batteries[J]. Journal of Manufacturing Systems, 2023, 68: 338-353.
[3] 侯文博, 杨平, 陈可, 等. 电动汽车驱动复用升压技术[J]. 电工技术学报, 2024, 39(增刊1): 95-105.
Hou Wenbo, Yang Ping, Chen Ke, et al. Multiplexing booster technology for electric vehicle drive[J]. Transactions of China Electrotechnical Society, 2024, 39(S1): 95-105.
[4] Ferloni A. Transitions as a coevolutionary process: the urban emergence of electric vehicle inventions[J]. Environmental Innovation and Societal Transitions, 2022, 44: 205-225.
[5] 彭自然, 杨肖阳, 肖伸平. 基于EKF-HInformer模型估计汽车动力电池的SOC&SOH[J]. 电子测量与仪器学报, 2025, 39(3): 21-33.
Peng Ziran, Yang Xiaoyang, Xiao Shenping. SOC and SOH of the battery are estimated based on the EKF- HInformer model[J]. Journal of Electronic Measurement and Instrumentation, 2025, 39(3): 21-33.
[6] Wu Yue, Huang Zhiwu, Zheng Yusheng, et al. Spatial-temporal data-driven full driving cycle predi- ction for optimal energy management of battery/ supercapacitor electric vehicles[J]. Energy Conversion and Management, 2023, 277: 116619.
[7] 陈中, 万玲玲, 张梓麒. 面向共享电动汽车的用户助推与充电协同调度[J]. 电工技术学报, 2025, 40(11): 3572-3590.
Chen Zhong, Wan Lingling, Zhang Ziqi. Nudging users and charging optimization for electric car- sharing system scheduling[J]. Transactions of China Electrotechnical Society, 2025, 40(11): 3572-3590.
[8] Yang Yiqin, Hu Hao, Li Wenzhe, et al. Flow to control: offline reinforcement learning with lossless primitive discovery[J]. Proceedings of the AAAI Conference on Artificial Intelligence, 2023, 37(9): 10843-10851.
[9] Ada S E, Oztop E, Ugur E. Diffusion policies for out-of-distribution generalization in offline reinfor- cement learning[J]. IEEE Robotics and Automation Letters, 2024, 9(4): 3116-3123.
[10] Kim T, Park Y, Park Y, et al. Acceleration of actor-critic deep reinforcement learning for visual grasping by state representation learning based on a preprocessed input image[C]//2021 IEEE/RSJ Inter- national Conference on Intelligent Robots and Systems (IROS), Prague, Czech Republic, 2021: 198-205.
[11] Nair A, Pong V, Dalal M, et al. Visual reinforcement learning with imagined goals[C]//Proceedings of the 32nd International Conference on Neural Information Processing Systems, Montréal, Canada, 2018: 9209- 9220.
[12] Yang J, Lee G, Chang S, et al. Towards governing agent’s efficacy: action-conditional β-VAE for deep transparent reinforcement learning[C]//Asian Confer- ence on Machine Learning, PMLR, 2019: 32-47.
[13] Fujimoto S, Chang W D, Smith E J, et al. For SALE: state-action representation learning for deep reinfor- cement learning[C]//Proceedings of the 37th Inter- national Conference on Neural Information Pro- cessing Systems, Red Hook, NY, 2023: 61573-61624.
[14] Zheng R, Wang X, Sun Y, et al. Temporal latent action-driven contrastive loss for visual reinforcement learning[J]. Advances in Neural Information Pro- cessing Systems, 2023, 36: 48203-48225.
[15] Gelada C, Kumar S, Buckman J, et al. Deepmdp: learning continuous latent space models for repre- sentation learning[C]//International Conference on Machine Learning, PMLR, 2019: 2170-2179.
[16] Peng Ziran, He Zhenyu. Optimization of regenerative braking control strategy for dual-motor electric vehicles based on deep reinforcement learning[J]. IEEE Transactions on Intelligent Transportation Systems, 2025, 26(7): 10954-10967.
[17] Peng Ziran, Yang Xiaoyang. Short- and medium-term power load forecasting model based on a hybrid attention mechanism in the time and frequency domains[J]. Expert Systems with Applications, 2025, 278: 127329.
[18] Macias Fernandez A, Kandidayeni M, Boulon L, et al. An adaptive state machine based energy management strategy for a multi-stack fuel cell hybrid electric vehicle[J]. IEEE Transactions on Vehicular Tech- nology, 2020, 69(1): 220-234.
[19] 彭自然, 贺振宇, 肖伸平, 等. 基于深度强化学习模型TD3优化和改进的电动汽车制动能量回收策略[J]. 控制与决策, 2025, 40(8): 2361-2372.
Peng Ziran, He Zhenyu, Xiao Shenping, et al. Electric vehicle brake energy recovery strategy based on deep reinforcement learning model TD3 optimization and improvement[J]. Control and Decision, 2025, 40(8): 2361-2372.
[20] 陈剑, 杜文娟, 王海风. 采用深度迁移学习定位含直驱风机次同步振荡源机组的方法[J]. 电工技术学报, 2021, 36(1): 179-190.
Chen Jian, Du Wenjuan, Wang Haifeng. A method of locating the power system subsynchronous oscillation source unit with grid-connected PMSG using deep transfer learning[J]. Transactions of China Electro- technical Society, 2021, 36(1): 179-190.
[21] 吴延波, 韩志伟, 王惠, 等. 基于双延迟深度确定性策略梯度的受电弓主动控制[J]. 电工技术学报, 2024, 39(14): 4547-4556.
Wu Yanbo, Han Zhiwei, Wang Hui, et al. Active pantograph control of deep reinforcement learning based on double delay depth deterministic strategy gradient[J]. Transactions of China Electrotechnical Society, 2024, 39(14): 4547-4556.
[22] 彭自然, 王顺豪, 肖伸平. 基于SDAE-DCPInformer的电动汽车电池SOC和SOH估算方法[J]. 智能系统学报, 2025, 20(4): 969-983.
Peng Ziran, Wang Shunhao, Xiao Shenping. SOC and SOH estimation method of electric vehicle battery based on SDAE-DCPInformer[J]. CAAI Transactions on Intelligent Systems, 2025, 20(4): 969-983.
[23] 张薇, 王浚宇, 杨茂, 等. 基于分布式双层强化学习的区域综合能源系统多时间尺度优化调度[J]. 电工技术学报, 2025, 40(11): 3529-3544.
Zhang Wei, Wang Junyu, Yang Mao, et al. The multi-time-scale optimal scheduling for regional integrated energy system based on the distributed bi-layer reinforcement learning[J]. Transactions of China Electrotechnical Society, 2025, 40(11): 3529- 3544.
[24] 杜伟, 王圣, 李健, 等. 基于CNN-LSTM-AM模型的储能锂离子电池荷电状态预测[J]. 电工技术学报, 2025, 40(9): 2982-2995.
Du Wei, Wang Sheng, Li Jian, et al. Prediction of state of charge for energy storage lithium-ion batteries based on CNN-LSTM-AM model[J]. Trans- actions of China Electrotechnical Society, 2025, 40(9): 2982-2995.
[25] Liu T, Wang B, Yang C. Online Markov Chain-based energy management for a hybrid tracked vehicle with speedy Q-learning[J]. Energy, 2018, 160: 544-555.
[26] 陈泽宇, 方志远, 杨瑞鑫, 等. 基于深度强化学习的混合动力汽车能量管理策略[J]. 电工技术学报, 2022, 37(23): 6157-6168.
Chen Zeyu, Fang Zhiyuan, Yang Ruixin, et al. Energy management strategy for hybrid electric vehicle based on the deep reinforcement learning method[J]. Transactions of China Electrotechnical Society, 2022, 37(23): 6157-6168.
[27] Chen Bin, Wang Miaoben, Hu Lin, et al. A hierarchical cooperative eco-driving and energy management strategy of hybrid electric vehicle based on improved TD3 with multi-experience[J]. Energy Conversion and Management, 2025, 326: 119508.
[28] Wu Yitao, Liu Yonggang, Peng Jiang, et al. Enhanced hierarchical eco-driving control for electric vehicles via global velocity optimization with road slope adaptation[J]. IEEE Transactions on Transportation Electrification, 2025, 11(4): 10322-10335.
[29] Yan Su, Fang Jiayi, Yang Chao, et al. Eco-driving for connected automated hybrid electric vehicles in learning-enabled layered transportation systems[J]. Transportation Research Part D: Transport and Environment, 2025, 142: 104677.
[30] Haarnoja T, Zhou A, Abbeel P, et al. Soft actor-critic: off-policy maximum entropy deep reinforcement learning with a stochastic actor[C]//International Con- ference on Machine Learning, Pmlr, 2018: 1861- 1870.
[31] Duan Jingliang, Guan Yang, Li S E, et al. Distri- butional soft actor-critic: off-policy reinforcement learning for addressing value estimation errors[J]. IEEE Transactions on Neural Networks and Learning Systems, 2022, 33(11): 6584-6598.
[32] 陈嘉琛, 陈中, 李冰融, 等. 基于二阶随机动力学的多虚拟电厂自趋优能量管理策略[J]. 中国电机工程学报, 2024, 44(16): 6294-6306.
Chen Jiachen, Chen Zhong, Li Bingrong, et al. Energy management strategy for multi-virtual power plants with self-optimization based on second-order stochastic dynamics[J]. Proceedings of the CSEE, 2024, 44(16): 6294-6306.
Abstract Under the dual pressures of the global energy crisis and environmental pollution, electric vehicles have emerged as an important development direction in the transportation sector, thanks to their zero-emission and high energy-efficiency characteristics. However, electric vehicles still face challenges, including high energy consumption, limited driving range, and reduced comfort in dynamic, complex environments. Traditional energy efficiency optimization methods, such as rule-based control strategies, are computationally simple but lack flexibility. Optimization-based approaches can approximate global optimality but struggle with real-time adaptability due to their high computational complexity. Existing deep reinforcement learning methods can handle high-dimensional state spaces. However, these methods often suffer from energy waste and driving instability due to inadequate environmental perception or abrupt changes in action. This study proposes an innovative framework that integrates environmental perception with deep reinforcement learning to achieve efficient energy conservation and enhanced driving comfort in complex road conditions.
To address the challenge of processing high-dimensional traffic data, a city road-condition perception module based on a World Model is proposed. The encoder is trained using both contrastive learning and coupled reinforcement learning, enabling the agent to perceive real-time traffic changes and generate control strategies aligned with energy-saving objectives. In addition, the study incorporates an active learning framework that uses a KL-divergence-based strategy to select more difficult training samples. Periodic offline training is then employed to optimize the policy. This intelligent approach significantly enhances the energy efficiency of electric vehicles under urban road conditions.
The proposed method has been validated on the CARLA simulation platform. The results demonstrate that it can effectively extract key environmental features and accelerate model convergence. Under real-world driving conditions, vehicle energy consumption, SOC variation, and battery degradation rate are improved. Meanwhile, statistical analyses of real-time acceleration and jerk data show that the proposed approach yields smooth control behavior and substantially reduces the frequency of sudden acceleration and deceleration events.
In conclusion, this study proposes an efficient, smooth, and adaptive energy efficiency optimization framework for electric vehicles. By deeply integrating environmental perception with active reinforcement learning, the framework demonstrates innovation in low-dimensional traffic representation and achieves breakthroughs in optimizing multi-objective reward functions. The results confirm that the method achieves significant energy savings and improves driving comfort in dynamic, complex environments, providing strong theoretical support for the practical application of intelligent driving systems. Future research will focus on optimizing perception models for multimodal traffic scenarios, thereby enabling fully intelligent, energy-efficient driving technologies. Additionally, drivers' personalized driving habits significantly impact vehicle energy consumption and battery lifespan. Future work will integrate driving behavior modeling with energy-saving strategies by learning from drivers' operational preferences, aiming to achieve intelligent control strategies that balance energy efficiency with personalized adaptability. Meanwhile, hardware-in-the-loop (HIL) platforms will be used to systematically evaluate the algorithm's real-time performance, stability, and reliability. By deploying the policy network on embedded controllers and testing its response latency and fault-recovery capabilities in dynamic traffic environments, the method can be ensured to provide sufficient safety and robustness for engineering implementation.
keywords:Electric vehicles, deep reinforcement learning, environment perception, energy-saving optimi- zation, active learning, soft actor-critic (SAC) algorithm
DOI: 10.19595/j.cnki.1000-6753.tces.251369
中图分类号:U469.72; TP18
湖南省自然科学基金项目(2025JJ0057)、湖南省研究生科研创新项目(CX20240923)、湖南省研究生科研创新项目(CX20251638)和湖南工业大学研究生科研创新项目(电动汽车SOC智能估计)资助。
收稿日期 2025-08-06
改稿日期 2025-11-29
彭自然 男,1969 年生,博士,副教授,研究方向为人工智能、信号处理、智能检测仪表等。E-mail: pengziran@hut.edu.cn(通信作者)
范泽宇 男,2001年生,硕士研究生,研究方向为强化学习、电动汽车能效优化控制。E-mail: 543432325@qq.com
(编辑 陈 诚)