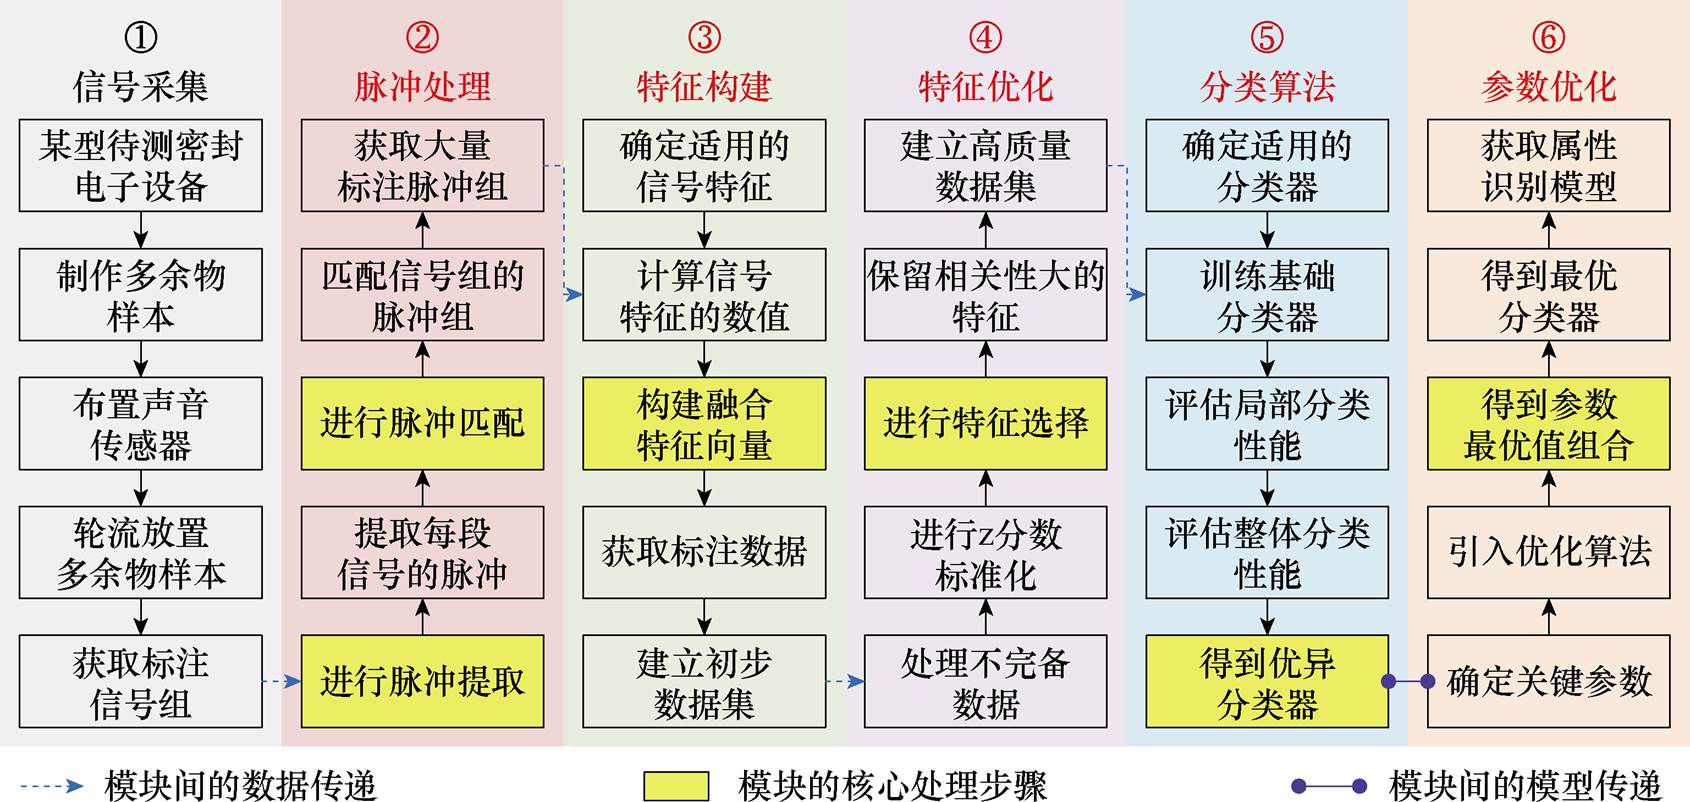
图1 多余物属性识别模型的通用构建流程
Fig.1 General construction process of loose particle attribute recognition models
摘要 现有研究构建了多余物属性识别模型,实现“检测事件”层面数据分类,但未满足“检测任务”层面属性识别要求,未明确模型可靠性对识别结果的作用规律,未分析模型构建流程来定位关键功能模块,进而解释性能可靠性与识别稳定性的协同作用。基于此,该文开展模型可靠性评估与可解释性分析。首先,揭示“检测事件”层面数据分类本质,分析其与“检测任务”层面属性识别相关性,添加多数表决过程获取识别结果。其次,明确模型可靠性对属性识别结果的作用规律,提出识别可靠性定义:退化后模型全局与局部分类性能稳定大于0.5,可获取稳定可靠的属性识别结果。然后,采用累加递进式、单独递进式与顺序失效式分析方法评估模型构建流程中五个功能模块,定位“脉冲处理”与“特征构建”为关键功能模块,解释其对模型识别可靠性的量化结果。最后,在真实应用场景中进行实验,验证模型鲁棒性及该研究必要性与实用性。该文可为模型工业化部署与优化提供参考,是对现有研究的重要补充。
关键词:多余物属性识别模型 可靠性评估 可解释性分析 多数表决过程 关键功能模块
密封电子设备是指通过特定的结构设计、材料应用及工艺手段,在设备外壳或组件接触面之间形成物理屏障,能够有效阻止外部气体、液体、粉尘等异物侵入内部,同时防止内部介质泄漏,从而保障设备在特定环境下可靠运行。然而,在制造过程中,会产生诸如金属碎屑、焊接残留、细导线段等物质。这些产品中存在的由外部进入或内部产生的与产品规定状态无关的一切物质,称为多余物[1]。在航天系统中,密封电子设备通常运行在超失重、剧烈冲击等环境,残留的多余物一旦被激活,会处于碰撞或滑动的随机运动状态,可能撞击内部组件、卡住活动构件、附着电路导致短路等,严重威胁设备的可靠运行[2-3]。因此,密封电子设备在出厂服役前进行多余物检测是至关重要的。
微粒碰撞噪声检测(Particle Impact Noise Detection, PIND)法是目前国际公认并广泛应用的多余物检测方法。该方法通过施加力学激励来激活设备内部的多余物,进而产生碰撞或滑动信号,称为多余物信号。通过示波器或扬声器分析放置在设备表面的声音传感器是否捕获到这些信号,从而判断设备内部是否存在多余物[4]。目前,基于PIND法研制的设备级多余物自动检测系统已经实现对1 mg以上多余物的精确检测[5]。对于体型较大、结构复杂的密封电子设备,在检测到多余物后,需要排查内部空间进行清理。识别多余物的位置能够提供关键参考信息,从而提高清理效率,进一步识别多余物的材质,帮助追溯产生的根源,改进设备制造工艺。因此,密封电子设备内部多余物的位置与材质识别问题一直受到广泛关注。
多余物信号由其碰撞或滑动产生,信号特性能够反映多余物的属性,包括位置与材质。然而,由于密封电子设备内部结构复杂、材料不均匀,信号传播路径呈现多径效应,且衰减特性不规则。传统的信号检测方法(如时差定位法、时频分析法等)主要关注信号的局部特性,难以实现多余物位置与材质的准确识别。机器学习能够从多域提取优质信号特征来完备描述信号特性,并将不同属性的信号转化为具有差异化分布的数据,通过建立多标签数据集来训练分类器,从而完成信号的分类[6]。该方法已广泛应用于声发射检测、故障诊断等领域[7-9]。
前期研究[10]中,作者分别从位于密封电子设备内部不同位置的不同材质多余物产生的多余物信号中提取了多个信号特征,建立了对应多个位置与多种材质的多标签数据集(称为位置与材质数据集),并训练了分类性能良好的分类器(称为多余物位置与材质识别模型),实现了位置与材质数据的准确分类。随后,作者从分类器参数优化[11]、分类算法选择[12-13]、特征选择[14]和不完备数据处理[15]等方面进行深入研究,进一步提升了多余物位置与材质识别模型的分类性能,在七个密闭空间与六种材质的标签数据上,实现了超过90%的位置数据分类精度与80%的材质数据分类精度。
然而,前期研究仅在“检测事件”层面进行标签分类,报告的位置与材质数据分类精度仅反映了分类器在样本层面的性能评估,未能准确反映在“检测任务”层面上的属性识别精度。在实际单次多余物检测中(持续时间为数秒,定义为一次“检测任务”),设备级多余物自动检测系统采集的多余物信号通常包含多个脉冲(对应多余物的多次碰撞或滑动,每个脉冲定义为一个“检测事件”,得到一条数据)。而现有模型并未分析数据分类结果与属性识别结果之间的转换机制,因此在实际应用中现有的多余物属性识别模型缺乏验证。
可靠性是指产品在规定时间和规定条件下,完成规定功能的能力[16]。尽管机器学习模型在工业界和学术界尚未有统一的可靠性定义,但普遍认为其可靠性与在给定条件下完成预期功能的能力密切相关。本文将现有多余物属性识别模型的可靠性定义为:在同工况条件下准确预测“检测事件”数据的位置与材质标签的能力,广义上相当于分类器的分类性能。因此,前述“分样本层面的性能评估”实际上可以看作分类器的可靠性评估,即分类性能的评估。显然,模型的可靠性将直接影响数据分类结果与属性识别结果的准确性,但由于两者转换机制的不明确,现有模型无法充分验证其在实际应用中的有效性。
更进一步地,前期研究主要关注多余物属性识别模型构建过程中的部分功能模块(如分类器参数优化与分类算法选择),忽略了其他功能模块,尤其是特征构建和脉冲处理等上游环节对可靠性的潜在影响。因此,现有的多余物属性识别模型在可靠性分析上存在局限性,且模型构建过程中关键功能模块的作用未被清晰解释。
基于此,本文提出了一种多余物属性识别模型的可靠性评估与可解释性分析方法。首先,揭示了多余物属性识别模型在单次多余物检测中“检测事件”层面数据分类的本质,分析了与“检测任务”层面属性识别的相关性,并明确了数据分类结果与属性识别结果的转换规则。其次,探索了模型可靠性对属性识别结果的影响,定义了适用于多余物属性识别模型的识别可靠性,并进行了验证。然后,可解释性分析了多余物属性识别模型的构建流程及各功能模块,从多角度量化评估了各功能模块对模型可靠性的影响,定位了关键功能模块,并解释了这些模块对属性识别结果的作用机制。最后,通过在真实应用场景中的大量实验,验证了所提方法的实用性、可行性和鲁棒性。
本文的主要创新如下:①首次提出了多余物属性识别模型的“识别可靠性”定义,通过结合全局与局部分类性能的退化情况,量化了在不同工况条件下模型的可靠性,为机器学习模型在复杂应用场景中的稳定性评估提供了新的视角。②创新性地引入了多数表决过程,实现了从“检测事件”层级的分类结果到“检测任务”层级的属性识别结果的有效转换,填补了现有模型无法直接从分类结果得到可靠属性识别结果的空白。③系统地进行了多余物属性识别模型构建流程的可解释性分析,通过采用三种不同的分析方法(累加递进式、单独递进式与顺序失效式),量化评估了各功能模块对模型可靠性的贡献,成功定位了“脉冲处理”和“特征构建”为关键功能模块,为模型的优化与工业应用提供了实践指导。
前期开展了基于机器学习的密封电子设备多余物位置与材质识别方法的研究,分别构建了分类性能良好的多余物位置与材质识别模型,即多余物属性识别模型,其通用构建流程如图1所示,包括六个递进的模块。其中,“信号采集”是基础模块,是构建多余物属性识别模型的数据基础。其他五个模块是功能模块,是构建多余物属性识别模型的功能设计。此处不详细介绍各功能模块,仅提供处理流程,详细细节可参考作者前期作品[10-15]。
图1 多余物属性识别模型的通用构建流程
Fig.1 General construction process of loose particle attribute recognition models
如前所述,在标注位置与材质标签的数据集上,可以训练分类性能良好的多余物属性识别模型。对于待测密封电子设备,单次多余物检测得到一次“检测任务”,其包含的多个“检测事件”对应多条未标注数据。模型能够给出“检测事件”数据的标签预测结果,但不能给出“检测任务”的属性识别结果。因此,需要设计一个转换规则,将数据分类结果转换为属性识别结果。同时,多余物属性识别模型的分类性能直接决定了多条未标注数据中标签正确预测的数据占比,对上述转换规则至关重要。因此,需要对模型的可靠性进行评估,确保其具有稳定且优异的分类性能,并将该优势延续至数据分类结果到属性识别结果的转换中,以此满足真实应用场景下多余物位置与材质准确识别的要求。此外,多余物属性识别模型构建流程中涉及多个功能模块,均对分类性能产生作用。因此,需要对模型进行可解释性分析,探索不同功能模块对分类性能的作用规律并进行量化比较,确定关键功能模块,解释它们对模型可靠性的影响。基于此,提出模型的性能稳定与正向优化建议。图2给出了多余物属性识别模型的可靠性评估与可解释性分析示意图。
在多余物属性识别模型的构建过程中,可靠性评估是确保模型在未知数据中稳定表现的关键创新。假设在标注位置与材质标签的数据集上训练的多余物属性识别模型取得的通用分类精度(包含位置与材质数据分类精度)为p,p∈[0, 1],即认定模型的初始分类性能为p,也即模型对已标注数据(先验数据)预测正确的比例。对于待测密封电子设备,假设单次多余物检测得到的一次“检测任务”包含m个“检测事件”数据,模型能够正确预测m×p条数据的标签,且这些标签相同且唯一。
然而,在实际情况中,模型的分类性能p通常小于1,因此m条未标注数据的标签可能不完全相同。为了解决这一问题,引入了多数表决过程。对于标签不完全相同的情况,赋予正确预测的m×p条数据更多的投票权,并通过多数表决机制确定最终的共同标签,即属性识别结果。这个过程是从“检测事件”层面到“检测任务”层面结果的转化机制。
此外,考虑到模型性能的退化效应,即,模型在面对未知数据(通常考虑同工况条件下)时的分类性能会降低[17],本文定义了全局分类性能退化下限DO与局部分类性能退化下限DLi(i=1, 2,…, c),代表属性类别数量。退化的全局分类性能和局部分类性能在一定条件下存在一个退化阈值q,q=max{DO, DLi}。当q满足p-q>0.5时,模型仍然能够通过多数表决过程输出稳定可靠的属性识别结果。
由此,给出多余物属性识别模型识别可靠性的定义:同工况条件下多余物属性识别模型的性能发生退化,若其全局分类性能与局部分类性能均稳定大于0.5,就能够通过多数表决过程实现准确的属性识别。具体而言,在多余物属性识别模型中,退化后的分类性能不可能达到完美分类,但只要模型的分类稳定性满足阈值要求,即,全局分类性能与局部分类性能都稳定大于0.5,模型在实际应用中仍能保证多余物位置与材质的识别结果的高精度。
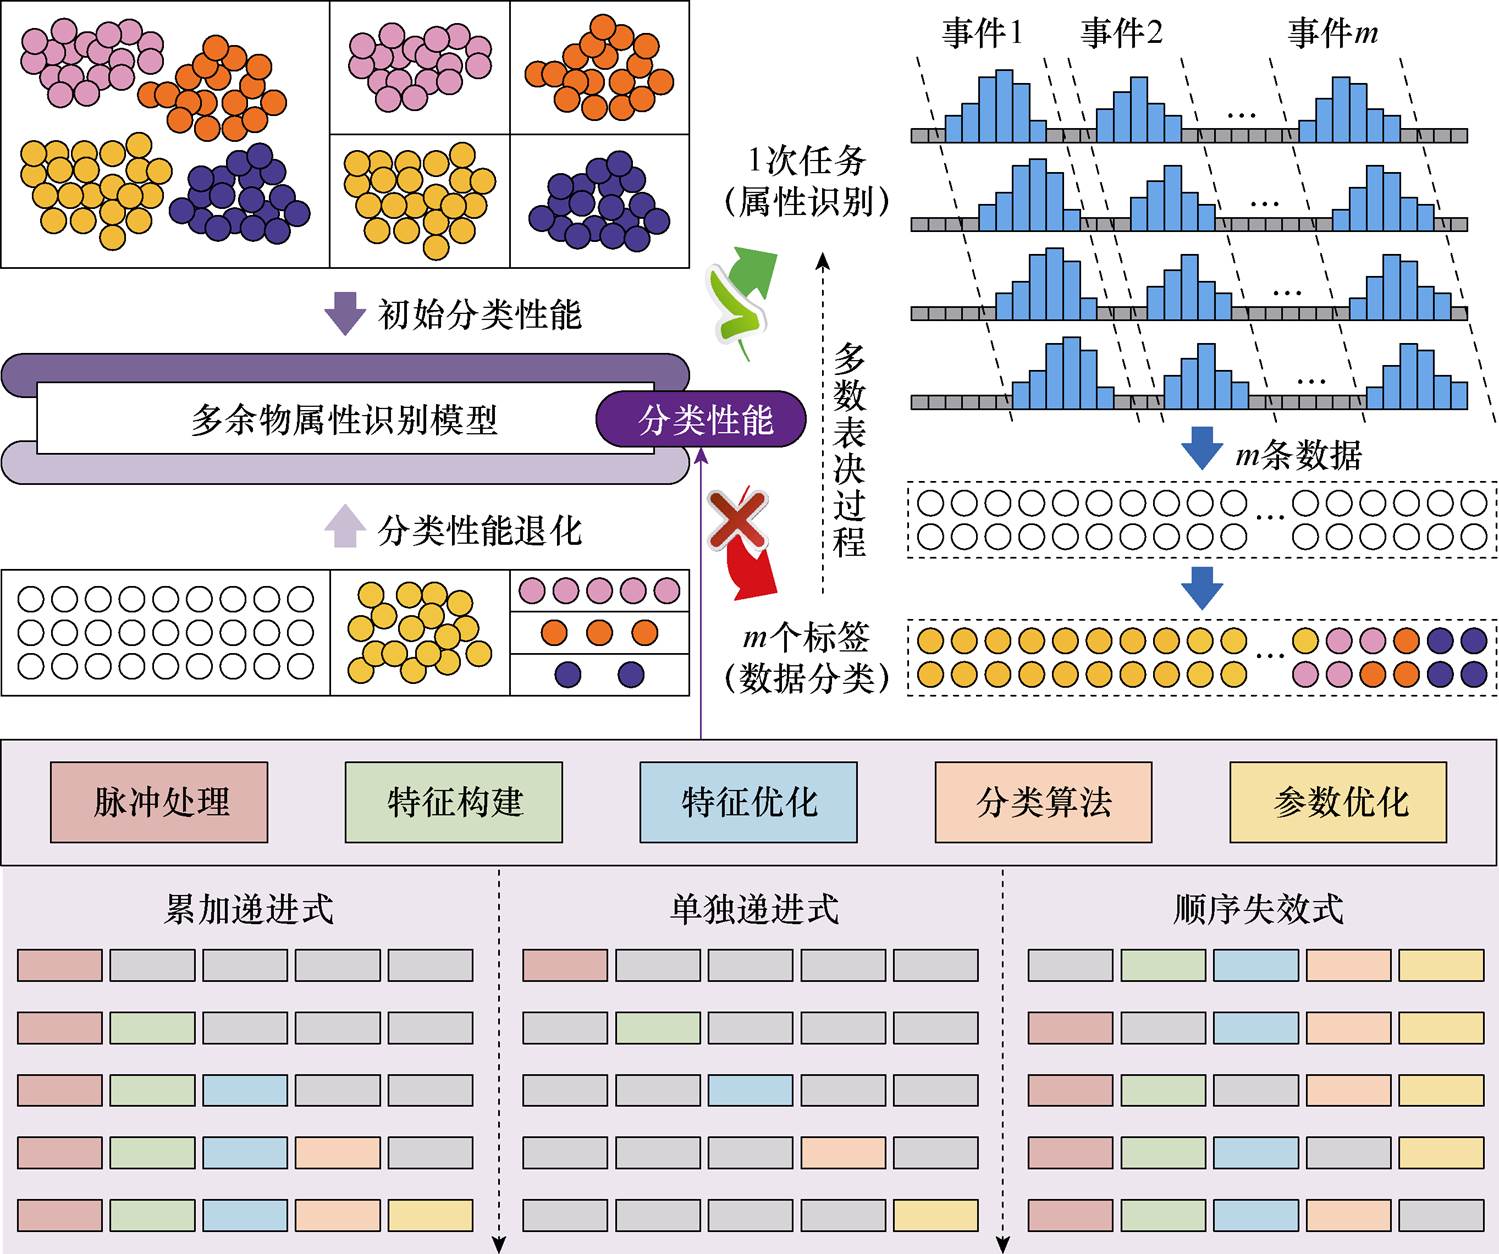
图2 可靠性评估与可解释性分析示意图
Fig.2 Schematic diagram of reliability assessment and interpretability analysis
为展示可靠性评估的创新工作,图3给出了核心算法流程。

图3 可靠性评估的核心算法流程
Fig.3 Core algorithm process of reliability assessment
由图1可知,多余物属性识别模型的构建流程包含五个功能模块:脉冲处理、特征构建、特征优化、分类算法与参数优化。这些模块分别对模型的分类性能产生不同程度的影响,且它们之间存在相互作用。其中,“脉冲处理”“特征构建”与“特征优化”视为上游环节,产生间接作用;“分类算法”与“参数优化”视为所在环节,产生直接作用。一直以来,在声发射检测、故障诊断等领域的信号识别研究及作者前期研究中,“分类算法”与“参数优化”是被重点关注的用来提升分类器分类性能的功能模块,且它们对分类性能产生的直接作用也被量化展示[11-13, 18]。近年来,“特征优化”逐步受到关注,其对分类性能产生的间接作用同样被量化展示[14-15, 19]。但“脉冲处理”与“特征构建”一直被视为构建流程中的两个基础环节,未被单独分析。
需指出的是,“脉冲处理”用于提取和匹配信号组中的脉冲组。一个脉冲组及其包含的多个脉冲代表多余物的一次碰撞或滑动产生的能量被多个声音传感器同时捕获。这不仅提取了信号组中与多余物相关的信号成分,并且完成了信号成分之间的位移匹配,是建立数据集的重要基础[20]。同样地,一方面,“特征构建”从多域中选择尽可能完备且适用的信号特征来完整描述不同属性的信号组之间的差异;另一方面,“特征构建”将由同一信号组构建的特征向量融合在一起,有效保留多个声音传感器之间的相关性与互补性,是一种高效的多源信息融合方式[10]。由此可知,“脉冲处理”与“特征构建”均是建立数据集的重要基础。因此,需要对多余物属性识别模型构建流程中的五个功能模块进行全面分析。
表1给出了五个功能模块的详细描述,包括核心处理步骤与默认失效操作。当五个功能模块全部失效时,通过默认失效操作训练的模型称为功能模块失效模式下的多余物属性识别模型,其取得的分类精度称为功能模块失效模式下的分类性能。
表1 功能模块的详细描述
Tab.1 Detailed description of functional modules
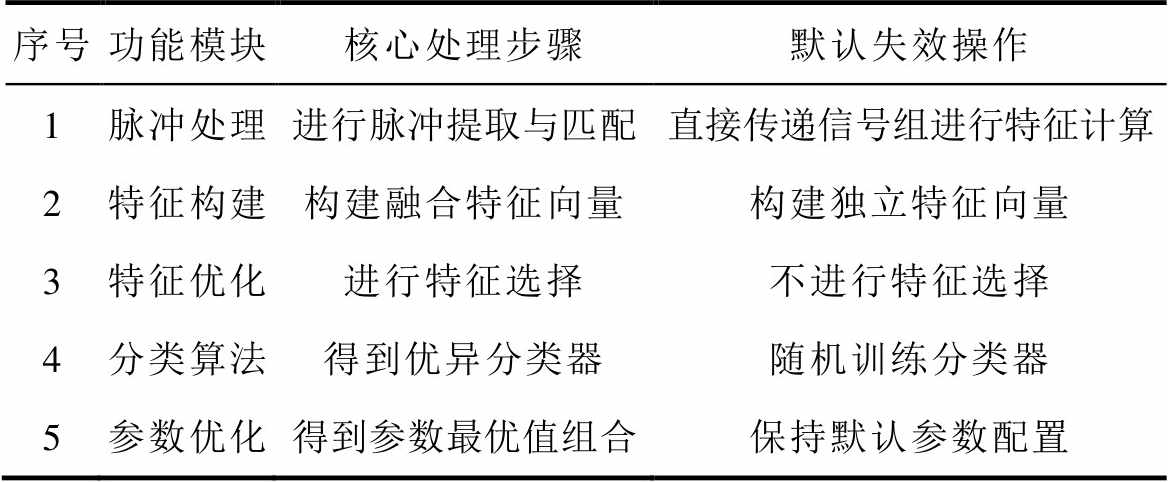
序号功能模块核心处理步骤默认失效操作 1脉冲处理进行脉冲提取与匹配直接传递信号组进行特征计算 2特征构建构建融合特征向量构建独立特征向量 3特征优化进行特征选择不进行特征选择 4分类算法得到优异分类器随机训练分类器 5参数优化得到参数最优值组合保持默认参数配置
为了深入理解每个功能模块的作用,进行了可解释性分析,并通过三种分析方法(累加递进式、单独递进式和顺序失效式)来量化评估每个功能模块的贡献。
第一种是累加递进式,具体来说,先训练功能模块失效模式下的多余物属性识别模型,并统计它的分类性能为A_Acc0。基于此,参考表1,每次顺序作用一个功能模块,并统计分类性能A_Acci,i表示功能模块的序号(i=1, 2,…, 5)。需补充的是,当i>1时,除了当前作用的功能模块外,此前已经作用的功能模块仍保持作用。本文新定义性能提升率PIRi,如式(1)所示,表示当前功能模块作用时,多余物属性识别模型分类性能的提升幅度与剩余空间的比值。计算五个功能模块递进作用时的性能提升率,量化它们对多余物属性识别模型的分类性能产生的作用。对五个性能提升率进行降序排序,确定关键功能模块。
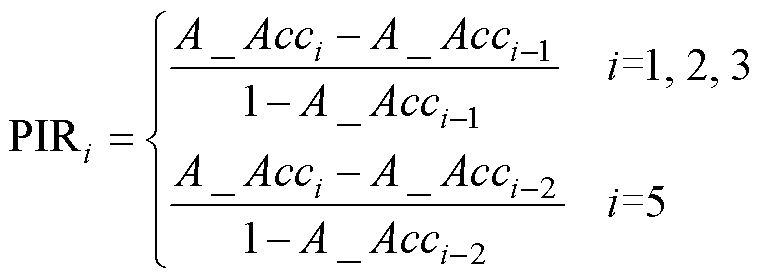 (1)
需要注意的是,尽管功能模块失效模式下的多余物属性识别模型是随机训练的,但一旦某个模型被训练,其对应的分类算法也被确定。即“分类算法”实际上已经提前作用,因为当“分类算法”作用时,没有用于对比的其他分类算法,其本身就是唯一的分类算法。因此,本文给出补充说明:当“分类算法”作用时,在此前三个功能模块继续作用的基础上,分别训练不同类别的具有代表性的多个分类器,计算它们的平均分类性能。计算多余物属性识别模型的分类性能与平均分类性能的差值绝对值,作为“分类算法”作用时的性能提升率PIR4。
第二种是单独递进式。具体来说,先训练功能模块失效模式下的多余物属性识别模型。基于此,参考表1,每次顺序作用一个功能模块,并统计分类性能I_Acci。需补充的是,当i>1时,除了当前作用的功能模块外,此前已经作用的功能模块不再作用。此时,五个功能模块单独作用时的分类性能I_Acci,就是量化它们对多余物属性识别模型的分类性能产生的作用。对五个分类性能I_Acci进行降序排序,确定关键功能模块。
同样地,该方法中,“分类算法”已经提前作用。因此,本文给出补充说明:当“分类算法”作用时,在此前三个功能模块不再作用的基础上,分别训练不同类别的具有代表性的多个分类器,计算它们的平均分类性能。计算多余物属性识别模型的分类性能与平均分类性能的比值,作为“分类算法”作用时的分类性能I_Acc4。
第三种是顺序失效式。具体来说,与训练功能模块失效模式下的多余物属性识别模型相反,全部作用五个功能模块(“分类算法”单独描述),训练功能模块全效模式下的多余物属性识别模型。基于此,参考表1,每次顺序失效一个功能模块,并统计分类性能L_Acci。需补充的是,当i>1时,除了当前失效的功能模块外,此前已经失效的功能模块重新作用。此时,五个功能模块顺序失效时的分类性能L_Acci,就是量化的它们对多余物属性识别模型的分类性能产生的作用。对五个分类性能L_Acci进行升序排序,确定关键功能模块。
需注意的是,该方法中,“分类算法”作为训练多余物属性识别模型的基础,无法失效。因此,本文给出补充说明:当“分类算法”失效时,在此前三个功能模块重新作用的基础上,分别训练不同类别的具有代表性的多个分类器并进行“参数优化”处理,再计算它们的平均分类性能。进一步地,由式(2)得到“分类算法”失效时的分类性能L_Acc4。
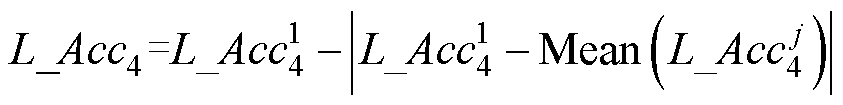
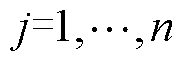 (2)
式中,Mean( · )为均值函数;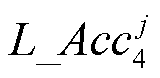 为基于参数优化的其他分类器的分类性能;
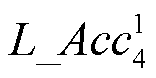 为基于参数优化的XGBoost的分类性能;j为分类器的序号;n为分类器的数量。
同样地,为了展示可解释性分析的创新工作,图4给出了核心算法流程。
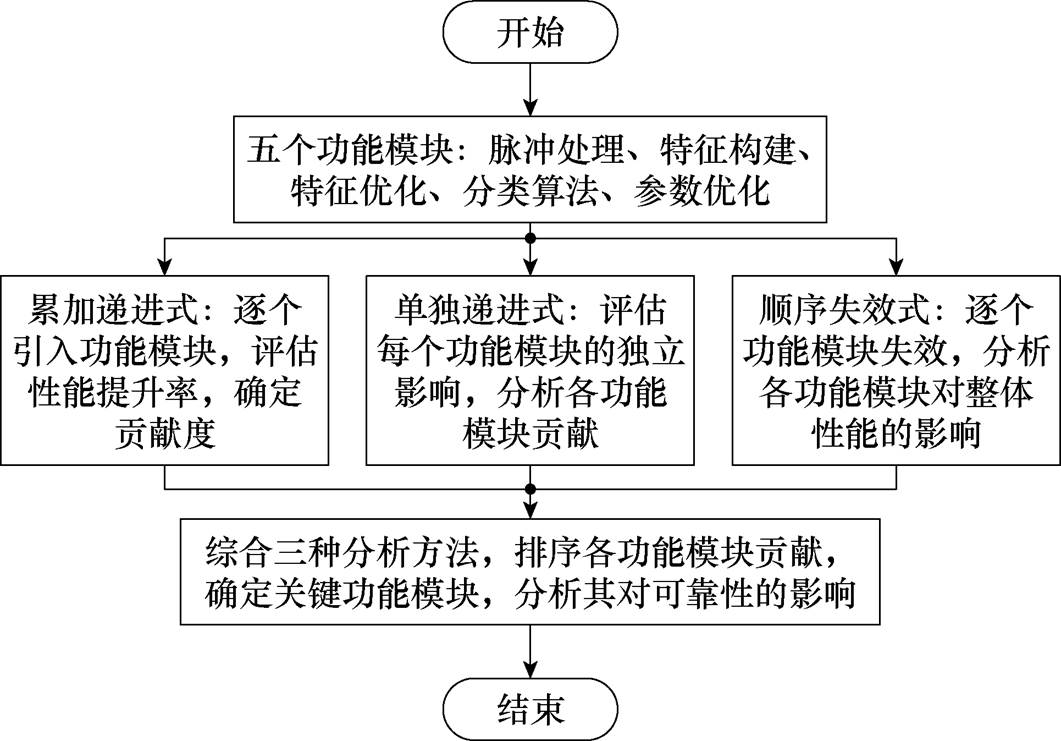
图4 可解释性分析的核心算法流程
Fig.4 Core algorithm process of interpretability analysis
本文以航天系统中某型电子单机模块为待测密封电子设备,如图5a所示,其内部包含七个彼此独立的密闭空间。该型电子单机模块最新多余物检测信息表明,四种金属(铝、锡、铁、铜)与一种非金属(硅胶)材质的多余物常被检测。因此,本文以相同形状但质量最小的五种材质为多余物样本,包括:1.0 mg铝屑、1.0 mg锡粒、0.8 mg铁片、1.0 mg铜丝与46.0 mg的硅胶粒,如图5b所示。由此,本文涉及七个位置标签与五个材质标签。
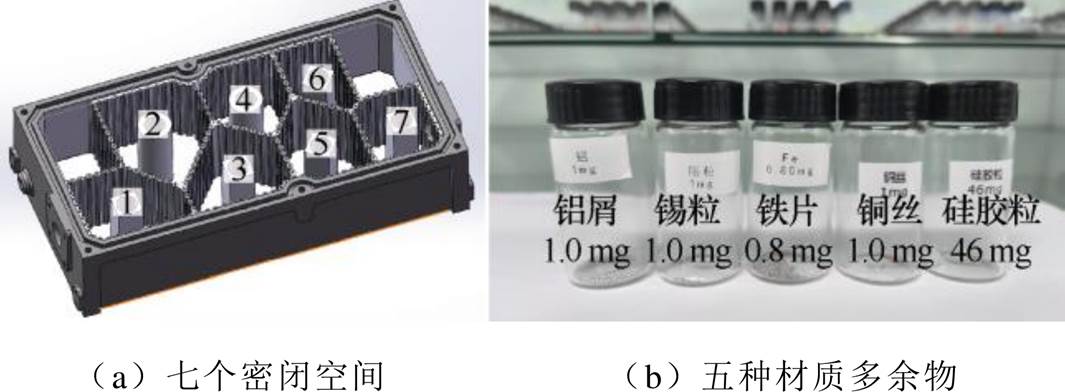
图5 待测设备与多余物样本
Fig.5 Equipment under test and loose particle samples
基于PIND法,将待测设备固定在振动台上,按照现有布局方案在表面不同位置放置四个声音传感器。参考GJB 548C—2021[21],驱动装置控制振动台提供正弦激励与随机加速,激活待测设备内部多余物,产生多余物信号。四个声音传感器同时捕获多余物信号,将信号通过专用传输线发送到设备级多余物自动检测系统保存,用于后续处理。图6给出了实验现场图,表2给出了正弦激励与随机加速参数。需指出的是,本文使用的设备级多余物自动检测系统是课题组自研的DZJC-Ⅲ型多余物自动检测系统[5],曾获国家科技进步二等奖。
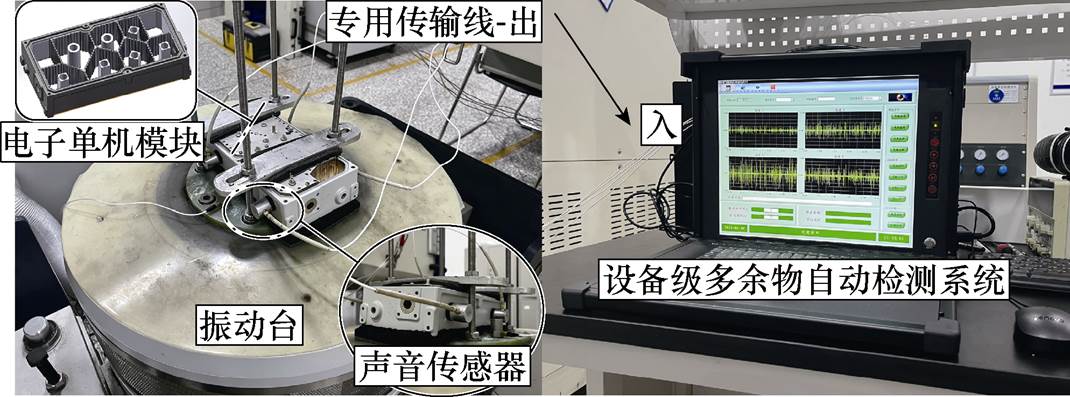
图6 实验现场图
Fig.6 Experimental site map
表2 正弦激励与随机加速参数
Tab.2 Parameters of sinusoidal excitation and random acceleration
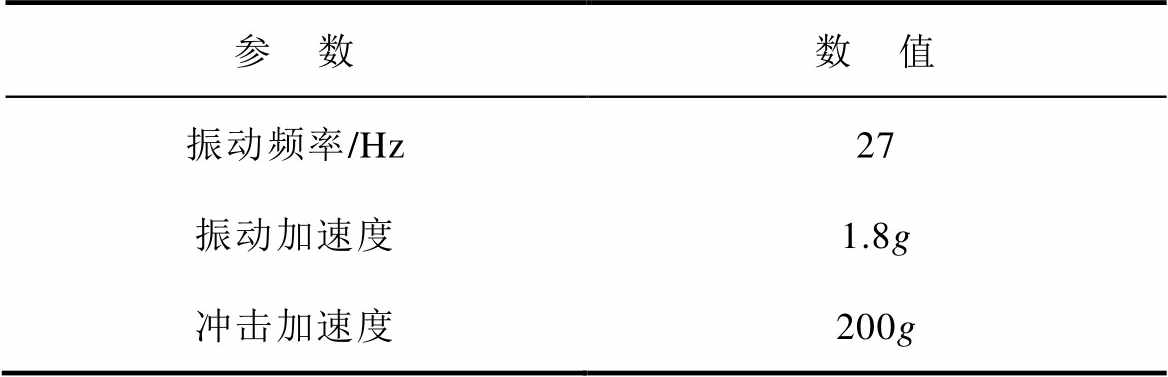
参 数数 值 振动频率/Hz27 振动加速度1.8g 冲击加速度200g
此外,实验环境中不可避免地存在背景噪声、机械激励残余响应及结构本底振动等干扰。本文通过设备固定、传输线屏蔽和多轮筛选等方式抑制噪声影响,保留具有代表性的多余物信号组用于模型构建。总体而言,实验对象所处环境属于典型的低信噪比(20~40 dB)、多路径传播和复杂结构耦合条件,所采集的多余物信号具有较好的工程代表性。此外,参考中国军用标准GJB 65B[21],声音传感器在每次实验前被重新校准(校准误差小于1 dB,对应声压级测量误差小于12.2%)。
基于第1节中多余物属性识别模型的构建流程,轮流将五种材质的多余物放置在七个密闭空间中。在每种材质的多余物放置在每个密闭空间期间,振动台激活多余物来持续产生多余物信号,四个声音传感器同时进行100次信号采集。每次信号采集得到四段多余物信号,形成一个信号组,100次信号采集共得到100个信号组。五种材质的多余物与七个密闭空间,共得到100×7×5=3 500个信号组,每个信号组对应标注了位置与材质标签。由此,每类位置或材质标签对应500或700个信号组。
接着,进行五个功能模块的顺序处理来构建多余物属性识别模型,包括一个位置识别模型与一个材质识别模型。这两个识别模型均是基于参数优化的XGBoost(树结构类型),其分类性能均被证明优于基于参数优化的其他类型分类器,包括数学理论类型的K近邻(K-Nearest Neighbor, KNN)和使用径向基核函数的支持向量机(Radial Basis Function- Support Vector Machine, RBF-SVM)、树结构类型的随机森林、神经网络类型的反向传播神经网络(Back Propagation-Neural Network, BPNN)与一维卷积神经网络(1-Dimension Convolutional Neural Network, 1D-CNN)[22-24]。其中,多余物位置识别模型取得的分类精度为0.929 6,多余物材质识别模型取得的分类精度为0.951 4,均为全局分类性能。
需要补充的是,“脉冲处理”处理结束时,大量脉冲组从3 500个信号组中得到,对应标注了位置与材质标签。“特征构建”处理结束时,表3所示时域与频域中11个信号特征的数值分别在每个信号组中四段多余物信号上计算,得到四个特征向量来构建一个融合特征向量,同样对应标注了位置与特征标签,由此得到标注数据。在此基础上,分别根据标注数据的位置与材质标签,建立初步位置数据集与初步材质数据集。表4给出了两个初步数据集的描述。“特征优化”处理结束时,适用多余物位置与材质识别的专属位置与材质特征分别从11个信号特征中选择,时域与频域中的信号特征见表3。分别保留初步位置数据集与初步材质数据集中专属位置与材质特征对应的列特征数据,建立高质位置数据集与高质材质数据集。
表3 时域与频域中的信号特征
Tab.3 Signal features in time and frequency domains
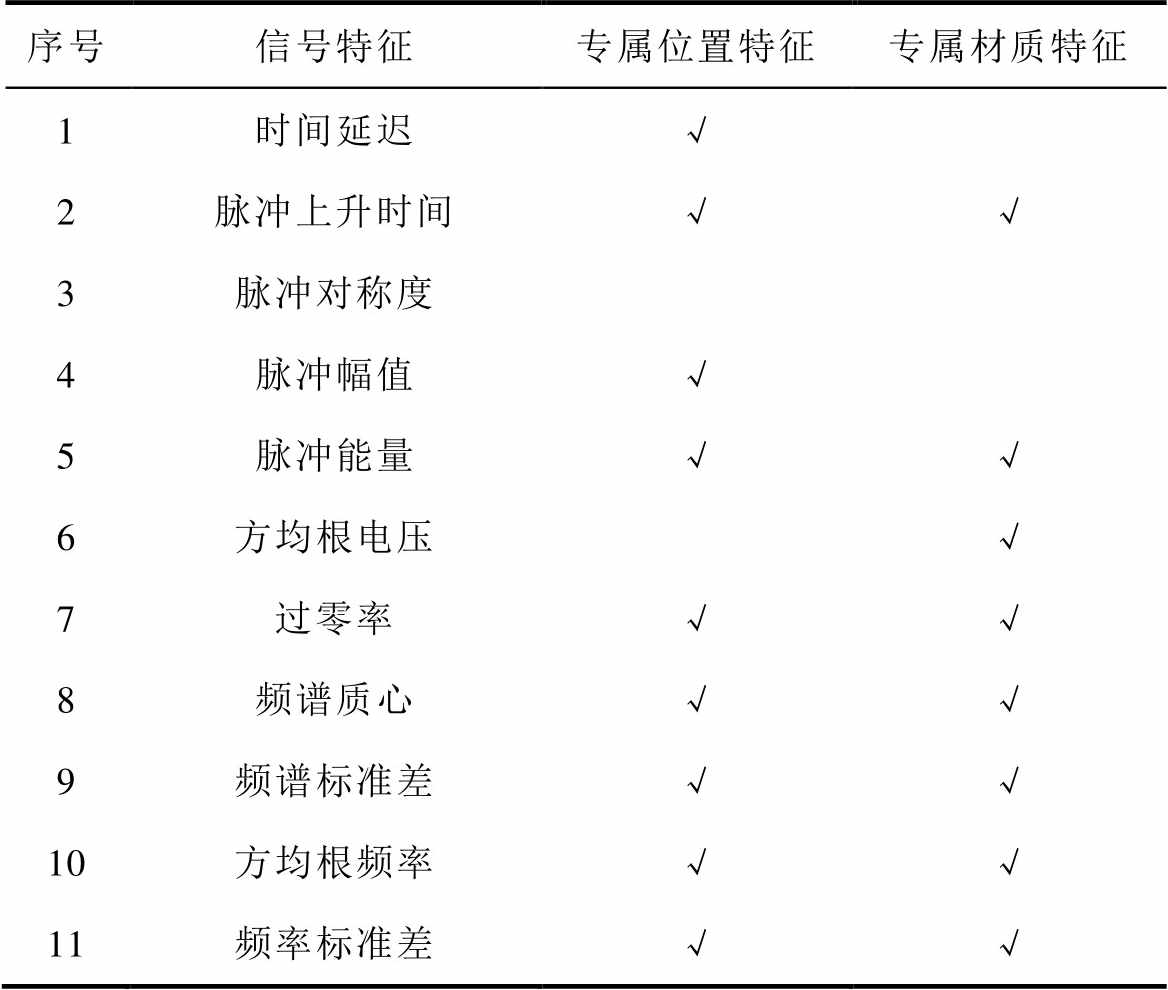
序号信号特征专属位置特征专属材质特征 1时间延迟√ 2脉冲上升时间√√ 3脉冲对称度 4脉冲幅值√ 5脉冲能量√√ 6方均根电压√ 7过零率√√ 8频谱质心√√ 9频谱标准差√√ 10方均根频率√√ 11频率标准差√√
3.3.1 同工况-同设备同样本
基于3.1节中某型电子单机模块与多余物样本,采用3.2节中描述的“信号采集”过程。在同工况条件下,轮流将五种材质的多余物放置在七个密闭空间。在每种材质的多余物放置在每个密闭空间期间,四个声音传感器同时进行10次信号采集,共得到350个信号组。每个信号组对应标注了位置与材质标签。通过“脉冲处理”“特征构建”与“特征优化”的顺序处理,根据位置与材质标签,分别建立一个位置评估集与一个材质评估集,并重复此过程50次以建立50个位置评估集与50个材质评估集。
表4 两个初步数据集的描述
Tab.4 Description of two preliminary datasets
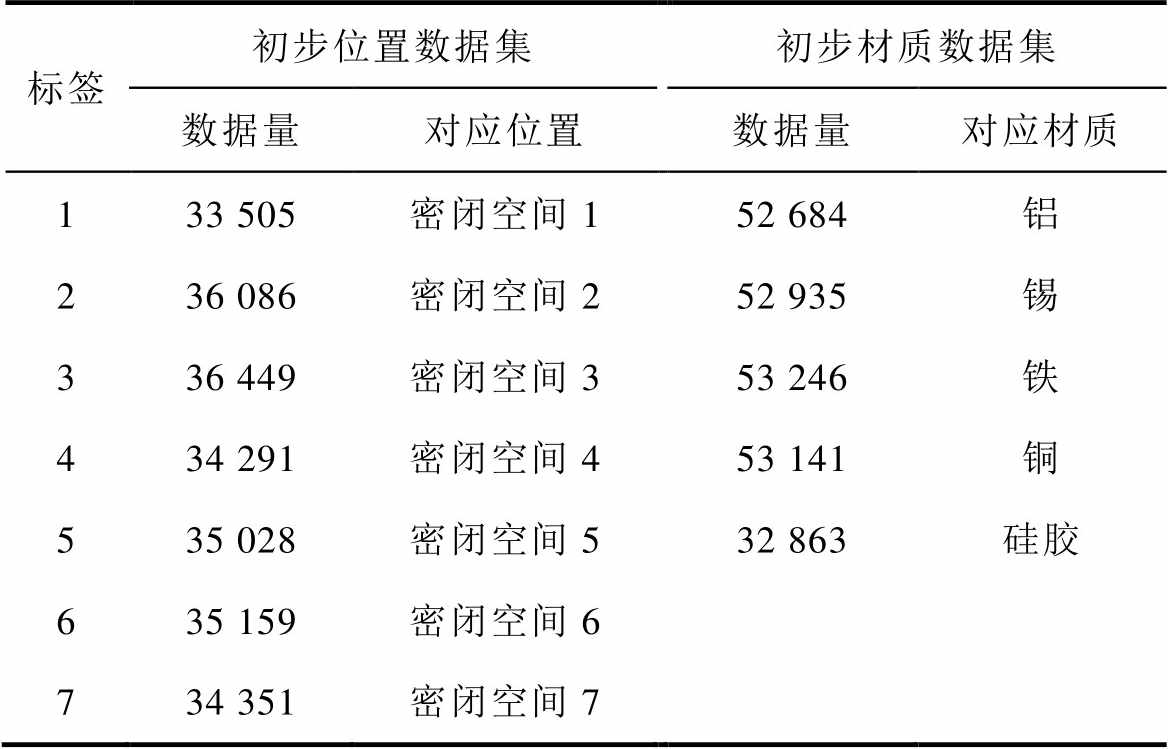
标签初步位置数据集初步材质数据集 数据量对应位置数据量对应材质 133 505密闭空间152 684铝 236 086密闭空间252 935锡 336 449密闭空间353 246铁 434 291密闭空间453 141铜 535 028密闭空间532 863硅胶 635 159密闭空间6 734 351密闭空间7
应用3.2节中的位置识别模型和材质识别模型在评估集上进行预测。通过统计每个模型在整个评估集上取得的分类精度,绘制全局分类性能散点图,如图7与图8所示。同时,分别统计每个模型在评估集内每类标签数据上取得的分类精度,视为局部分类性能,计算位置与材质识别模型在50个评估集内每类标签数据上取得的最低分类精度,见表5与表6。
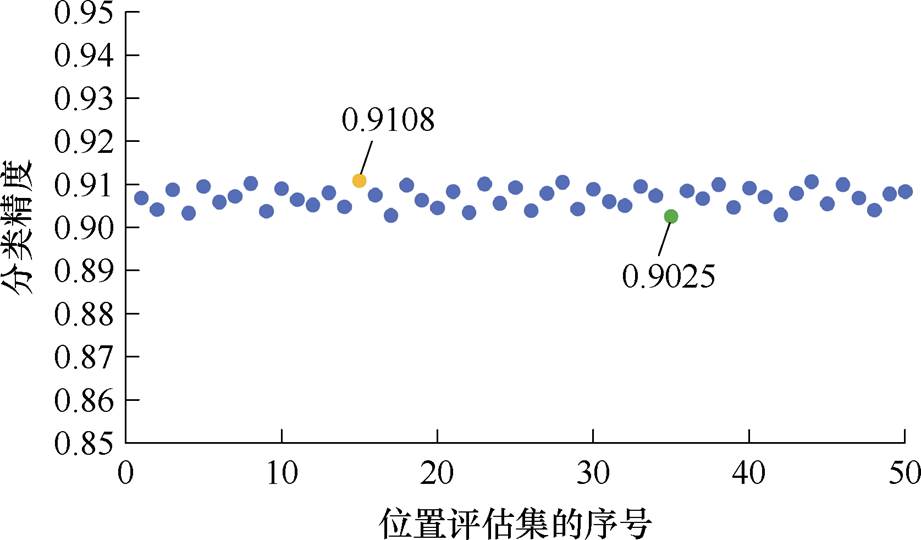
图7 位置识别模型全局分类性能散点图Ⅰ
Fig.7 Scatter plot of global classification performance of location recognition model Ⅰ
由图7与图8可知,位置识别模型在第15个位置评估集上取得最高的分类精度,为0.910 8,在第35个位置评估集上取得最低的分类精度,为0.902 5。较3.2节中取得的0.929 6的分类精度,全局分类性能均有小幅度退化。经过计算,位置识别模型在50个位置评估集上取得的平均分类精度为0.907 0,虽较0.929 6下降了0.022 6,但仍显著高于0.5。材质识别模型在第25个材质评估集上取得最高的分类精度,为0.941,在第4个材质评估集上取得最低的分类精度,为0.937。较3.2节中取得的0.951 4的分类精度,全局分类性能同样均有小幅度退化。经过计算,材质识别模型在50个材质评估集上取得的平均分类精度为0.938 7,虽较0.951 4下降了0.012 7,但仍显著高于0.5。
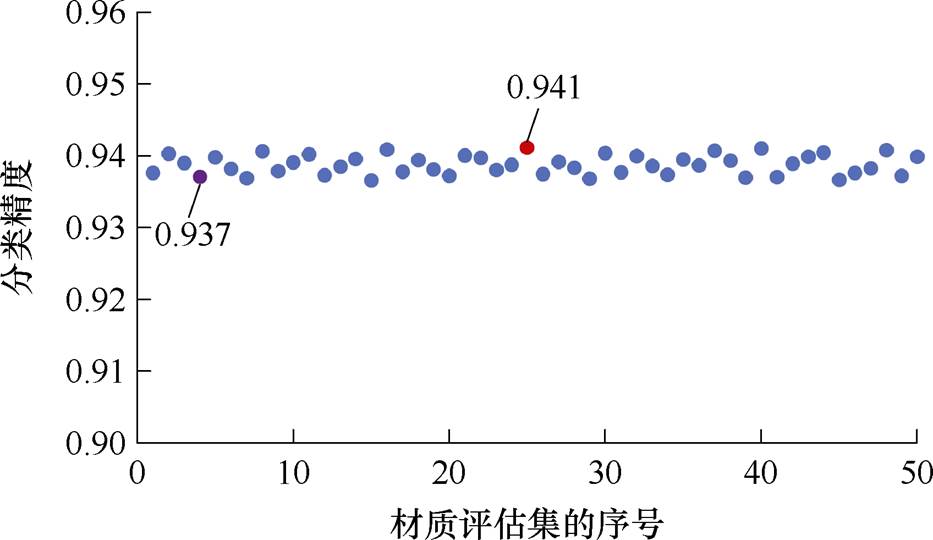
图8 材质识别模型全局分类性能散点图Ⅰ
Fig.8 Scatter plot of global classification performance of material recognition model Ⅰ
表5 位置识别模型局部分类性能比较结果Ⅰ
Tab.5 Comparison results of local classification performance of location recognition model Ⅰ
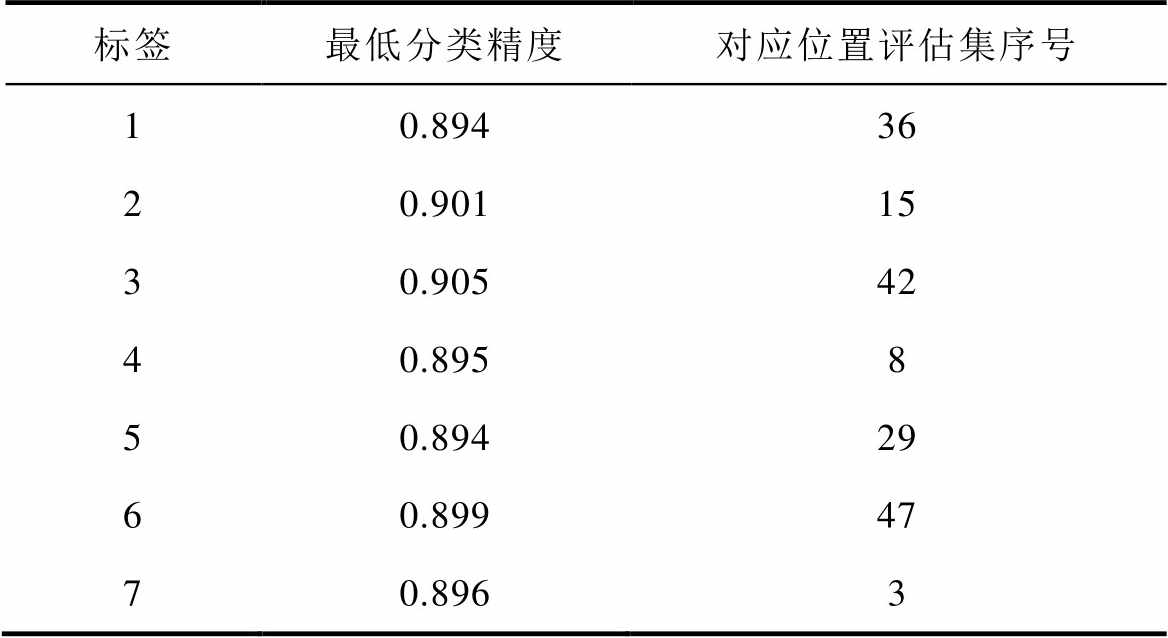
标签最低分类精度对应位置评估集序号 10.89436 20.90115 30.90542 40.8958 50.89429 60.89947 70.8963
表6 材质识别模型局部分类性能比较结果Ⅰ
Tab.6 Comparison results of local classification performance of material recognition model Ⅰ
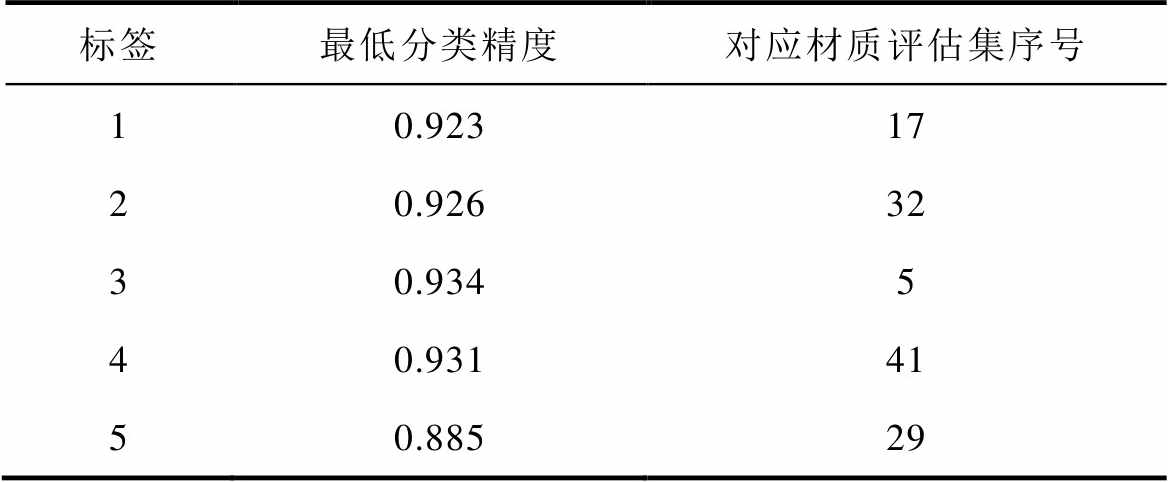
标签最低分类精度对应材质评估集序号 10.92317 20.92632 30.9345 40.93141 50.88529
由表5与表6可知,位置识别模型在每类标签数据上取得的最低分类精度均接近0.9(远高于0.5),彼此之间差异较小,显示模型稳定的局部分类性能。同时,位置识别模型在每类标签数据上取得的最低分类精度均接近取得的0.907 0的平均分类精度,说明位置识别模型的全局与局部分类性能的一致性较高,同时具有显著的全局与局部分类性能。材质识别模型在标签为“1”“2”“3”“4”的数据上取得的最低分类精度均高于0.92,甚至0.93(远高于0.5),接近取得的0.938 7的平均分类精度。相比之下,材质识别模型在标签为“5”的数据上取得的最低分类精度低于0.89,虽与取得的0.938 7的平均分类精度存在一定差距,但也远高于0.5。这显示了材质识别模型对金属材质多余物的偏好。
相较于金属材质,硅胶质地柔软、硬度较小。在相同力学激励下,硅胶质量通常需要是金属材质质量的几十倍才能在碰撞或滑动过程中由弹性形变释放同等能量,由此产生同等幅度的多余物信号。但也因为硅胶质量相对较大,在施加力学激励的同一时间区间内,碰撞或滑动的频率相对较低。这样,由硅胶产生的多余物信号中脉冲数量相对较少,材质数据集与材质评估集中对应标签的数据量较小。这可以从表4中得到验证。
综上所述,在同工况条件下,多余物位置与材质识别模型的全局与局部分类性能均显著高于0.5,验证了模型的可靠性。
3.3.2 同工况-新设备新样本
进一步地,以3.1节中某型电子单机模块与五种材质多余物样本为参考,重新选择相同型号的电子单机模块为待测密封电子设备,重新选择相同形状但不同质量的五种材质多余物样本。其中,金属材质多余物的质量在1.0~3.0 mg之间,硅胶的质量在46.0~80.0 mg之间。表7给出了本文随机选择的五组多余物样本。
表7 五组多余物样本
Tab.7 Five sets of loose particle samples (单位: mg)
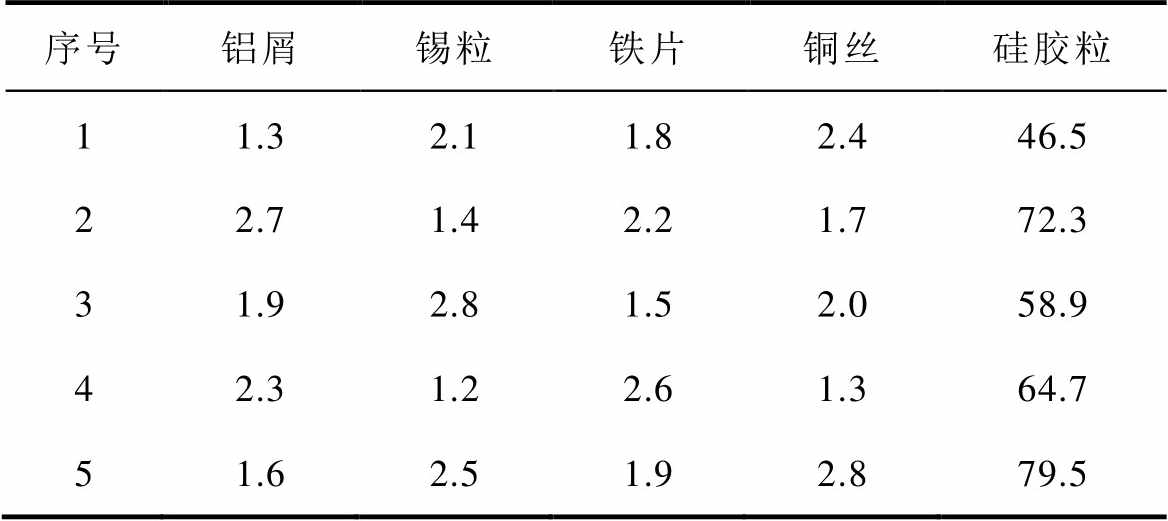
序号铝屑锡粒铁片铜丝硅胶粒 11.32.11.82.446.5 22.71.42.21.772.3 31.92.81.52.058.9 42.31.22.61.364.7 51.62.51.92.879.5
采用与3.3.1节中建立评估集相同的处理过程,由新的待测密封电子设备与五组多余物样本分别建立50个位置评估集与50个材质评估集。基于此,同样应用3.2节的位置识别模型和材质识别模型在评估集上进行预测。通过统计每个模型在整个评估集上取得的分类精度,绘制全局分类性能散点图,如图9与图10所示。同时,分别统计每个模型在评估集内每类标签数据上取得的分类精度,视为局部分类性能,计算位置与材质识别模型在50个评估集内每类标签数据上取得的最低分类精度,如图11与图12所示。
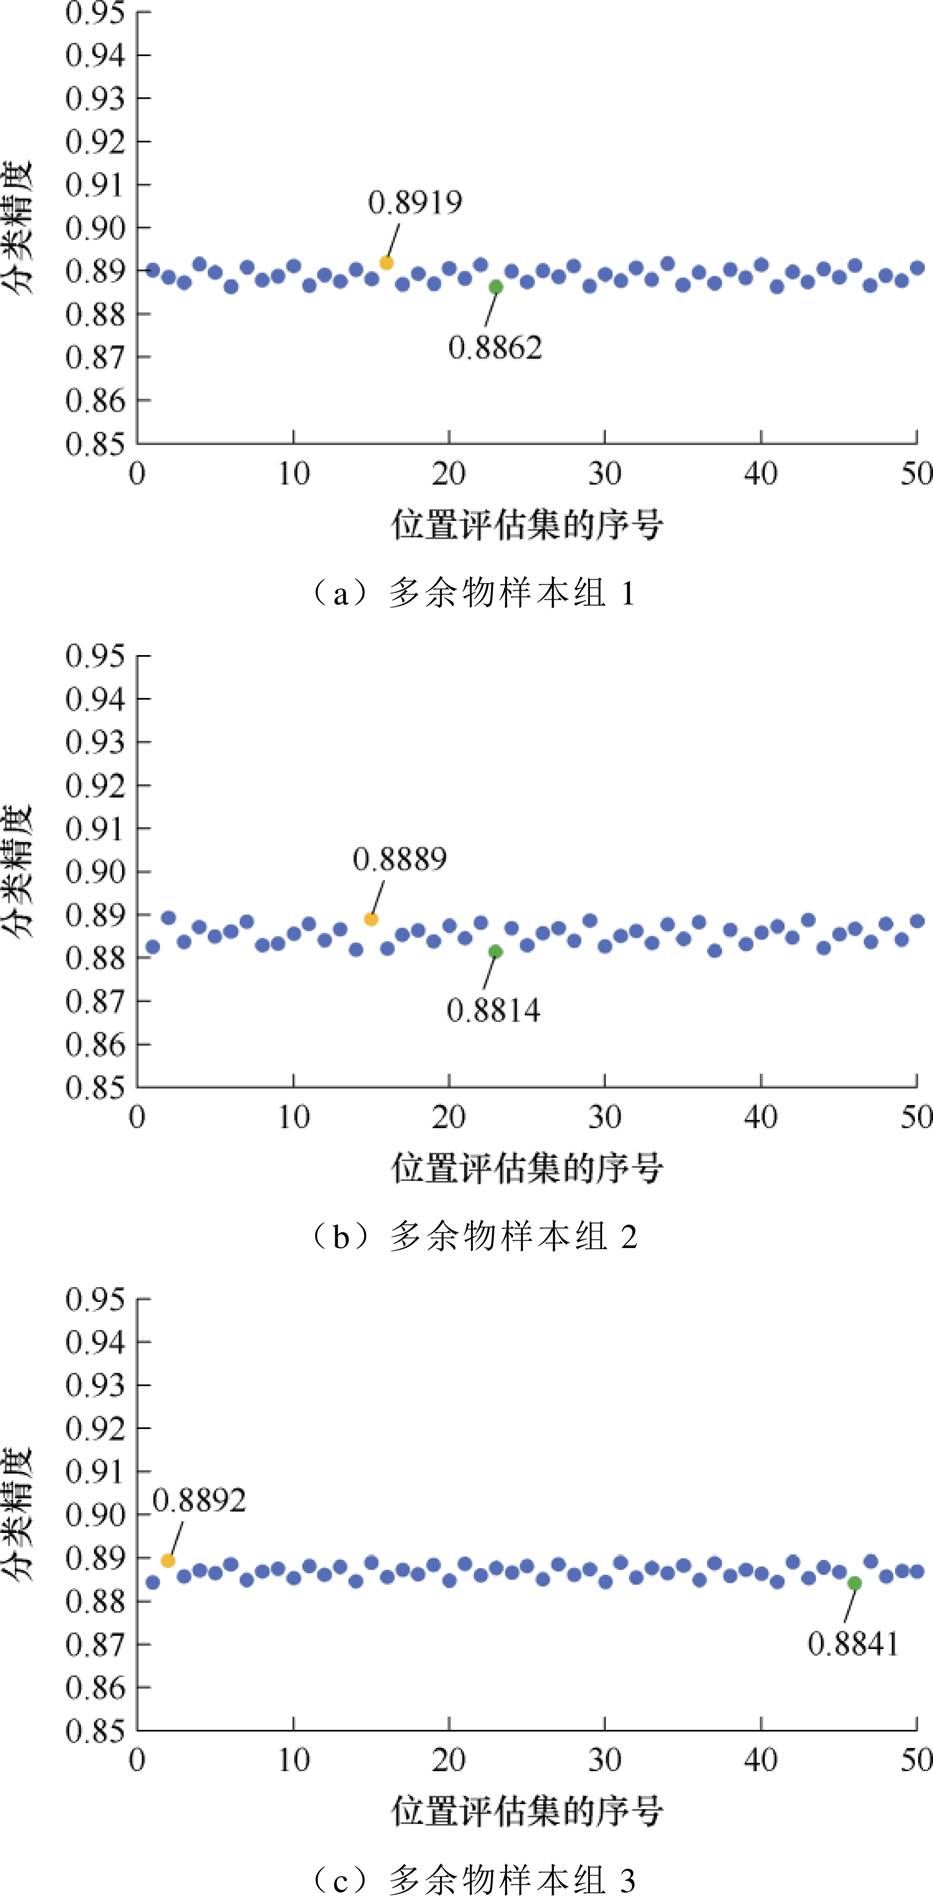
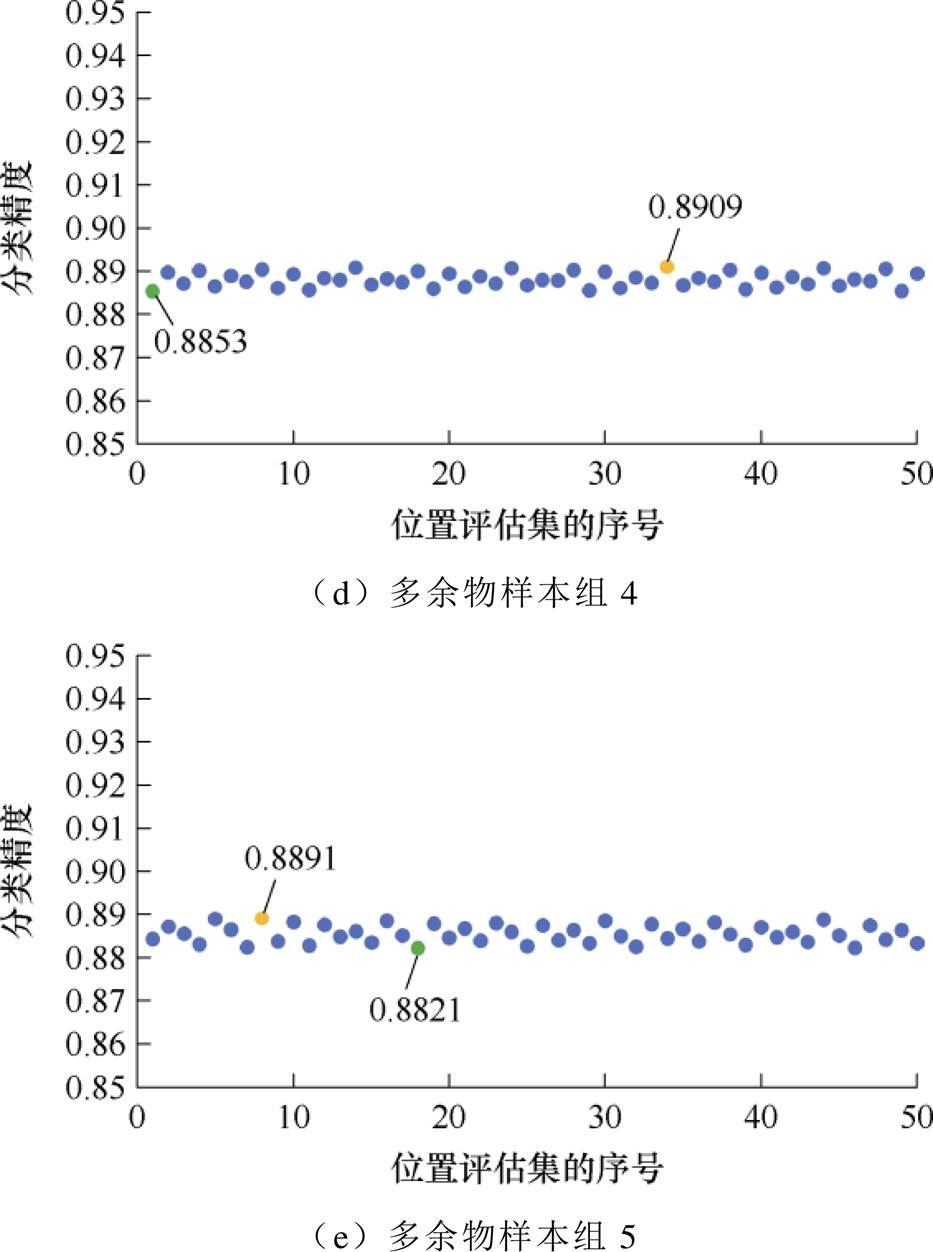
图9 位置识别模型全局分类性能散点图Ⅱ
Fig.9 Scatter plot of global classification performance of location recognition model Ⅱ
由图9可知,位置识别模型在五组多余物样本的评估集上取得的最高分类精度分别为0.891 9、0.888 9、0.889 2、0.890 9与0.889 1,取得的最低分类精度分别为0.886 2、0.881 4、0.884 1、0.885 3与0.882 1。经过计算,位置识别模型在五组多余物样本的评估集上取得的平均分类精度分别为0.889 2、0.885 5、0.886 7、0.888 1与0.885 5。较3.3.1节中取得的0.910 8的最高分类精度、0.902 5的最低分类精度与0.907 0的平均分类精度,位置识别模型的全局分类性能均有明显幅度退化。较3.2节中取得的0.929 6的分类精度,全局分类性能退化幅度进一步凸显。这说明,即使在同工况条件下,由于被测设备与多余物样本的非一致性,位置识别模型的全局分类性能会有较大幅度的退化。

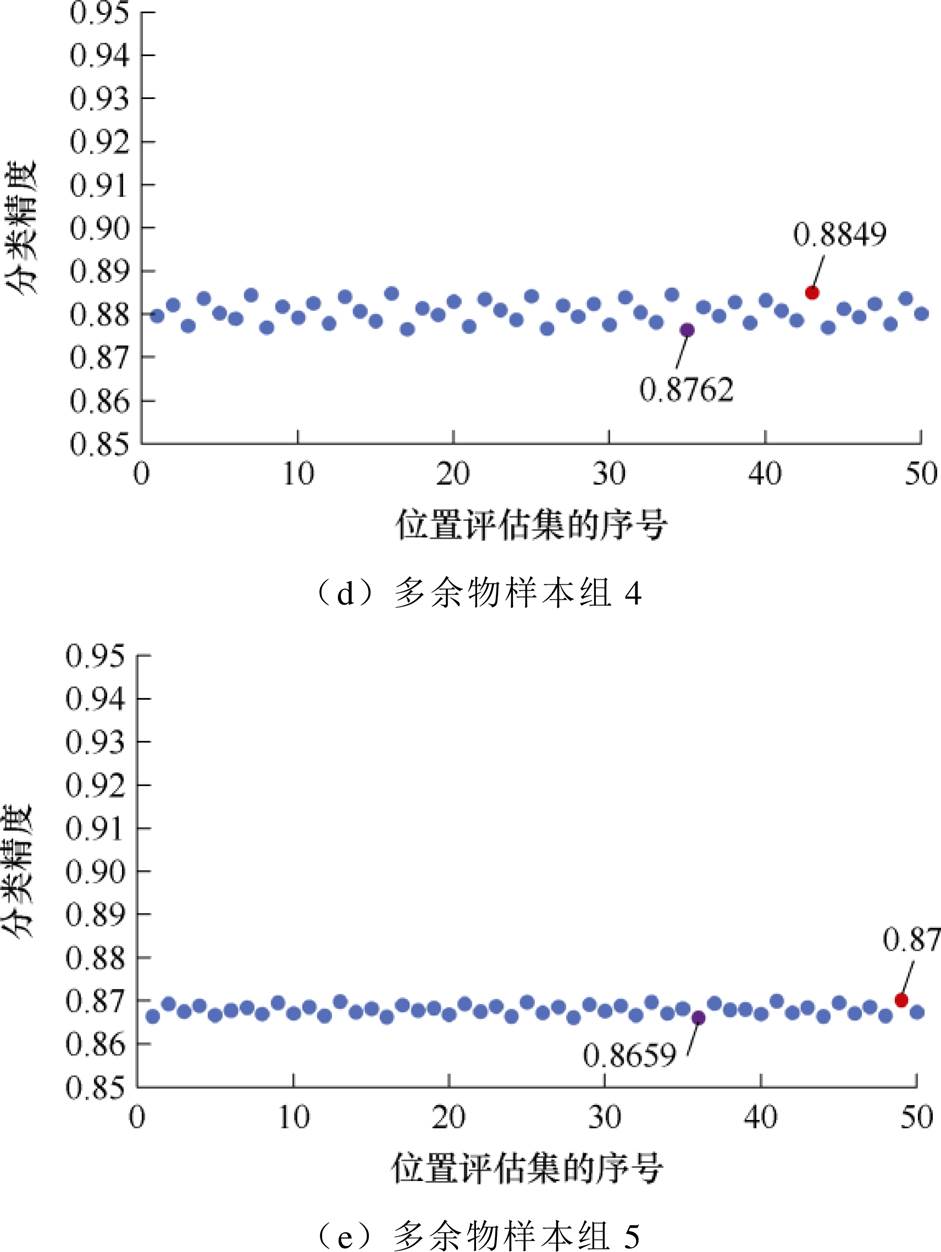
图10 材质识别模型全局分类性能散点图Ⅱ
Fig.10 Scatter plot of global classification performance of material recognition model Ⅱ
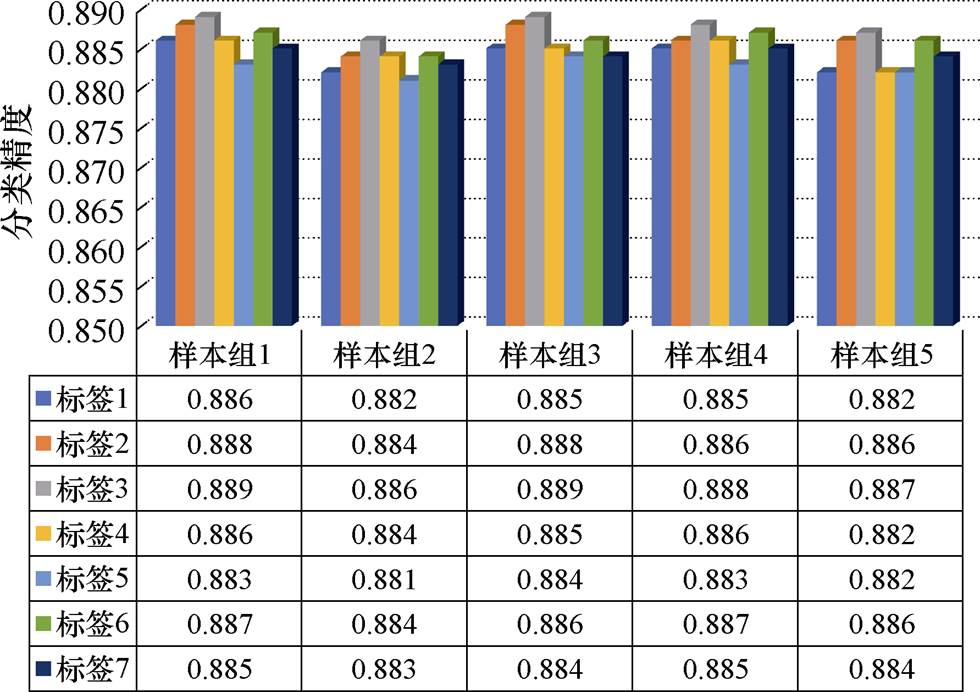
图11 位置识别模型局部分类性能比较结果Ⅱ
Fig.11 Comparison results of local classification performance of location recognition model Ⅱ
由图10可知,无论同比最高分类精度、最低分类精度,还是同比平均分类精度(0.889 2、0.870 0、0.882 4、0.880 5与0.867 9),材质识别模型的全局分类性能均有较大幅度的退化。这再次验证了上述分析。不同的是,位置识别模型在五组多余物样本的评估集上取得的分类精度分布较为均衡,均位于0.88~0.89的区间内。而材质识别模型在多余物样本组1、3与4的评估集上取得的分类精度与在多余物样本组2与5的评估集上取得的分类精度的分布差异较为明显。前者明显位于0.88~0.89的区间内,后者明显位于0.86~0.87的区间内。由表7可知,多余物样本组2与5中硅胶的质量相较更大,在施加力学激励的同一时间区间内,更重的硅胶不仅碰撞或滑动的频率更低,且每次碰撞或滑动的持续时间更长,导致多余物信号中脉冲数量更少,材质评估集中标签为“5”的数据量更少。再次验证了3.3.1节中的分析。而位置评估集是以位置标签为分类标准,尽管由硅胶产生的数据量相对较少,但被较为均衡地分到七类位置标签中。综合图9与图10可以看出,在同工况条件下,对于新的被测设备与新的多余物样本,位置识别模型与材质识别模型的全局分类性能均远高于0.5。
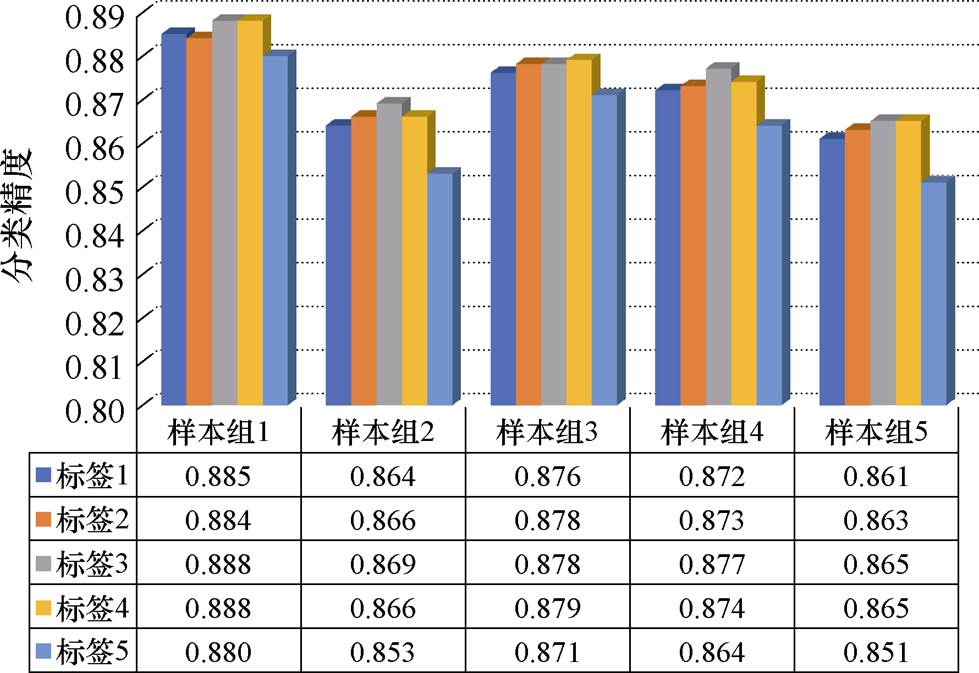
图12 材质识别模型局部分类性能比较结果Ⅱ
Fig.12 Comparison results of local classification performance of material recognition model Ⅱ
由图11与图12可知,位置识别模型在五组多余物样本的评估集内每类标签数据上取得的最低分类精度均位于0.88~0.89的区间内(远高于0.5),彼此之间差异较小,再次显示其稳定的局部分类性能。结合图9所示位置识别模型均衡取得的位于0.88~0.89的分类精度,说明其同时具有显著的全局与局部分类性能。在五组多余物样本的评估集内,材质识别模型每类标签数据上取得的最低分类精度均位于0.85~0.89的区间内(远高于0.5),局部差异性与图10所示一致,对该现象的分析不再赘述。
综上所述,在同工况条件下,面对新设备与新样本,多余物位置与材质识别模型的全局与局部分类性能均显著高于0.5,验证了模型的可靠性。
3.3.3 同工况-应用测试
同样以3.1节中某型电子单机模块与五种材质多余物样本为参考,重新选择相同型号的电子单机模块为待测密封电子设备,随机选择相同形状但不同质量的五种材质多余物样本,共20个多余物样本,视为20个检测任务,20个检测任务的识别过程与结果见表8。采用与3.3.1节中建立评估集相同的处理过程,由新的待测密封电子设备与20个多余物样本分别建立20个位置待测集与20个材质待测集。需指出的是,此次不再先验地将每种材质的多余物样本放置在每个密闭空间中,而是轮流从20个多余物样本中选择一个,随机放置到某个密闭空间中,得到一个检测任务。
表8 20个检测任务的识别过程与结果
Tab.8 Recognition processes and results of twenty detection tasks
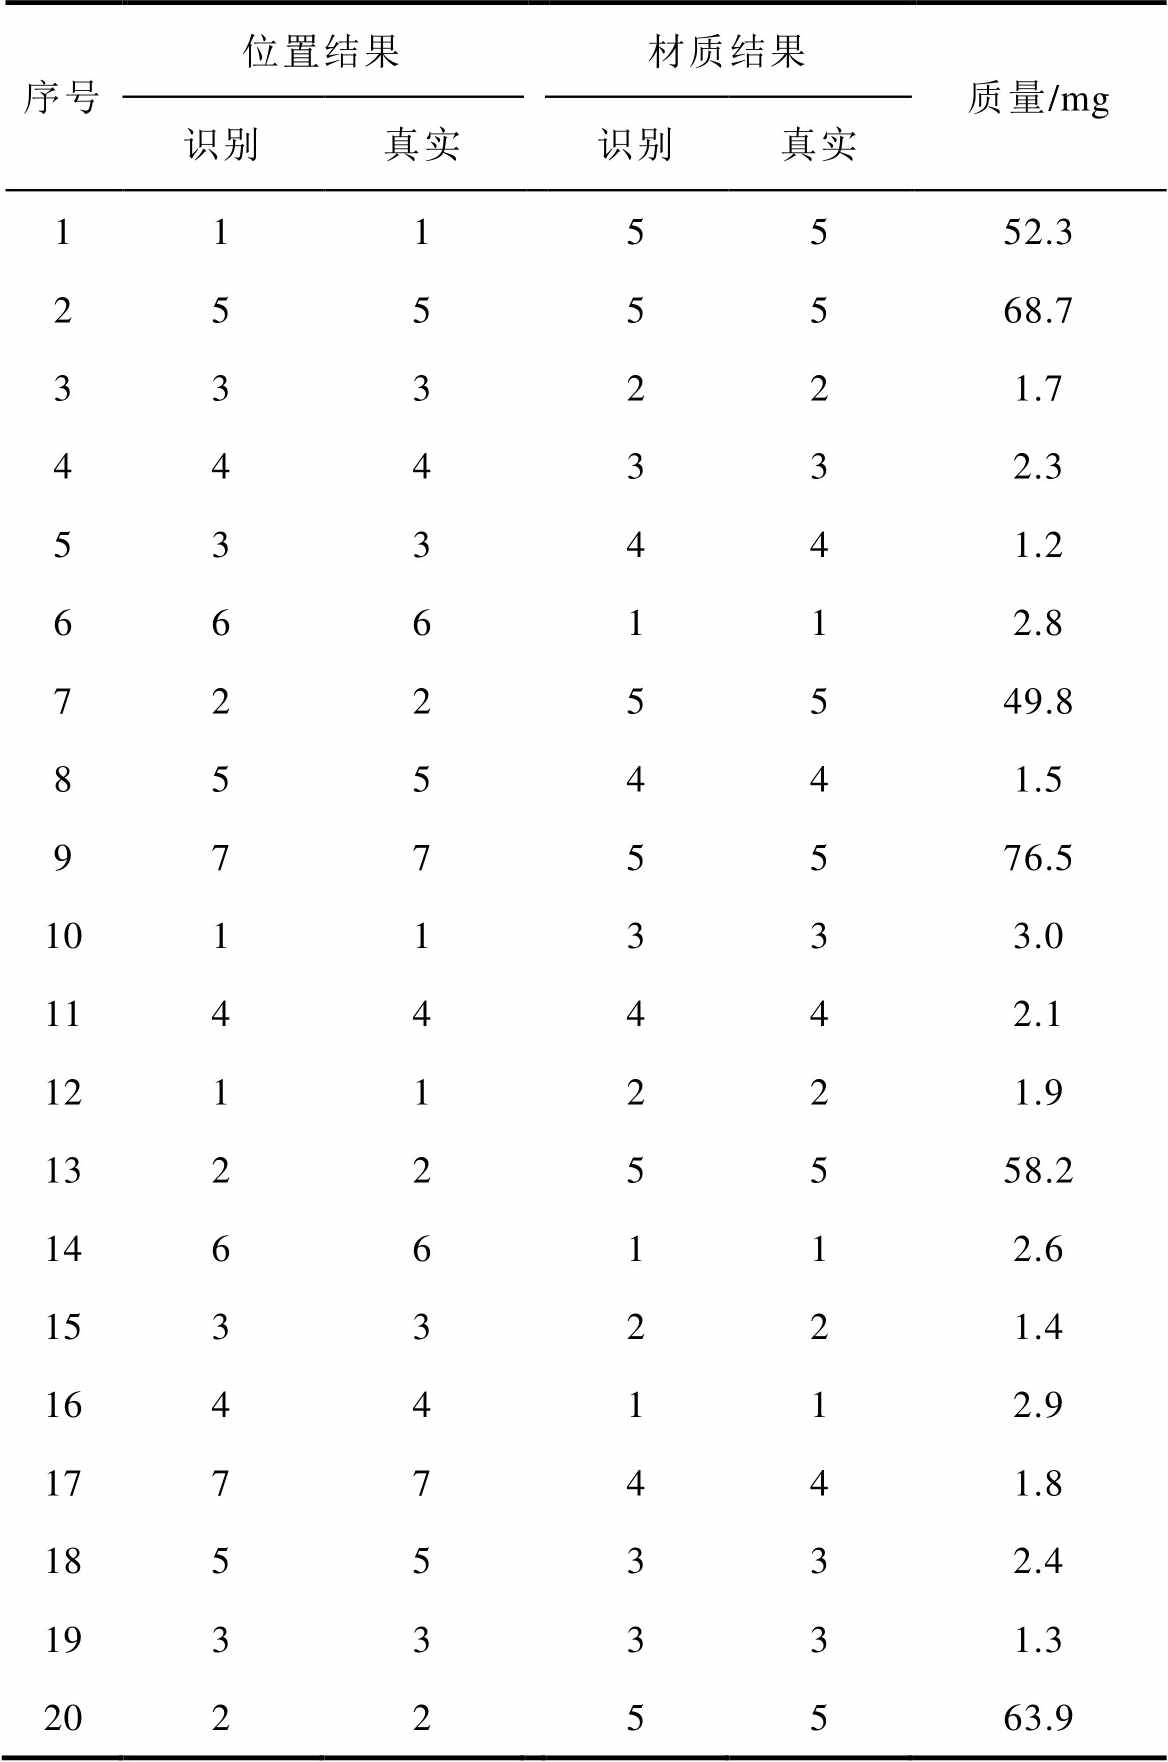
序号位置结果材质结果质量/mg 识别真实识别真实 1115552.3 2555568.7 333221.7 444332.3 533441.2 666112.8 7225549.8 855441.5 9775576.5 1011333.0 1144442.1 1211221.9 13225558.2 1466112.6 1533221.4 1644112.9 1777441.8 1855332.4 1933331.3 20225563.9
基于此,同样应用3.2节的位置识别模型和材质识别模型在待测集上进行预测。对于每个待测集得到的多个预测标签,添加多数表决过程进行处理,得到一个识别结果。最终,20个检测任务分别得到20个位置识别结果与20个材质识别结果。表8给出了上述识别过程与结果,其中,标签对应的位置与材质信息可以参考表4。
由表4可知,20个检测任务的位置与材质识别结果均正确,说明均顺利完成。20个检测任务均对应新设备与新样本,因此位置与材质识别模型的全局与局部分类性能应与3.3.2节中表现一致。即,位置识别模型的全局分类性能均衡位于0.88~0.89的区间、局部分类性能稳定高于0.88,材质识别模型的全局分类性能分层位于0.86~0.89的区间、局部分类性能稳定高于0.85,两者的全局与局部分类性能均远高于0.5。根据2.1节的推论,在添加多数表决过程后,由多余物属性识别模型可以得到稳定可靠的位置与材质识别结果。本节的应用测试结果充分证明了这一推论。需指出的是,20个检测任务中,硅胶(标签“5”)的材质识别结果全部正确,说明不同质量的硅胶对材质识别模型的全局与局部分类性能产生的影响有限,不会令其欠拟合。
需要注意的是,尽管20个检测任务的属性识别结果均正确,但仍需注意误差分析。在多数表决过程中,当正确预测的数据比例接近0.5时,可能存在识别错误的风险。此外,在一些极端工况下,如信噪比极低或多余物信号被完全淹没,尽管退化后的分类性能仍大于0.5,模型依然可能无法提供准确
的识别结果。因此,未来研究应关注这些特殊情况下的性能评估与优化,进一步提升模型的鲁棒性,确保在各种工况下依然能够提供可靠的识别结果。
至此,多余物属性识别模型的可靠性评估实验验证结束,有效证明了2.1节中的推论成立。
3.2节中,经过五个功能模块的顺序处理,构建了多余物属性识别模型,包括一个位置识别模型与一个材质识别模型,3.3节进行了可靠性评估,本节则继续进行可解释性分析。参考2.2节,可解释性分析方式包括顺序失效式、累加递进式和单独递进式三种,本节先依次使用三种分析方式进行分析,在对三种分析方式得到的结果进行综合分析。
3.4.1 顺序失效式分析
在3.2节中多余物属性识别模型的基础上,参考2.2节中顺序失效式的分析过程,每次顺序失效一个功能模块,并统计多余物属性识别模型的分类性能,见表9。需补充的是,当“分类算法”失效时,在其他四个功能模块重新作用的基础上,分别训练不同类别的具有代表性的多个分类器,并计算它们的平均分类性能,进而由式(2)得到“分类算法”失效时的分类性能。其中,具有代表性的多个分类器包括XGBoost、KNN、RBF-SVM、随机森林、BPNN与1D-CNN,它们在顺序失效式场景下分类性能见表10。
表9 顺序失效式分析结果
Tab.9 Sequential failure analysis results
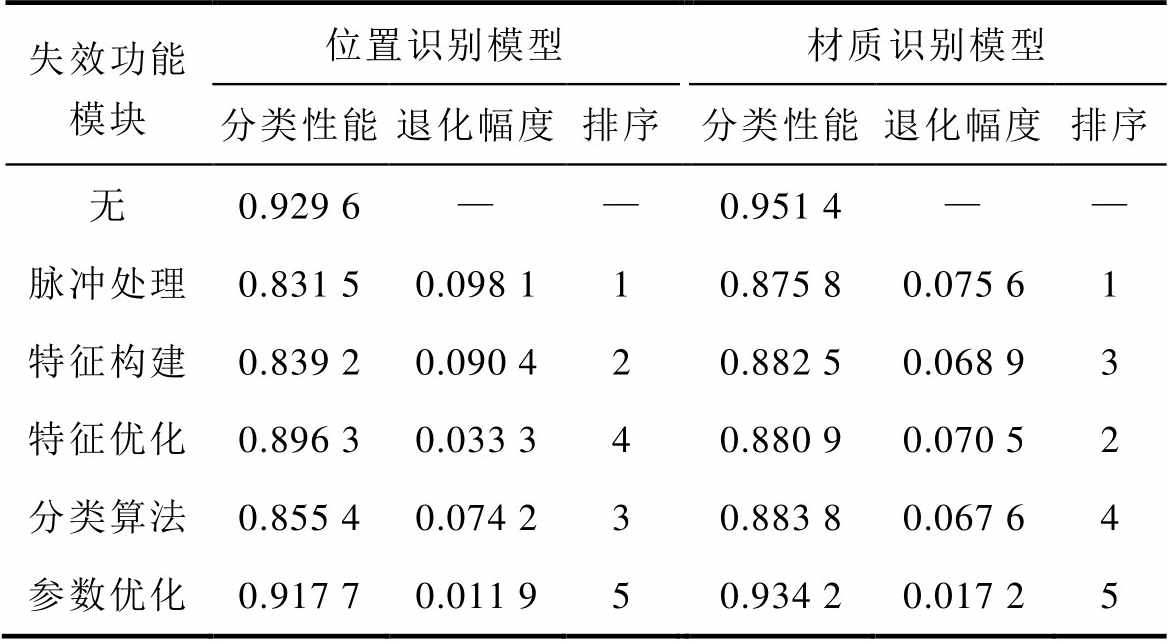
失效功能模块位置识别模型材质识别模型 分类性能退化幅度排序分类性能退化幅度排序 无0.929 6——0.951 4—— 脉冲处理0.831 50.098 110.875 80.075 61 特征构建0.839 20.090 420.882 50.068 93 特征优化0.896 30.033 340.880 90.070 52 分类算法0.855 40.074 230.883 80.067 64 参数优化0.917 70.011 950.934 20.017 25
表10 多个分类器在顺序失效式场景下分类性能
Tab.10 Classification performance of multiple classifiers in sequential failure scenarios
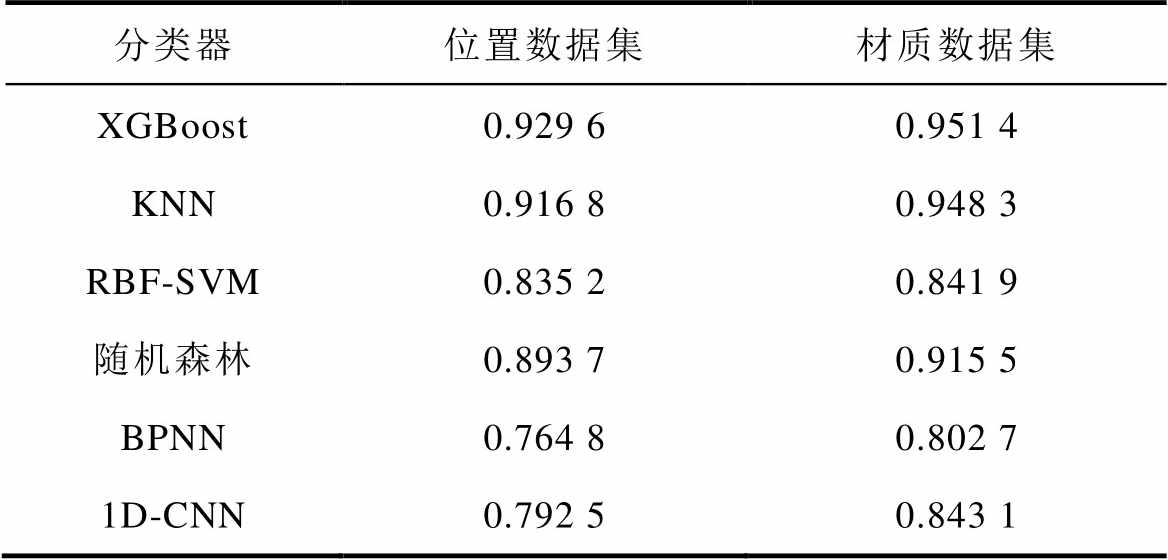
分类器位置数据集材质数据集 XGBoost0.929 60.951 4 KNN0.916 80.948 3 RBF-SVM0.835 20.841 9 随机森林0.893 70.915 5 BPNN0.764 80.802 7 1D-CNN0.792 50.843 1
如表9所示,在顺序失效式分析中,“脉冲处理”“特征构建”与“分类算法”是对位置识别模型分类性能作用最显著的三个功能模块,“脉冲处理” “特征优化”与“特征构建”是对材质识别模型分类性能作用最显著的三个功能模块。显然,前期研究中被视为多余物属性识别模型构建流程中的两个基础环节“脉冲处理”与“特征构建”均表现突出,且在材质识别模型中,“特征构建”与“特征优化”产生的退化幅度差距较小,更加突出了“特征构建”对分类性能的显著作用。这有效证明了开展本研究的必要性与正确性,有效说明“脉冲处理”与“特征构建”不仅是多余物属性识别模型构建流程中的两个基础环节,更是对模型分类性能产生重要作用的两个功能模块。相比之下,前期研究中重点关注的“参数优化”表现一般,与其他四个功能模块差距明显,其产生的退化幅度较小,说明其对模型分类性能的作用有限。
综上所述,在顺序失效式分析中,“脉冲处理”“特征构建”“特征优化”与“分类算法”是对多余物属性识别模型分类性能作用显著的四个功能模块。从频次来说,前期研究中忽视的“脉冲处理”与“特征构建”是作用最显著的两个关键功能模块。
3.4.2 累加递进式分析
在3.2节中3 500个标注信号组的基础上,训练了功能模块失效模式下的多余物属性识别模型,包括一个位置识别模型与一个材质识别模型,分类性能分别为0.662 6与0.741 9。参考2.2节中累加递进式的分析过程,每次顺序作用一个功能模块,并统计多余物属性识别模型的分类性能,见表11。需补充的是,当“分类算法”作用时,在此前三个功能模块继续作用的基础上,分别训练不同类别的具有代表性的多个分类器,并计算它们的平均分类性能,进而计算多余物属性识别模型的分类性能与平均分类性能的差值绝对值,作为“分类算法”作用时的性能提升率。其中,具有代表性的多个分类器在累加递进式场景下分类性能见表12。
表11 累加递进式分析结果
Tab.11 Cumulative progressive analysis results
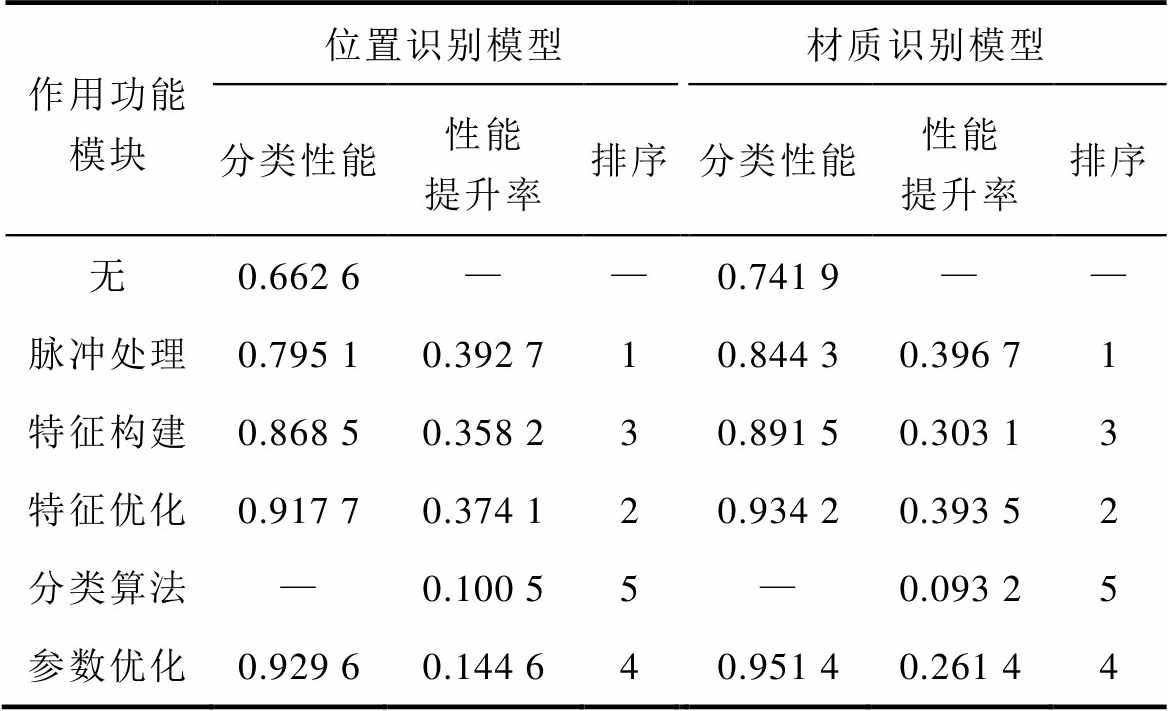
作用功能模块位置识别模型材质识别模型 分类性能性能提升率排序分类性能性能提升率排序 无0.662 6——0.741 9—— 脉冲处理0.795 10.392 710.844 30.396 71 特征构建0.868 50.358 230.891 50.303 13 特征优化0.917 70.374 120.934 20.393 52 分类算法—0.100 55—0.093 25 参数优化0.929 60.144 640.951 40.261 44
表12 多个分类器在累加递进式场景下分类性能
Tab.12 Classification performance of multiple classifiers in cumulative progressive scenarios
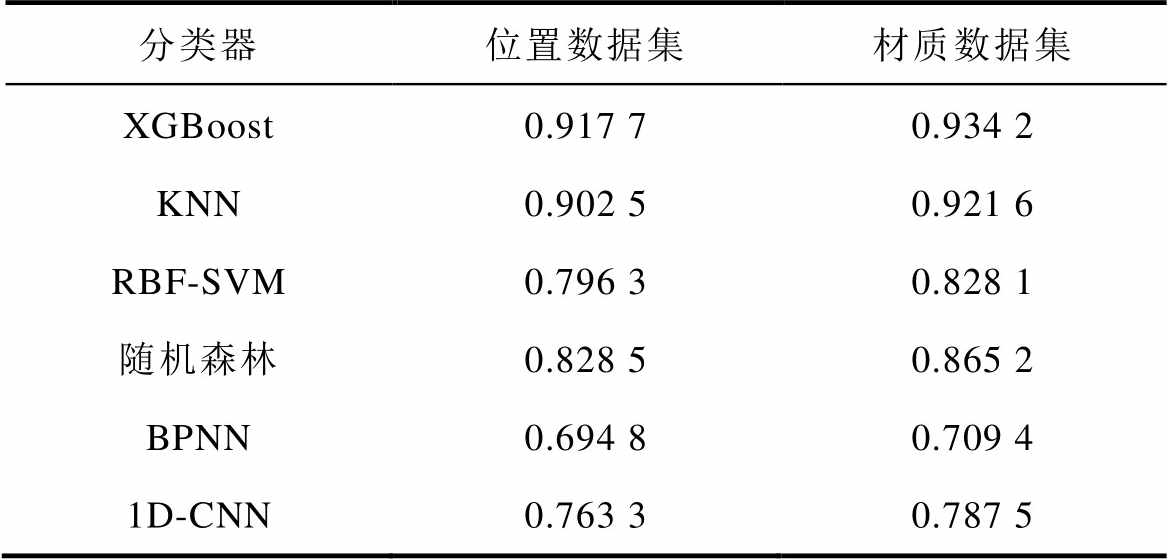
分类器位置数据集材质数据集 XGBoost0.917 70.934 2 KNN0.902 50.921 6 RBF-SVM0.796 30.828 1 随机森林0.828 50.865 2 BPNN0.694 80.709 4 1D-CNN0.763 30.787 5
如表11所示,在累加递进式分析中,“脉冲处理”“特征优化”与“特征构建”是同时对位置与材质识别模型分类性能作用最显著的三个功能模块。显然,“脉冲处理”与“特征构建”同样均表现突出,显示它们对模型分类性能的显著作用。这再次有效证明了开展本研究的必要性与正确性,以及重视“脉冲处理”与“特征构建”这两个功能模块的必要性。相比之下,前期研究中重点关注的“分类算法”与“参数优化”表现均一般,它们导致的性能提升率均较小,与其他三个功能模块差距明显,说明它们对模型分类性能的作用有限。
综上所述,在累加递进式分析中,“脉冲处理”“特征优化”与“特征构建”是对多余物属性识别模型分类性能作用显著的三个功能模块。从频次与排序综合来说,前期研究中忽视的“脉冲处理”,以及前期研究重视的“特征优化”,是对分类性能作用最显著的两个关键功能模块。此外,前期研究中忽视的“脉冲构建”对分类性能的显著作用不容忽视。
3.4.3 单独递进式分析
同样基于功能模块失效模式下的多余物属性识别模型,参考2.2节中单独递进式的分析过程,每次顺序作用一个功能模块,并统计模型的分类性能,见表13。需要补充的是,当“分类算法”作用时,在此前三个功能模块不再作用的基础上,分别训练不同类别的具有代表性的多个分类器(同样是功能模块失效模式下的多余物属性识别模型),并计算它们的平均分类性能,进而计算多余物属性识别模型的分类性能与平均分类性能的比值,作为“分类算法”作用时的分类性能。其中,具有代表性的多个分类器在单独递进式场景下分类性能见表14。
表13 单独递进式分析结果
Tab.13 Individual progressive analysis results
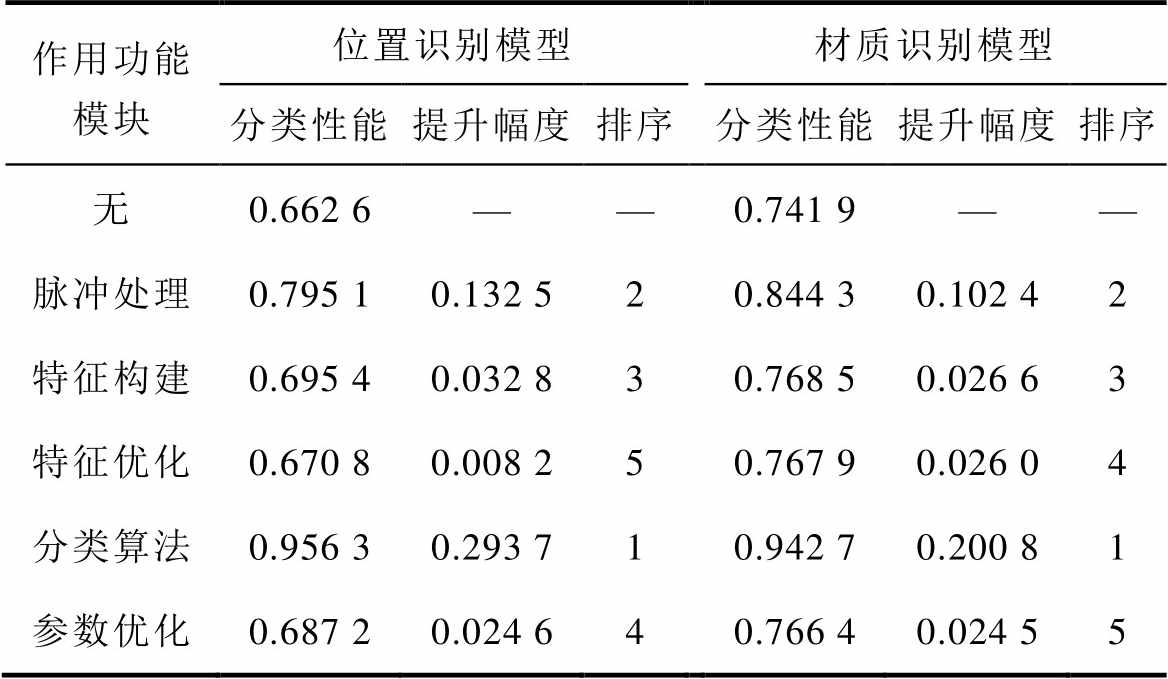
作用功能模块位置识别模型材质识别模型 分类性能提升幅度排序分类性能提升幅度排序 无0.662 6——0.741 9—— 脉冲处理0.795 10.132 520.844 30.102 42 特征构建0.695 40.032 830.768 50.026 63 特征优化0.670 80.008 250.767 90.026 04 分类算法0.956 30.293 710.942 70.200 81 参数优化0.687 20.024 640.766 40.024 55
如表13所示,在单独递进式分析中,“分类算法”“脉冲处理”与“特征构建”是同时对位置与材质识别模型分类性能作用最显著的三个功能模块。显然,“脉冲处理”与“特征构建”依然均表现突出,充分显示它们对模型分类性能的显著作用,证明了开展本研究的必要性与正确性,以及重视“脉冲处理”与“特征构建”这两个功能模块的必要性。值得关注的是,“参数优化”对位置识别模型分类性能的提升幅度与“特征构建”相近,“特征优化”和“参数优化”对材质识别模型分类性能的提升幅度与“特征构建”相近。这在一定程度上说明前期研究关注它们的合理性。
表14 多个分类器在单独递进式场景下分类性能
Tab.14 Classification performance of multiple classifiers in individual progressive scenarios
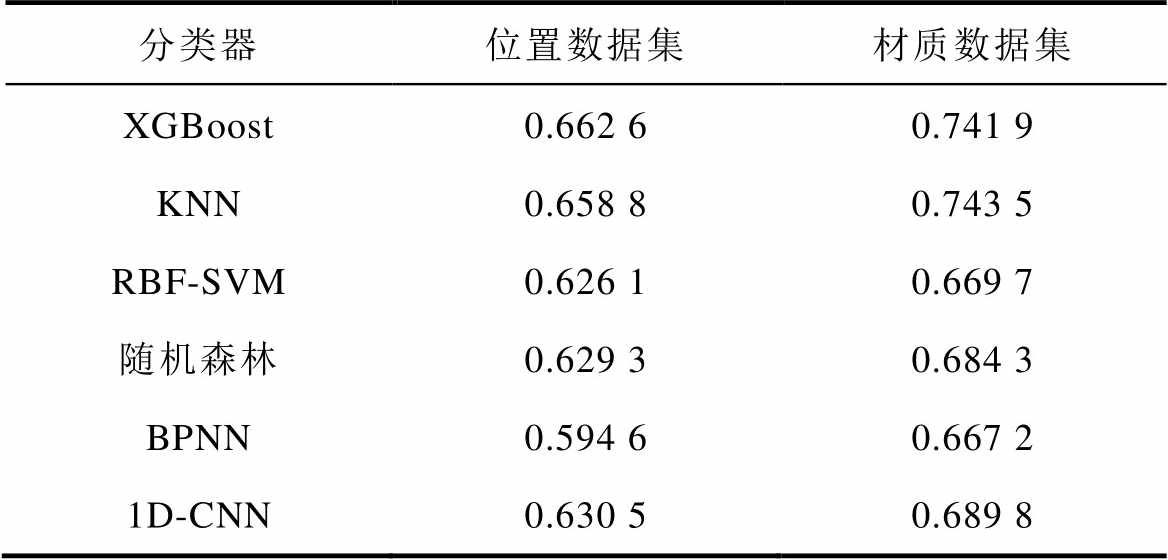
分类器位置数据集材质数据集 XGBoost0.662 60.741 9 KNN0.658 80.743 5 RBF-SVM0.626 10.669 7 随机森林0.629 30.684 3 BPNN0.594 60.667 2 1D-CNN0.630 50.689 8
综上所述,单独递进式分析中,“分类算法”“脉冲处理”与“特征构建”是对多余物属性识别模型分类性能作用显著的三个功能模块。从频次与排序综合来说,前期研究重视的“分类算法”,以及前期研究中忽视的“脉冲处理”,是对分类性能作用最显著的两个关键功能模块。此外,前期研究中忽视的“脉冲构建”对分类性能的显著作用同样不容忽视。
3.4.4 综合分析
表15汇总了三种分析方式得到的对多余物属性识别模型分类性能作用显著的三个功能模块。如表中所示,无论采用哪种分析方式,无论是位置还是材质识别模型,“脉冲处理”与“特征构建”均是对分类性能作用显著的三个功能模块之一。此外,对于位置识别模型,在单独递进式与顺序失效式分析中,“分类算法”均是对分类性能作用显著的三个功能模块之一,在累加递进式分析中,“特征优化”是对分类性能作用显著的三个功能模块之一。对于材质识别模型,在累加递进式与顺序失效式分析中,“特征优化”均是对分类性能作用显著的三个功能模块之一,在单独递进式分析中,“分类算法”是对分类性能作用显著的三个功能模块之一。
表15 三种分析方式得到的汇总结果
Tab.15 Summary results obtained from three analysis methods
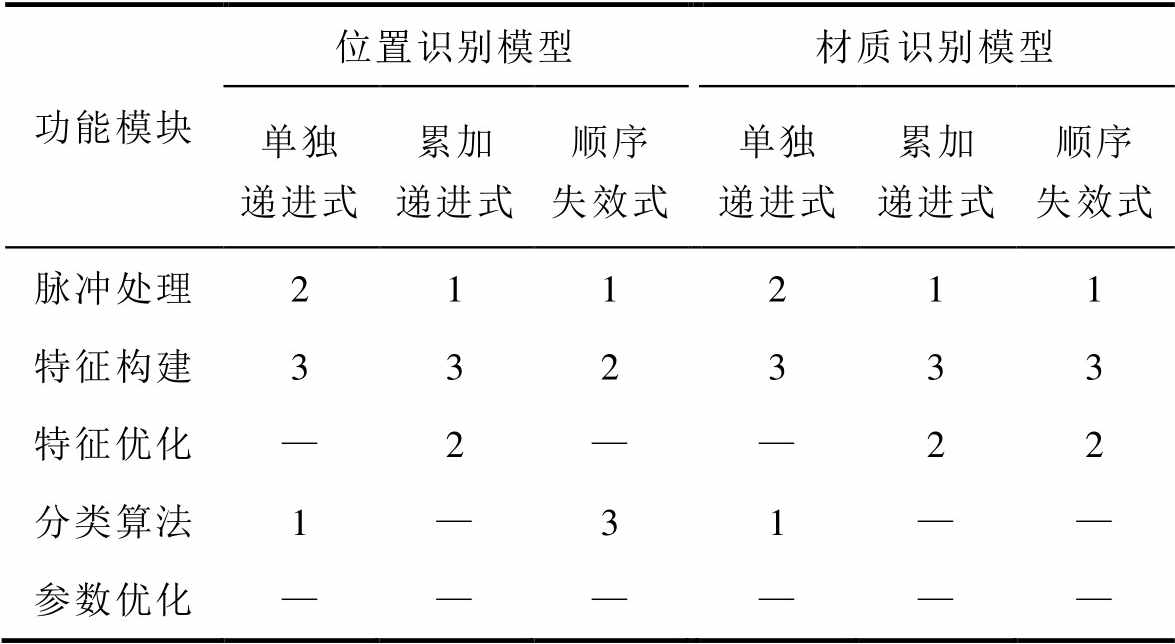
功能模块位置识别模型材质识别模型 单独递进式累加递进式顺序失效式单独递进式累加递进式顺序失效式 脉冲处理211211 特征构建332333 特征优化—2——22 分类算法1—31—— 参数优化——————
从频次与排序综合来说,前期研究中忽视的“脉冲处理”与“特征构建”,是对模型分类性能作用最显著的两个关键功能模块,其作用显著高于其他三个功能模块。开展本研究的必要性与正确性最终被充分展示。这表明,作为模型构建流程的源头环节,这两个关键功能模块发挥决定性作用,奠定了良好分类性能的基础。前期研究关注的“特征优化”与“分类算法”同样对模型分类性能发挥重要作用,一定程度上说明开展前期研究的合理性。值得关注的是,前期研究关注的“参数优化”仅对模型分类性能发挥有限作用,未能成为作用显著的三个功能模块之一。这表明,作为模型构建流程的末端环节,其仅能在有限提升空间内发挥有限作用。
机器学习中,基于基础分类器开展的参数优化研究对分类性能的提升总是有限制、有条件与不稳定的,其发挥的作用在同工况场景下的退化也是显著的[25]。相比之下,大量研究表明,对分类性能提升的核心在于其构建流程的上游环节,越是构建流程中靠前的功能模块,其基础性与决定性作用越显著。3.4节中的可解释性分析过程也充分证明了这一点。
需指出的是,在3.4.1~3.4.3节中,三种分析方法虽然从不同角度量化评估了各功能模块的贡献度,但它们得出的结论存在一定的差异。这些差异的原因在于,三种分析方法分别侧重于不同的评估方式。例如,顺序失效式分析强调了每个功能模块失效时对分类性能的影响,而累加递进式分析则关注功能模块依次加入时对分类性能的提升。这些不同的分析视角能够有效互补,相互印证,从而更加清晰地定位“脉冲处理”与“特征构建”为多余物属性识别模型的两个关键功能模块。这种多维度的分析方法增强了结论的可靠性与说服力,且提供了模型优化的重要启示。
综上所述,“脉冲处理”与“特征构建”是对多余物属性识别模型分类性能作用最显著的两个关键功能模块,应在后续模型部署与优化中得到重视。
本文提出的“识别可靠性”定义,虽然在多余物属性识别模型的背景下具有重要意义,但其理论价值和普适性值得进一步探讨。该定义中,退化后全局与局部分类性能同时稳定大于0.5的标准,是否可以推广到其他类型的机器学习模型,如回归模型、目标检测模型等,仍需在不同应用场景中验证。特别是在故障诊断、声发射检测等领域,该定义是否能够有效地衡量模型在这些复杂应用中的可靠性与稳定性,仍然是一个值得深入研究的方向。作者将在后续的工作中,探索该定义在其他任务中的应用和扩展,以期为更多的工业领域提供理论指导。
此外,需说明的是,本文中的多余物属性识别方法主要适用于离线多余物测试识别[26]。在这种测试中,通过对设备的各个密封空间进行离线激励,采集由多余物引起的信号,并使用本文提出的模型对信号进行处理,最终实现位置与材质的识别。该方法能够有效地解决现有在线检测方法无法实时处理多余物属性的挑战,特别适用于需要高精度识别和复杂环境下的离线测试场景。与传统方法不同,本方法可以高效地识别多余物的具体位置和材质,为设备的维修和优化提供更为可靠的数据支持。
本文提出了一种多余物属性识别模型的可靠性评估与可解释性分析方法,得出以下研究结论:
1)多余物属性识别模型的分类性能对准确可靠的属性识别结果产生重要影响,添加多数表决过程可以将数据分类结果转化为位置与材质识别结果,实现多个“检测事件”与单个“检测任务”的统一。
2)模型识别可靠性的定义为:同工况条件下多余物属性识别模型的性能发生退化,若其全局分类性能与局部分类性能均稳定大于0.5,就能够通过多数表决过程实现准确的属性识别。
3)累加递进式、单独递进式与顺序失效式三种分析方法得到的结果表明,“脉冲处理”与“特征构建”是对模型分类性能作用最显著的两个关键功能模块,显示上游环节的功能模块的潜力。
4)真实应用场景下大量实验证明:同工况条件下,多余物属性识别模型的全局与局部分类性能显著且稳定高于0.5,位置与材质识别结果准确可靠,模型鲁棒性及本研究的必要性与实用性被验证。
机器学习中,选择合适的分类器至关重要。本文中,作为多余物属性识别模型构建流程中的一个功能模块,“分类算法”最终输出一个明确的优异分类器,且其所属类型是固定的。因此,无论是位置
还是材质识别模型,其基础分类器的类型均保持一致。在3.4节对多余物属性识别模型的可解释分析过程中,三种分析方式对“分类算法”的量化评估公式与对其他四个功能模块存在差异,因此可以视为一种临时性或相对性的方式。本质上,3.4节中位置与材质识别模型的基础分类器均为XGBoost,其他五个分类器仅用于对比,填补该功能模块缺失作用时的空白。需注意的是,若不考虑“分类算法”,参考表15可知,“脉冲处理”与“特征构建”对模型分类性能的显著作用程度被进一步凸显,再次证明本文将其作为关键功能模块的正确性。
根据2.1节的推论,对于待测的密封电子设备,在同工况条件下,无论多余物属性识别模型的基础分类器是何种类型,只要其退化后全局与局部分类性能同时稳定大于0.5,在添加多数表决过程后,就可以得到稳定可靠的位置与材质识别结果。实际上,在前期研究中,当将“脉冲处理”与“特征构建”作为模型构建流程中的基础环节时,训练的多数类型的分类器的全局与局部分类性能均同时稳定大于0.5。这表明,在真实应用场景下,如果最终目的是得到针对“检测任务”的属性识别结果,则无需过度关注多余物属性识别模型(即基础分类器)的全局与局部分类性能,应将重心放在性能提升上。相比之下,使用有限的计算资源训练一个分类性能良好且稳定的多余物属性识别模型,就能满足降本增效的检测需求。
此外,开展本研究的意义在于,面对真实应用场景下的多余物检测(属性识别)需求,以低成本、高效率为导向,分析构建一个分类性能良好且稳定的多余物属性识别模型来给出准确可靠属性识别结果的可行性。基于此,分析并确定“脉冲提取”与“特征构建”的关键功能模块地位。在后续工业化部署中,对于具有有限计算资源的硬件设备,可以分配固定比例的计算资源用于运行固定的“脉冲处理”与“特征构建”程序,将剩余资源自适应地分配给可变的其他功能模块程序,如“参数优化”。核心在于固定的“脉冲处理”与“特征构建”,即基本保证了多余物属性识别模型的全局与局部分类性能。进一步地,当需要提升多余物属性识别模型的可靠性时,应将研究重心放在“脉冲处理”与“特征构建”,然后再考虑其他功能模块。核心在于处于构建流程上游环节的“脉冲处理”与“特征构建”对模型分类性能发挥的决定性作用。
参考文献
[1] 陈必玉, 卢静, 余协正, 等. 航空航天产品多余物预防与控制研究[J]. 航空标准化与质量, 2024(6): 47-50.
Chen Biyu, Lu Jing, Yu Xiezheng, et al. Research on prevention and control of redundant materials in aerospace products[J]. Aeronautic Standardization & Quality, 2024(6): 47-50.
[2] 王衎, 耿海, 陆帆, 等. 宇航电推进产品多余物防控的认识与实践[J]. 质量与可靠性, 2024(1): 9-12, 20.
Wang Kan, Geng Hai, Lu Fan, et al. Cognition and practice of the redundancy prevention and control in the aerospace electric propulsion products[J]. Quality and Reliability, 2024(1): 9-12, 20.
[3] 任建文, 成钢, 李永春, 等. 航天电子产品多余物预防与控制方法探析[J]. 航天工业管理, 2023(12): 20-24.
Ren Jianwen, Cheng Gang, Li Yongchun, et al. Analysis on remainder prevention and control methods for aerospace electronic products[J]. Aerospace Industry Management, 2023(12): 20-24.
[4] 王淑娟, 王国涛, 翟国富, 等. 航天继电器多余物微粒碰撞噪声检测的冲击试验条件[J]. 电工技术学报, 2011, 26(1): 75-80, 85.
Wang Shujuan, Wang Guotao, Zhai Guofu, et al. Impact test condition of particle impact noise detection for space relay remainders[J]. Transactions of China Electrotechnical Society, 2011, 26(1): 75- 80, 85.
[5] 李鹏飞, 翟国富, 孙志刚, 等. 密封电子元器件与装置多余物检测发展综述[J]. 电工技术学报, 2024, 39(10): 3152-3179, 3217.
Li Pengfei, Zhai Guofu, Sun Zhigang, et al. A review of the loose remainders detection for sealed electronic components and devices[J]. Transactions of China Electrotechnical Society, 2024, 39(10): 3152-3179, 3217.
[6] Zhang Guozheng, Li Menghui, Gu Xin, et al. Fault diagnosis method for open-circuit faults in NPC three-level inverter based on WKCNN[J]. CES Transactions on Electrical Machines and Systems, 2025, 9(2): 234-245.
[7] 丁志千, 翁凯迪, 杨福, 等. 基于泄漏信号特征参数分析法的储罐底板声发射检测[J]. 中国特种设备安全, 2025, 41(6): 13-19.
Ding Zhiqian, Weng Kaidi, Yang Fu, et al. Acoustic emission detection of tank bottom plate based on leakage signal characteristic parameter analysis method[J]. China Special Equipment Safety, 2025, 41(6): 13-19.
[8] Lei Yaguo, Yang Bin, Jiang Xinwei, et al. Appli- cations of machine learning to machine fault diagnosis: a review and roadmap[J]. Mechanical Systems and Signal Processing, 2020, 138: 106587.
[9] Feng Ke, Ji J C, Ni Qing, et al. A review of vibration-based gear wear monitoring and prediction techniques[J]. Mechanical Systems and Signal Processing, 2023, 182: 109605.
[10] Sun Zhigang, Liang Qi, Zhai Guofu, et al. Multi- source information fused loose particle localization and material identification method for sealed electronic equipment[J]. Engineering Applications of Artificial Intelligence, 2025, 139: 109529.
[11] Sun Zhigang, Wang Guotao, Zhai Guofu, et al. Method of locating loose particles inside aerospace equipment based on parameter-optimized XGBoost[J]. Engineering Applications of Artificial Intelligence, 2023, 126: 106796.
[12] 孙志刚, 王国涛, 高萌萌, 等. 基于kNN优化算法的密封电子设备多余物定位技术[J]. 电子测量与仪器学报, 2021, 35(3): 94-104.
Sun Zhigang, Wang Guotao, Gao Mengmeng, et al. Sealed electronic equipment loose particle positioning technology based on kNN algorithm of parameter optimization[J]. Journal of Electronic Measurement and Instrumentation, 2021, 35(3): 94-104.
[13] 孙志刚, 王国涛, 高萌萌, 等. 参数优化支持向量机的密封电子设备多余物定位方法研究[J]. 电子测量与仪器学报, 2021, 35(8): 162-174.
Sun Zhigang, Wang Guotao, Gao Mengmeng, et al. Research on localization method of loose particles inside sealed electronic equipment based on parameter- optimized support vector machine[J]. Journal of Electronic Measurement and Instrumentation, 2021, 35(8): 162-174.
[14] Sun Zhigang, Jiang Aiping, Gao Mengmeng, et al. Feature optimization method for the localization technology on loose particles inside sealed electronic equipment[J]. Expert Systems with Applications, 2022, 204: 117569.
[15] Sun Zhigang, Gao Mengmeng, Jiang Aiping, et al. Incomplete data processing method based on the measurement of missing rate and abnormal degree: Take the loose particle localization data set as an example[J]. Expert Systems with Applications, 2023, 216: 119411.
[16] Ye Xuerong, Chen Hao, Chen Cen, et al. Life-cycle dynamic robust design optimization for batch production of permanent magnet actuator[J]. IEEE Transactions on Industrial Electronics, 2021, 68(10): 9885-9896.
[17] Huang Hongzhong, Li He, Shi Yan, et al. Theory and application of possibility and evidence in reliability analysis and design optimization[J]. Journal of Reliability Science and Engineering, 2025, 1(1): 015007.
[18] 施亦非, 黄宇峰, 王锋, 等. 基于参数优化特征模态分解的强背景噪声下滚动轴承故障诊断[J]. 振动与冲击, 2024, 43(21): 107-115.
Shi Yifei, Huang Yufeng, Wang Feng, et al. Fault diagnosis of rolling bearing under strong background noise based on POFMD[J]. Journal of Vibration and Shock, 2024, 43(21): 107-115.
[19] 王攀攀, 李兴宇, 张成, 等. 基于角域重采样和特征强化的电机滚动轴承故障迁移诊断方法[J]. 电工技术学报, 2025, 40(12): 3905-3916.
Wang Panpan, Li Xingyu, Zhang Cheng, et al. Fault transfer diagnosis method for motor rolling bearings based on angular domain resampling and feature enhancement[J]. Transactions of China Electrotech- nical Society, 2025, 40(12): 3905-3916.
[20] Zhai Guofu, Sun Zhigang, Wang Guotao, et al. Four-channel pulse extraction and matching method for loose particle localization on sealed electronic equipment[J]. IEEE Transactions on Instrumentation and Measurement, 2025, 74: 3515017.
[21] 钱鑫, 王国涛, 王淑娟. 密封电子元件及设备多余物的PIND方法研究进展[J]. 航天制造技术, 2016(6): 1-5, 16.
Qian Xin, Wang Guotao, Wang Shujuan. Development of PIND detection methods for sealed electronic components and equipments[J]. Aerospace Manufacturing Technology, 2016(6): 1-5, 16.
[22] Cao Yuan, Sun Yongkui, Xie Guo, et al. A sound- based fault diagnosis method for railway point machines based on two-stage feature selection strategy and ensemble classifier[J]. IEEE Trans- actions on Intelligent Transportation Systems, 2022, 23(8): 12074-12083.
[23] 徐玉珍, 邹中华, 刘宇龙, 等. 基于多尺度卷积神经网络和双注意力机制的V2G充电桩开关管开路故障信息融合诊断[J]. 中国电机工程学报, 2025, 45(8): 2992-3003.
Xu Yuzhen, Zou Zhonghua, Liu Yulong, et al. Information fusion diagnosis of switching tube open-circuit fault in V2G charging piles based on multi-scale convolutional neural network and dual- attention mechanism[J]. Proceedings of the CSEE, 2025, 45(8): 2992-3003.
[24] 马速良, 武建文, 袁洋, 等. 多振动信息下的高压断路器机械故障随机森林融合诊断方法[J]. 电工技术学报, 2020, 35(增刊2): 421-431.
Ma Suliang, Wu Jianwen, Yuan Yang, et al. Mechanical fault fusion diagnosis of high voltage circuit breaker using multi-vibration information based on random forest[J]. Transactions of China Electrotechnical Society, 2020, 35(S2): 421-431.
[25] 黄杰, 李建闽, 朱冰凡, 等. 基于条件网络和知识注入的多标签学习电能质量扰动识别与分类方法[J]. 电工技术学报, 2025, 40(23): 7652-7663.
Huang Jie, Li Jianmin, Zhu Bingfan, et al. A multi-label learning method based on conditional networks and knowledge injection for power quality disturbance identification and classification[J]. Transa- ctions of China Electrotechnical Society, 2025, 40(23): 7652-7663.
[26] 胡俊杰, 陈泉希, 潘羿. 面向快速响应与可调能力恢复的储能系统实时调度-再调度策略[J]. 电工技术学报, 2026, 41(9): 3022-3037.
Hu Junjie, Chen Quanxi, Pan Yi. Real-time scheduling- rescheduling strategy of energy storage system for fast response and adjustable capacity restoration[J]. Transactions of China Electrotechnical Society, 2026, 41(9): 3022-3037.
Abstract The loose particles generated during the production process of sealed electronic equipment pose a severe threat to their operational reliability. The particle impact noise detection method can detect the presence of loose particles; it cannot identify their attributes, such as location and material. Recognizing the attributes of loose particles has become a hot topic. In practical applications, a single detection task typically involves multiple detection events, and existing methods lack the mechanism to convert the classification results from these events into a single recognition result for the task. The impact of loose-particle attribute recognition models at the detection-event level on recognition accuracy at the detection-task level remains unclear. In addition, the contribution of each functional module in loose particle attribute recognition models needs to be evaluated to explain the synergistic effect between performance reliability and recognition stability.
This paper proposes a framework for reliability evaluation and interpretability analysis of loose particle attribute recognition models. Firstly, by introducing majority voting, the classification results for all detection events in a single detection task are aggregated, and the category with the highest frequency is determined as the attribute recognition result. Thus, a conversion mechanism from event classification to task recognition is established, and the issue of converting attribute recognition results in practical applications is solved. Secondly, to evaluate the robustness of the loose particle attribute recognition models, a novel definition of recognition reliability has been proposed. That is, under the same operating conditions, when the model's performance shows reasonable degradation, as long as its global classification performance and the local classification performance for each category remain above 0.5, the accuracy of attribute recognition results can still be guaranteed through majority voting. Thus, the impact of regularity on the relationship between performance reliability and recognition accuracy is clarified. Then, cumulative progressive, individual progressive, and sequential failure analysis methods are used to evaluate the five functional modules during model construction. It is shown that pulse processing and feature construction are the two key functional modules with the greatest impact on model performance.
Finally, numerous experiments in real-world sealed electronic equipment detection scenarios have shown that the loose particle attribute recognition models can consistently achieve global and local classification performance above 0.5 under varying operating conditions. Therefore, accurate and reliable location and material recognition results can be continuously produced through majority voting, demonstrating the proposed framework's practicality and robustness. This paper provides a reference for the reliability evaluation and robustness application of machine learning models.
keywords:Loose particle attribute recognition model, reliability assessment, interpretability analysis, majority voting, detection reliability, key functional modules
DOI: 10.19595/j.cnki.1000-6753.tces.251327
中图分类号:TM930
国家自然科学基金青年学生基础研究项目-博士研究生(624B2046)和中央高校基本科研业务费专项资金(HIT.DZJJ.2024008)资助。
收稿日期 2025-07-24
改稿日期 2026-03-27
孙志刚 男,1996年生,博士研究生,研究方向为航天国防高端装备多余物自动检测技术。E-mail: 22b906048@stu.hit.edu.cn
翟国富 男,1964年生,教授(二级),博士生导师,研究方向为产品质量一致性稳健设计理论与技术、电子系统及装备可靠性和可测性设计及健康管理。E-mail: gfzhai@hit.edu.cn(通信作者)
(编辑 郭丽军)