 为
摘要 随着电网数字化转型进程持续推进,电力业务系统中的数据交互呈现出跨系统、跨区域和跨主体的长链路流转特征。针对电力业务系统中敏感数据违规流转、用户越权访问和长期累计导出等非常规数据泄露行为难以准确识别的问题,提出一种内外生语义协同的电力数据非常规泄露风险识别方法。首先,将电力业务流量按时间片聚合并构成长时序窗口,生成描述访问频次、数据规模、接收方变化和累计导出量等行为特征的内生语义;其次,利用安全标识及关联日志构造包含数据分级、允许流转域、数据提供方、数据接收方和签名状态等信息的外生语义;然后,通过稀疏内外生语义融合、风险语义压缩和跨模态重构机制,建立实际流转行为与安全约束之间的细粒度关联;最后,依据重构误差和风险语义表示形成泄露风险评分。实验结果表明,所提方法在Aff-F、V-PR和V-ROC指标上分别达到92.65%、82.13%和83.70%,整体优于对比方法,能够弥补单纯流量特征缺乏安全语义的问题,为电力数据非常规泄露风险识别提供有效支撑。
关键词:电力数据安全 安全标识 数据泄露 长时序流量 稀疏注意力
电力数据是支撑电网安全稳定运行、数字化运营和新型电力系统建设的重要基础资源[1-2]。随着新型电力系统建设持续推进,源网荷储协同互动、分布式新能源接入、车网互动、能源大数据服务和智能运维等业务的快速发展,电力系统运行方式由传统单向供电逐步转向多主体参与、多环节协同和多系统联动的新型模式[3]。在这一过程中,调度运行数据、设备状态数据、用户用能数据、业务工单数据和运行维护数据等敏感信息频繁出现在接口调用、批量导出、跨区传输、第三方共享和远程运维调试等环节中[4-5],使电力数据安全风险由静态存储和单点访问场景,进一步扩展到动态流转、跨域共享和持续使用全过程。
针对电力数据全生命周期安全治理,数据分类分级规则和网络数据标签标识技术为数据对象的安全属性表达、流转边界约束和审计追踪提供了基础依据[6-7]。数据分类分级可刻画数据类型、敏感等级和安全保护要求,网络数据标签则能描述数据权属、类别、敏感度、流转范围和用途约束等信息。
然而,电力业务系统中的数据泄露行为具有较强的业务关联性、行为隐蔽性和长期累积性[8]。与传统的一次性大规模导出、非法账号直接入侵或明文外发等常规泄露行为不同,现实场景中的电力数据非常规泄露行为往往表现出表面合法、过程隐蔽和长时序累计等特征。具体而言,在行为主体上,泄露行为可能由合法账号、合法终端或具备部分权限的业务主体发起;在流转路径上,数据可能经由合法接口、正常业务链路或多跳转发路径流出,但实际接收域、接收主体或业务用途偏离安全标识约束;在泄露规模上,单次传输规模可能较小,不会形成明显流量突增;在持续时间上,泄露行为往往跨越多个时间片或多个业务周期;在实施方式上,违规主体可能通过低频访问、分批导出、接口滥用、越权查询或跨域转发等方式嵌入正常业务流程。此类行为在短时间窗口内不会造成明显突变,访问频次、通信规模、协议形态和接口调用方式也可能与正常业务较为相似,但从较长时间尺度观察,会逐渐形成敏感数据的持续累计泄露。特别是在电力数据跨域共享和多主体协同使用场景下,泄露风险并不仅取决于数据内容是否敏感,还与访问主体是否越权、流转路径是否合规、接收对象是否授权以及业务用途是否匹配密切相关。因此,如何准确识别敏感数据违规流转、用户越权访问和数据脱库等非常规泄露行为,成为电力数据安全防护亟须解决的重要问题。
现有数据泄露识别方法主要包括敏感内容识别、访问控制策略和流量异常检测三类技术路线。基于敏感内容识别的方法通常采用关键词匹配、正则表达式、文档指纹、语义签名或命名实体识别,识别待传输内容中的敏感字段和隐私实体。文献[9]提出了一种融合预训练语言模型与序列标注模型的电力业务隐私实体识别方法,用于识别电力业务数据交互过程中的隐私实体和敏感信息,但难以进一步判断敏感数据是否由合法主体访问、是否流向允许区域以及是否符合授权业务用途。
基于访问控制策略的方法主要从主体权限、数据标签和策略规则等角度约束数据访问行为。文献[10]提出一种面向智能电网的数据泄露防护系统,通过数据标签、策略表达以及终端侧与网络侧联动实现数据流转管控。文献[11]提出基于数据标签和策略表达的分布式内容过滤算法。文献[12]提出基于模拟退火和基因表达式编程的内容过滤函数挖掘方法。文献[13]提出面向数值型敏感数据的识别方法。文献[14]进一步提出基于特征选择的数据过滤函数增量挖掘方法。上述研究为电力数据策略约束、标签管控和敏感数据过滤提供了重要基础,但多数方法仍以静态权限规则、标签匹配或局部过滤函数为主要判别依据,对动态业务行为、长期累计规模、跨域接收方变化和主体权限关系之间的关联刻画不足,难以有效识别嵌入正常业务流程中的越权访问、违规流转和持续性数据外泄行为。
基于流量异常检测的方法主要从通信行为和运行状态角度发现异常。机器学习方法已广泛应用于智能电网攻击检测、异常行为发现和风险识别[15-20]。文献[19]提出多变量入侵检测系统,通过融合网络流、协议包和运行数据等多层次特征,提高智能电网异常检测能力,能够发现访问频次、连接对象、协议字段和通信规模中的异常偏离。针对高频采集、低时延互动和长时序运行数据建模,采用通感协同、滑动窗口自编码器、长短期记忆网络(Long Short-Term Memory, LSTM)和生成对抗网络等方法提升数据感知、异常检测、数据增强和序列重构能力[21-27]。对于电力数据泄露风险识别而言,单纯流量特征容易将正常业务波动误判为数据泄露。
三类传统数据泄露检测方法分别从敏感内容、访问权限和通信行为角度提升了安全防护能力,但对数据安全属性、主体权限关系和流转合规性的理解能力仍然不足。网络数据标签标识技术为解决上述问题提供了新的思路。网络数据标签可用于描述数据对象的权属、类别、敏感度、流转范围和安全约束,其生成、绑定、传输、核验、接收和日志留存过程能够贯穿数据流转全生命周期[4]。对于电力业务系统而言,安全标识不仅是数据治理和访问控制的基础字段,也是理解数据是否被合规访问、合规传输和合规使用的重要外生语义来源,补足传统流量特征难以表达的数据属性、主体权限和合规边界。因此,如何将长时序流量行为与安全标识语义进行有效对齐,并刻画实际流转行为与授权安全边界之间的偏离关系,是电力数据非常规泄露风险识别面临的关键挑战。
针对上述问题,本文提出一种内外生语义协同的电力数据非常规泄露风险识别方法。首先,将数据包按时间片聚合为时间片统计特征,并进一步构成长时序窗口,刻画访问频次、数据规模、接收方数量、动态标识数量、流转序号和累计导出量等内生语义文本;其次,基于静态标识、动态标识及其关联日志构造外生语义文本,描述数据源主体、数据分级、允许流转域、数据提供方、数据接收方和签名状态等安全标识事实;然后,设计面向长时序场景的稀疏内外生语义融合、风险语义压缩和跨模态重构机制,实现实际流转行为与安全标识语义之间的细粒度对齐;最后,以重构误差和风险语义压缩结果形成风险评分与归因向量,实现对电力数据非常规泄露行为的识别。本文主要贡献如下:
1)提出一种面向电力数据非常规泄露风险的内外生语义融合技术。长时序业务流量提供内生语义,安全标识文本提供外生语义,解决二者在粒度、形式和含义不一致时的跨模态融合问题。
2)设计风险语义压缩与跨模态重构的检测方法。通过引入稀疏注意力机制,减少长时序窗口中无关时间片与无关语义字段之间的冗余交互,在不显著增加端到端推理开销的情况下提升异常检测能力。
3)构建面向电力数据泄露场景的实验验证方案,在公开电力通信流量的基础上,结合电力数据分类分级与安全标识要求,验证方案的有效性。
电力业务系统中的数据交互通常发生在调度运行、营销服务、设备运维、跨区共享、第三方接口调用和远程运维调试等场景中。与普通网络异常不同,电力数据泄露风险不仅与通信流量大小、访问频次和连接对象有关,还与数据分级、访问主体、接收对象、业务用途和允许流转范围等安全约束密切相关。因此,本文将电力业务流量与安全标识共同作为模型输入,分别构建内生语义和外生语义,刻画实际行为与安全约束之间的一致性关系。
电力业务系统中的一次数据流转通常包含多个数据包。设第t个时间片内采集到的数据包集合为
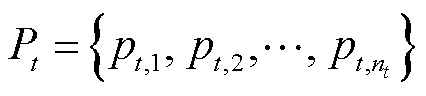 (1)
式中, 为第t个基础时间片内的第r条数据包;
 为该时间片内的数据包数量。本文对进行聚合统计,得到时间片级流量数值特征向量
 为
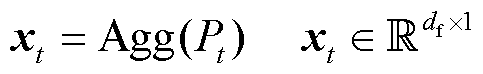 (2)
式中, 为时间片级流量数值特征维度;Agg(·)表示统计聚合函数。包含访问频次、数据规模、传输字节数、包数量、接收方数量、提供方数量、接口数量、跨域计数、静态标识数量、动态标识数量、同一静态标识最大流转序号、过去若干时间片累计数据规模和签名未通过次数等特征。
为刻画电力数据泄露行为的长期、低频和累计特征,本文将连续L个基础时间片的统计特征组成第i个长时序流转窗口 ,表示为
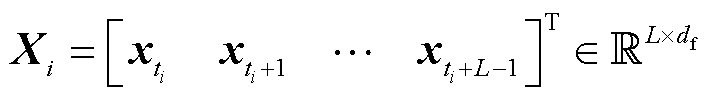 (3)
式中, 为第i个长时序窗口起始时间片索引;L为窗口长度。用于捕捉跨时间片的持续访问、分批导出、接收方变化和累计流转行为。
本文面向电力数据非常规泄露识别任务构造内生语义文本,将长时序窗口中的时间片统计特征转写为流量行为描述,内生语义文本 定义为
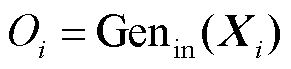 (4)
式中,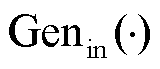 表示内生语义文本生成函数。描述窗口内访问频次、数据规模、接收方数量、动态标识数量、流转序号、累计数据规模和相邻时间片变化等客观统计信息。
电力业务安全标识由静态标识和动态标识共同组成。静态标识用于描述数据自身属性,主要包括静态标识位、数据源主体、数据分级和允许流转域等字段;动态标识用于描述数据流转过程,主要包括动态标识位、数据规模、时间戳、数据传输校验码、数据提供方、数据接收方、数据分级、允许流转域和数字签名等字段。设第t个时间片内数据包携带的静态标识集合和动态标识集合分别为 和
 ,电力数据安全管控策略库为R。则第t个时间片对应的外生语义文本
 定义为
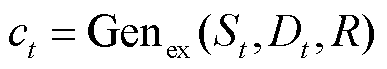 (5)
式中,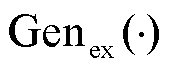 表示外生语义生成函数。该函数将静态标识、动态标识及其关联日志转换为自然语言文本,用于描述数据源主体、数据分级、允许流转域、数据提供方、数据接收方、数据规模、流转序号和签名状态等客观事实。
对于长时序窗口,其对应的外生文本片段 反映了同一时间范围内安全标识携带的数据属性和流转事实,表示为
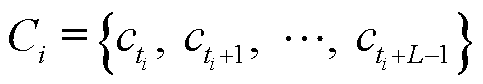 (6)
电力数据非常规泄露风险,是指数据流转行为在短时间窗口内呈现出一定合法性,但在较长时间尺度上表现出与数据安全标识约束、主体授权关系或流转边界不一致的持续性数据外泄风险。该类风险的核心不是瞬时大规模流量突变,而是实际流转行为与安全约束之间的持续偏离,通常具有单次合法、过程隐蔽、低频分散和长期累计等特征。与常规数据泄露相比,非常规泄露可从五个方面进行判定:①在行为主体上,访问者可能为合法账号、合法终端或具备部分权限的业务主体,而非完全非法的外部入侵者;②在流转路径上,数据可能经过合法接口、正常业务链路或多跳转发路径流出,但实际接收域、接收主体或业务用途偏离允许流转范围;③在泄露规模上,单次访问或单次传输规模可能较小,不会形成明显流量峰值,但多次访问后会形成敏感数据累计外流;④在持续时间上,泄露行为往往跨越多个时间片,呈现低频、分散和持续特征;⑤在实施方式上,违规主体可能通过分批导出、接口滥用、越权查询、跨域转发、标识伪造或签名异常等方式嵌入正常业务流程,使其在短窗口内与正常业务行为较为相似。
本文关注由网络攻击、越权访问、接口滥用和跨域违规传输引发的电力数据泄露风险,不涉及硬盘丢失、设备遗失、移动介质遗失、纸质文件泄露等物理数据泄露场景。
根据上述定义,本文在长时序窗口层面刻画非常规泄露风险。对于第i个长时序窗口,模型关注的不是单次访问是否异常,而是窗口内行为主体、实际接收域、流转路径、累计规模和实施方式是否与安全标识约束持续偏离。由此,风险识别任务可表示为对长时序行为表示与外生安全语义约束之间一致性的判别。给定第i个长时序窗口的数值输入和外生语义文本,本文目标是学习风险识别函数,即
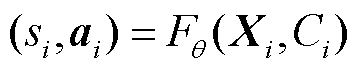 (7)
式中, 为第i个长时序窗口的非常规泄露风险评分,
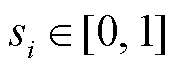 ;
 为风险归因向量;
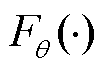 表示待学习模型;
 为模型的可学习参数集合。若大于阈值τ,则判定当前长时序窗口存在非常规泄露风险,表示为
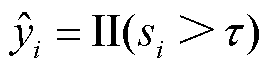 (8)
式中, 为指示函数;
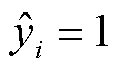 表示存在非常规泄露风险,
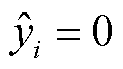 表示正常业务流转。
本文方法由数值时序编码、内生语义文本编码、外生语义文本编码、稀疏语义融合、风险语义压缩和跨模态重构六个部分组成。首先,数值时序编码器对进行归一化、分片和掩码处理,学习长时序流转行为表示;其次,内生语义文本编码器对进行编码,得到实际流转行为的文本语义表示;再次,外生语义文本编码器对进行编码,得到安全标识语义表示;然后,稀疏交叉注意力机制在内生语义和外生语义之间建立关联;进一步地,风险语义压缩模块过滤冗余标识字段,保留与数据泄露风险判别相关的关键信息;最后,跨模态重构模块基于压缩语义对被掩码的数值时序进行重构,并以重构误差形成风险评分。所提方案具体流程如图1所示。
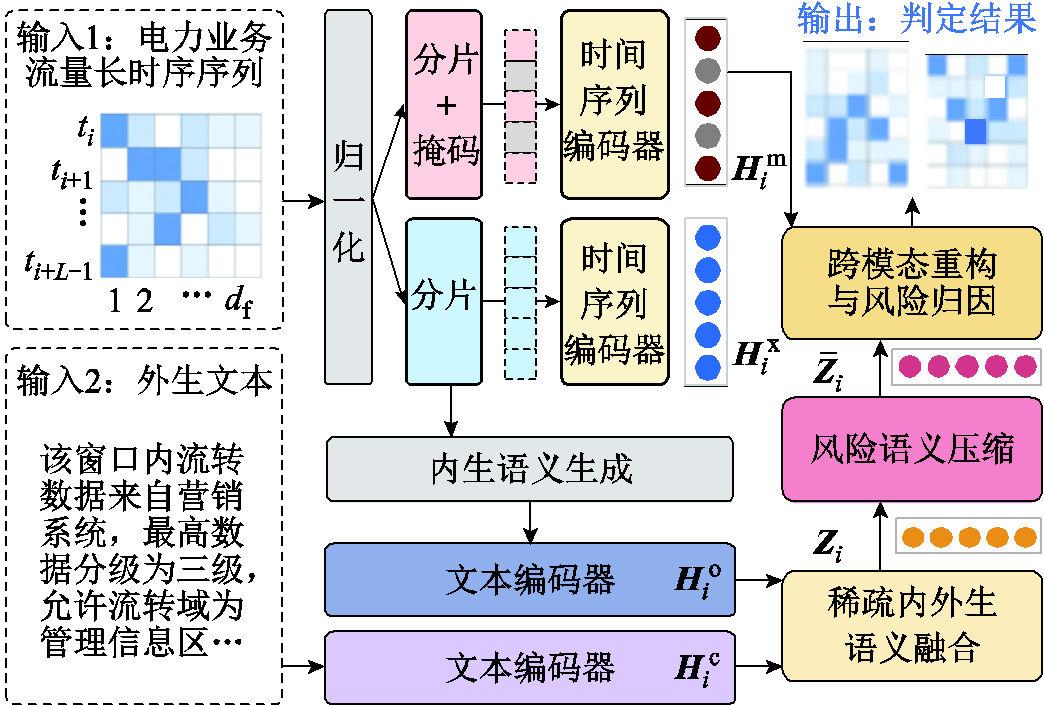
图1 所提方案流程
Fig.1 Framework of the proposed method
2.2.1 长时序编码
对输入长时序窗口进行归一化处理,得到 。随后将其划分为若干局部片段,即
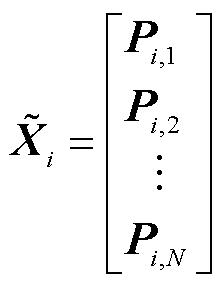 (9)
式中, 为第n个局部片段,
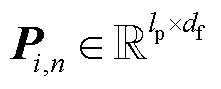 ,
 为片段长度;N为片段数量,n=1, 2,…, N。时序编码器将局部片段映射到隐空间,该过程表示为
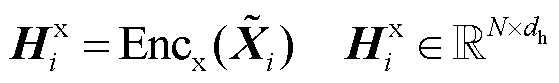 (10)
式中,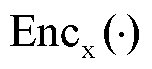 表示时序编码器;
 为第i个长时序窗口经时序编码器得到的数值时序隐表示;
 为隐表示维度。本文采用稀疏注意力机制,仅保留局部片段间的重要关联,以降低全连接注意力的计算开销。对于查询矩阵Q、关键矩阵K和值矩阵V,稀疏注意力定义为
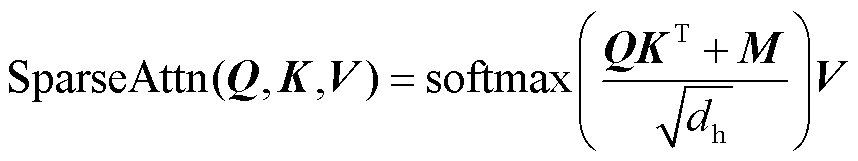 (11)
式中,M为稀疏掩码矩阵;softmax(·)为激活函数。若矩阵M中的位置对(u, v)被保留,则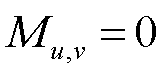 ;否则,
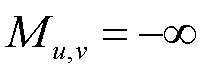 。
2.2.2 内外生文本编码
采用确定性模板生成内生语义文本和外生语义文本。第i个长时序窗口对应的内生语义文本由自动生成,用于描述长时序窗口内的客观统计行为。通过文本编码器得到内生语义文本表示 为
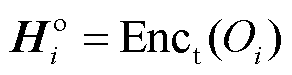 (12)
式中,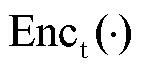 为文本编码器。
第i个长时序窗口对应的外生语义文本由安全标识生成,用于描述数据属性和流转事实。通过文本编码器得到外生语义文本表示 为
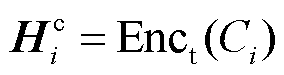 (13)
本文采用轻量级编码器Transformer Encoder,并与时序编码器和重构模块共同参与端到端训练。该编码器将内生语义文本和外生语义文本映射到统一语义空间,为后续稀疏交叉注意力中的语义对齐与融合提供表示基础,从而利用数值行为特征和安全标识语义进行风险识别。
本文采用稀疏交叉注意力机制,建立电力业务流量与安全标识语义之间的关联,如图2所示。首先,将数值时序表示与内生文本表示进行融合,以内生语义文本表示作为查询,以外生语义文本表示作为键和值,进行跨视角融合,得到融合语义表示 为
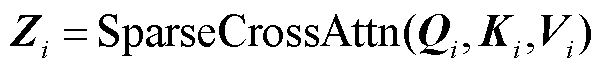 (14)
式中,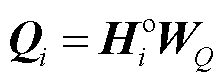 ,
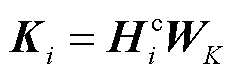 ,
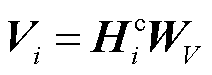 ;
 、
 、
 为参数矩阵。稀疏交叉注意力模块定义为
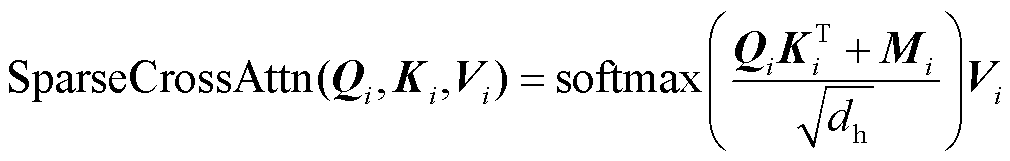 (15)
式中, 为内外生语义之间的稀疏关联掩码。
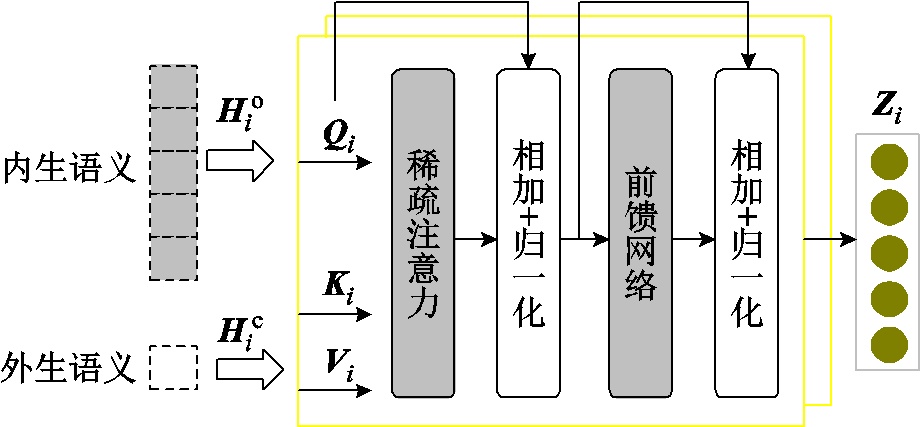
图2 稀疏内外生语义融合
Fig.2 Sparse endogenous-exogenous semantic fusion
稀疏关联掩码用于控制内生语义与外生语义之间的注意力连接范围。本文从字段映射关系、时间邻域关系和Top-K语义相似度三个方面共同确定稀疏关联掩码。字段映射关系用于建立流量统计特征与数据分级、允许流转域、接收方、签名状态等安全标识字段之间的先验关联;时间邻域关系用于保留相同或相邻时间片之间的局部依赖;Top-K语义相似度用于保留注意力得分较高的跨模态语义关联。本文设置K=8,使模型在保留关键语义关系的同时减少冗余字段干扰。
设Ω为预定义字段映射集合, 为第i个长时序窗口中第p个内生语义片段的编码表示,
 为第i个长时序窗口中第q个外生语义片段的编码表示。记
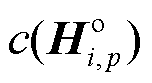 和
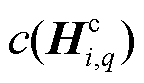 分别表示二者对应的字段类型,用于判断是否满足字段映射关系;记
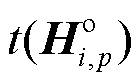 和
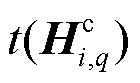 分别表示二者所属的时间片索引;ρ表示允许关联的时间邻域范围,用于判断是否满足时间邻域关系。根据内外生语义之间的语义相似度,得到与最相似的K个外生语义片段索引集合
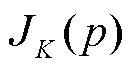 。则稀疏关联掩码中的元素
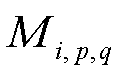 表示为
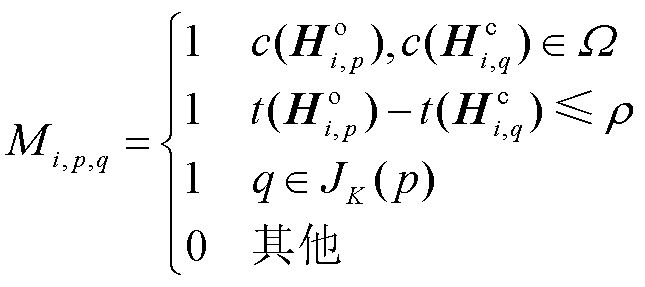 (16)
本文引入跨模态对齐损失Lalign,增强数值行为表示与语义表示的一致性。
设当前批次中 与
 的相似度为
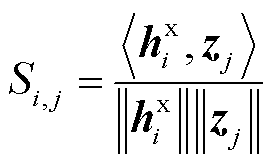 (17)
式中,为第i个长时序窗口的数值行为表示;为当前批次中第j个长时序窗口的融合语义表示; 为求内积运算;
 为与之间的余弦相似度。当i=j时,二者来自同一个长时序窗口,构成正样本对;当i
 j时,二者来自不同长时序窗口,构成负样本对。
则对齐损失 定义为
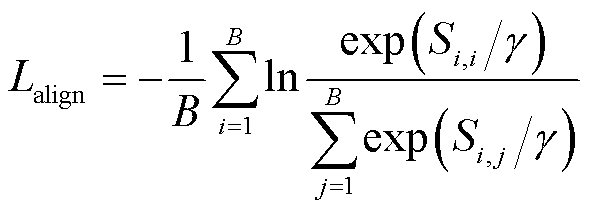 (18)
式中,B为批次大小;γ为温度系数。
外生语义文本中可能包含大量与当前风险判别弱相关的字段,本文将融合语义表示压缩为更紧凑的风险语义表示,将压缩结果记为 ,最优压缩表示
 定义为
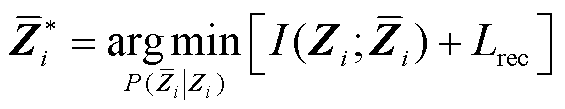 (19)
式中,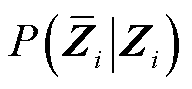 为给定条件下生成的条件分布;
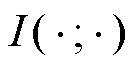 表示融合语义表示与压缩风险语义表示之间的互信息;
 为跨模态重构损失。给定融合文本表示,通过多层感知机(Multi-Layer Perceptron, MLP)计算保留概率矩阵
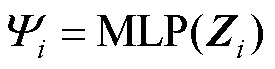 ,
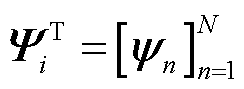 ,
 为第n个融合语义片段对应的dh维保留概率向量,
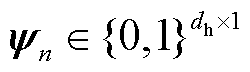 ;随后采样二值掩码矩阵
 ~
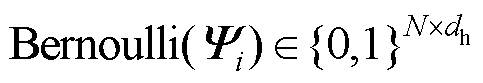 ,并得到压缩风险语义表示
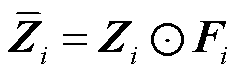 ,
 表示对应元素逐元素相乘。风险语义压缩过程如图3所示。
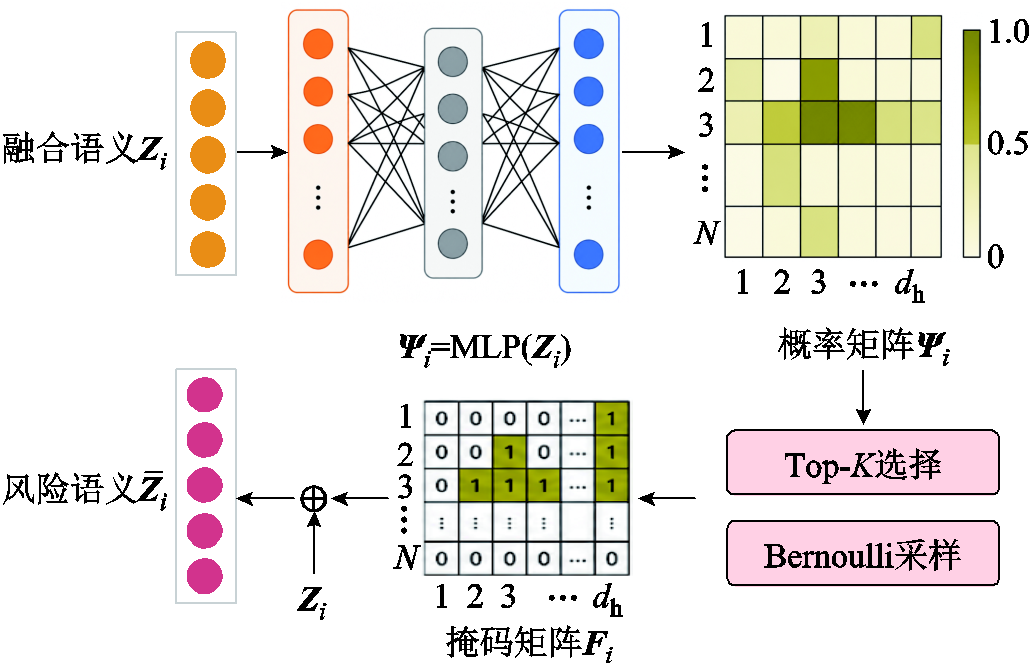
图3 风险语义压缩
Fig.3 Risk semantic compression
为控制压缩程度,本文采用互信息上界形式,即
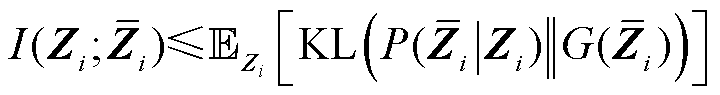 (20)
式中,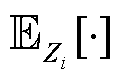 表示关于的数学期望;
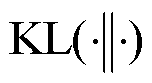 表示Kullback-Leibler散度;G(·)表示变分先验分布。
由此得到内容压缩损失 为
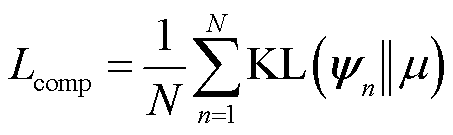 (21)
式中,μ为控制压缩程度的超参数,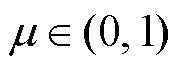 。为避免相邻时间片的压缩结果剧烈跳变,引入平滑约束
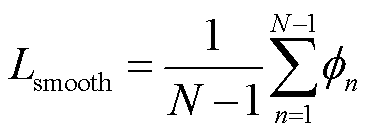 ,
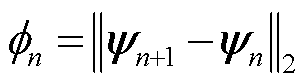 。风险语义压缩模块的损失为
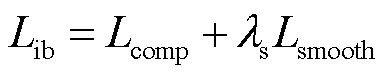 ,其中
 为平滑项权重。
风险语义压缩模块的超参数通过验证集确定。本文以验证集Aff-F指标作为主要选择依据,对风险语义保留率、平滑损失权重、对齐损失权重和压缩损失权重进行调节,并在所有对比实验和消融实验中保持一致。该设置可避免压缩比例过低造成关键信息丢失,同时避免压缩比例过高引入冗余语义干扰。
本文设计跨模态重构机制,刻画实际流转行为与语义约束之间的偏离,如图4所示。首先对原始数值长时序窗口进行随机掩码,得到 ,并通过共享时序编码器获得掩码表示
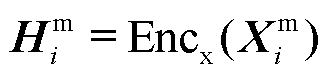 ,以
 作为查询,以压缩风险语义作为键和值,完成跨模态重构,表示为
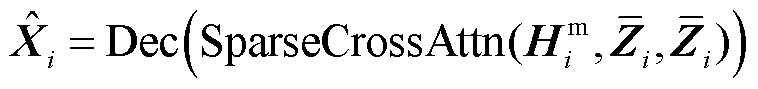 (22)
式中, 为重构后的长时序窗口;为风险语义压缩模块输出的压缩风险语义表示;Dec(·)表示重构解码器。
重构损失函数定义为
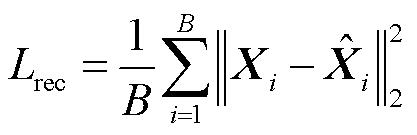 (23)
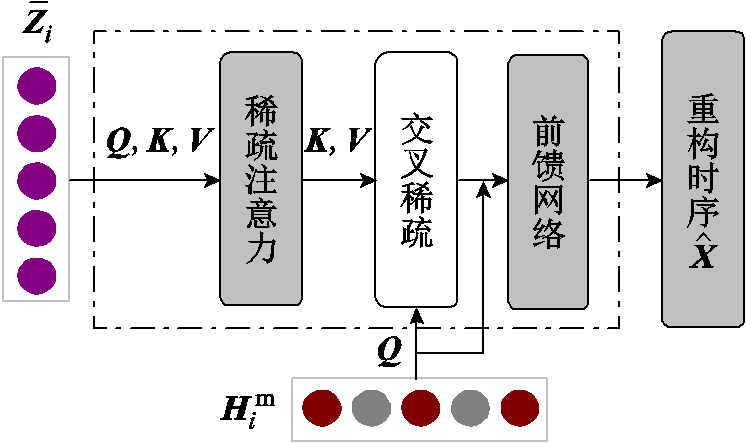
图4 跨模态重构
Fig.4 Cross-modal reconstruction
推理阶段,本文以重构误差形成风险评分,表示为
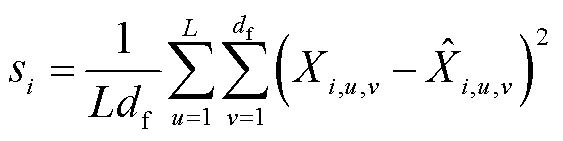 (24)
式中,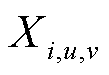 和
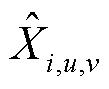 分别为第i个原始窗口和重构窗口在第u个时间片、第ν个特征维度上的取值。当
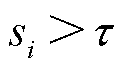 时,判定第i个长时序窗口存在非常规泄露风险。
本文基于压缩风险语义表示生成风险归因向量,表示为
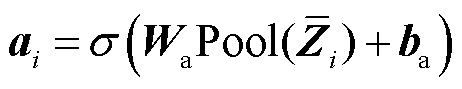 (25)
其中
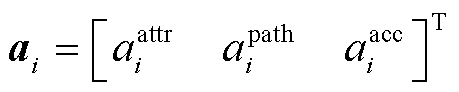
式中, 为Sigmoid函数;Pool(·)表示池化操作;
 和
 为可学习参数;
 、
 、
 分别为主体授权偏离、流转路径合规性偏离和长时序累计外流偏离的归因得分。其中,主体授权偏离对应行为主体和接收主体是否越权,流转路径合规性偏离对应实际接收域、流转路径和业务用途是否超出允许范围,长时序累计外流偏离对应低频、分散、持续导出等规模和时间维度上的异常累积。
模型训练目标由跨模态对齐损失、风险语义压缩损失和跨模态重构损失共同组成,总训练损失 表示为
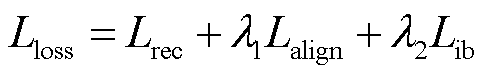 (26)
式中, 和
 为权重系数。
本文以公开电力通信流量数据为基础,结合电力数据分类分级与安全标识管理要求,构建Power Leakage数据集。在保留原始流量统计特征的基础上,进一步生成业务场景映射、字段级安全标识、主体授权关系和时间片级风险标签,用于验证本文方法对电力数据非常规泄露风险的识别能力。本文选取ELECTRON-MITM-Attack Dataset[28]和SANDI-2024[29]作为基础流量来源。其中,前者用于提供包含中间人攻击行为的电力通信过程样本,后者用于提供变电站场景下的电力通信流量样本。
在数据集构建过程中,首先对原始流量记录进行时间对齐,并以1 min为基础时间粒度构造时间片。随后,依据通信源端、通信目的端、端口信息、协议类型、流量方向和字节数等字段,生成时间片级流量统计特征。最后,结合电力业务场景映射关系,为流量记录补充业务场景、映射接口/服务、数据分级、授权接收域、授权接收主体、实际接收域、实际接收主体、流转序号、流转跳数和签名状态等电力数据流转过程相对应的安全标识记录。
本文构造三类非常规泄露事件标签:①当高等级数据的实际接收域超出静态标识中规定的允许流转域时,标记为敏感数据违规流转;②当数据接收方不属于授权接收主体集合时,标记为用户越权访问;③当高等级数据在连续长时序窗口内以低频、小规模方式持续累计导出,并超过设定阈值时,标记为长期累计导出。若某一时间片内存在上述任一类事件,则将该时间片标记为非常规泄露风险时间片;否则,将其标记为正常时间片。
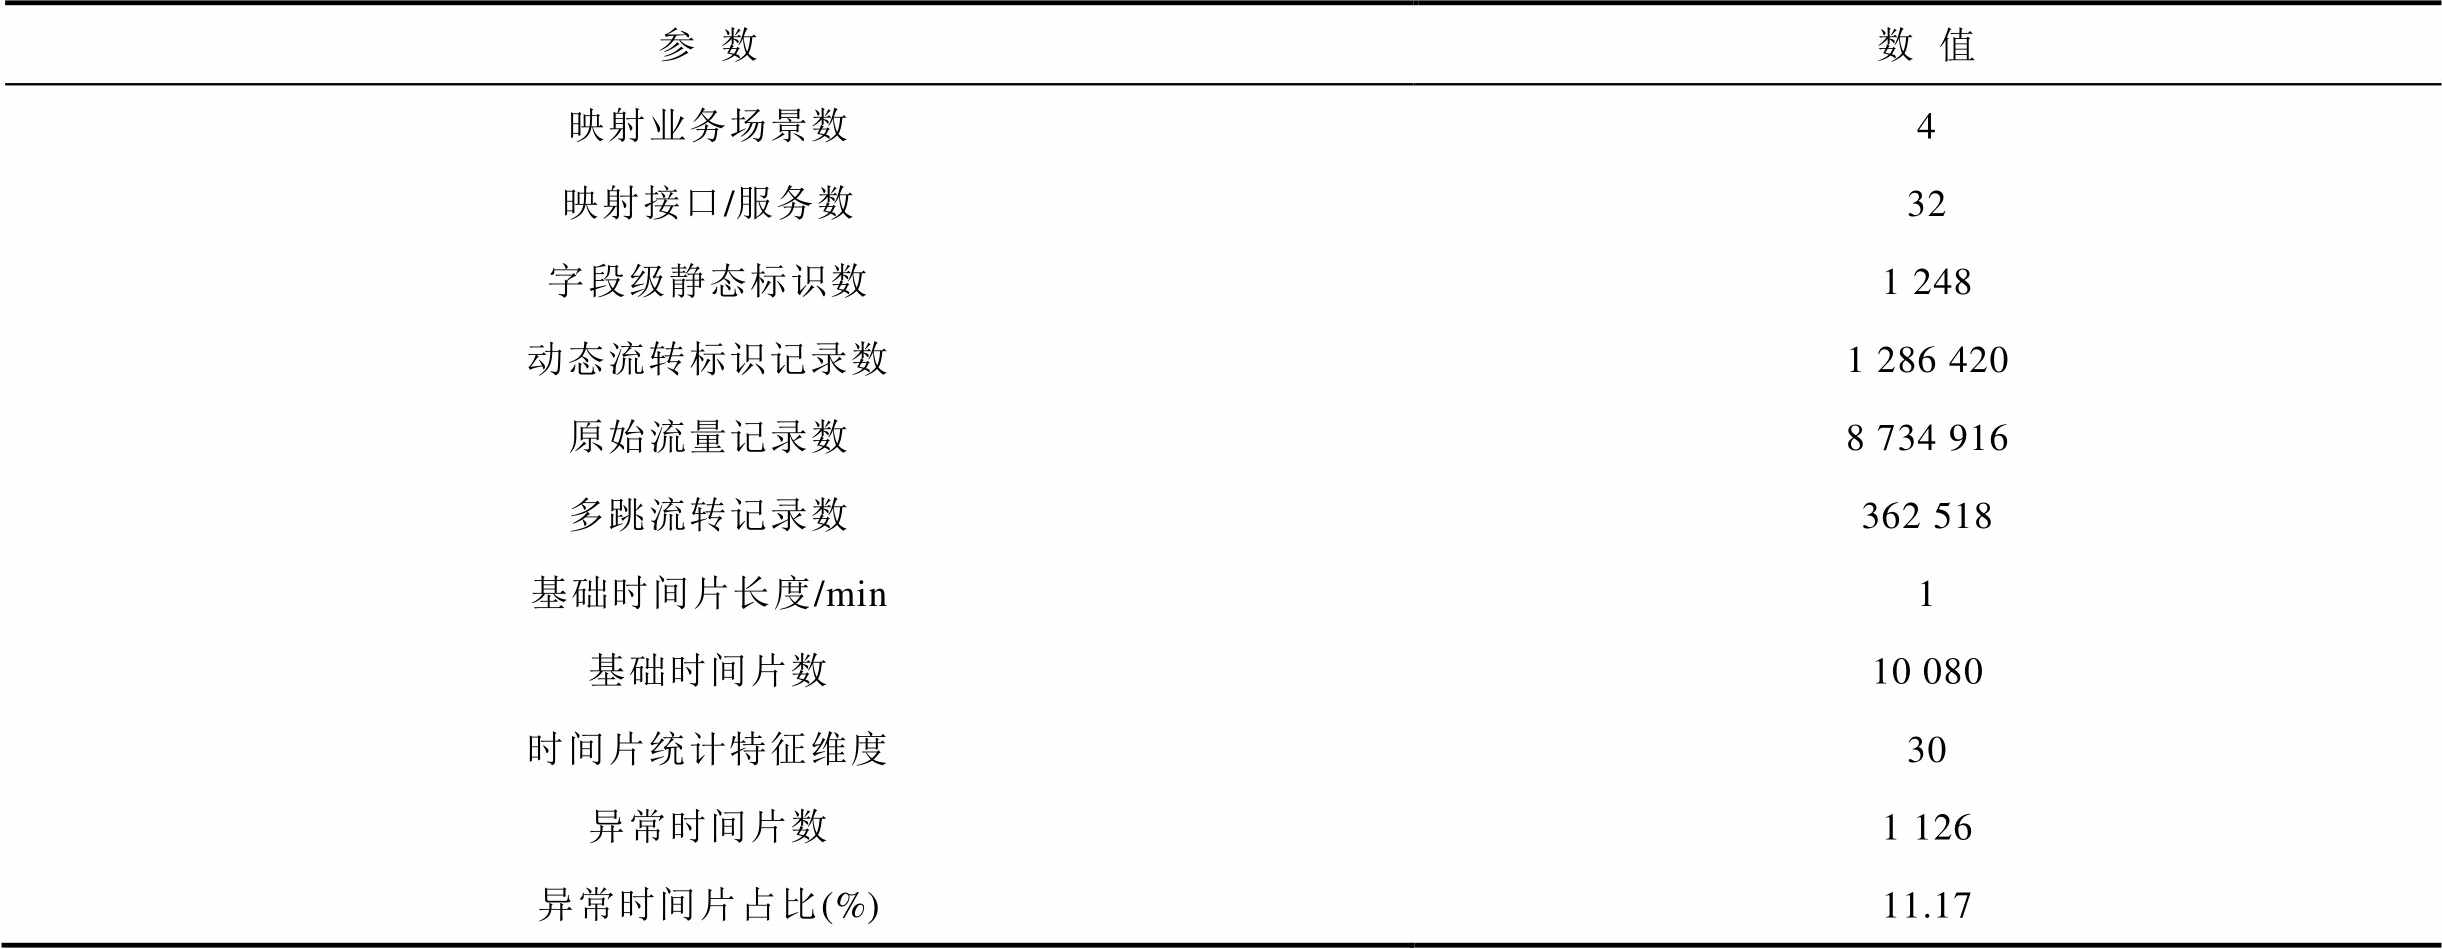
基于上述场景化映射与安全标识打标过程,本文构建PowerLeakage数据集。该数据集由长时序数值数据、外生语义文本和异常标签三部分组成,数据集描述见表1。长时序数值数据用于刻画每个时间片内的流量行为变化,包括访问频次、映射接口/ 服务数量、流量规模、传输字节数、包数量、接收方数量、提供方数量、最高数据分级、高等级数据占比、允许流转域编码、实际接收域数量、跨域计数、静态标识数量、动态标识数量、最大流转序号、最大流转跳数和重复静态标识计数等30个时间片统计特征。外生语义文本由场景化打标后每个时间片内的静态标识、动态标识和静动态映射日志自动生成,主要用于提供数据流转行为的业务背景和安全约束等客观事实。
表1 PowerLeakage数据集描述
Tab.1 Description of PowerLeakage dataset
参数数值 映射业务场景数4 映射接口/服务数32 字段级静态标识数1 248 动态流转标识记录数1 286 420 原始流量记录数8 734 916 多跳流转记录数362 518 基础时间片长度/min1 基础时间片数10 080 时间片统计特征维度30 异常时间片数1 126 异常时间片占比(%)11.17
本文将连续30个基础时间片构造为一个长时序流转窗口,并按照时间顺序划分训练集、验证集和测试集。训练集包含6 030个窗口,验证集包含2 010个窗口,测试集包含2 011个窗口。
3.2.1 实验设置
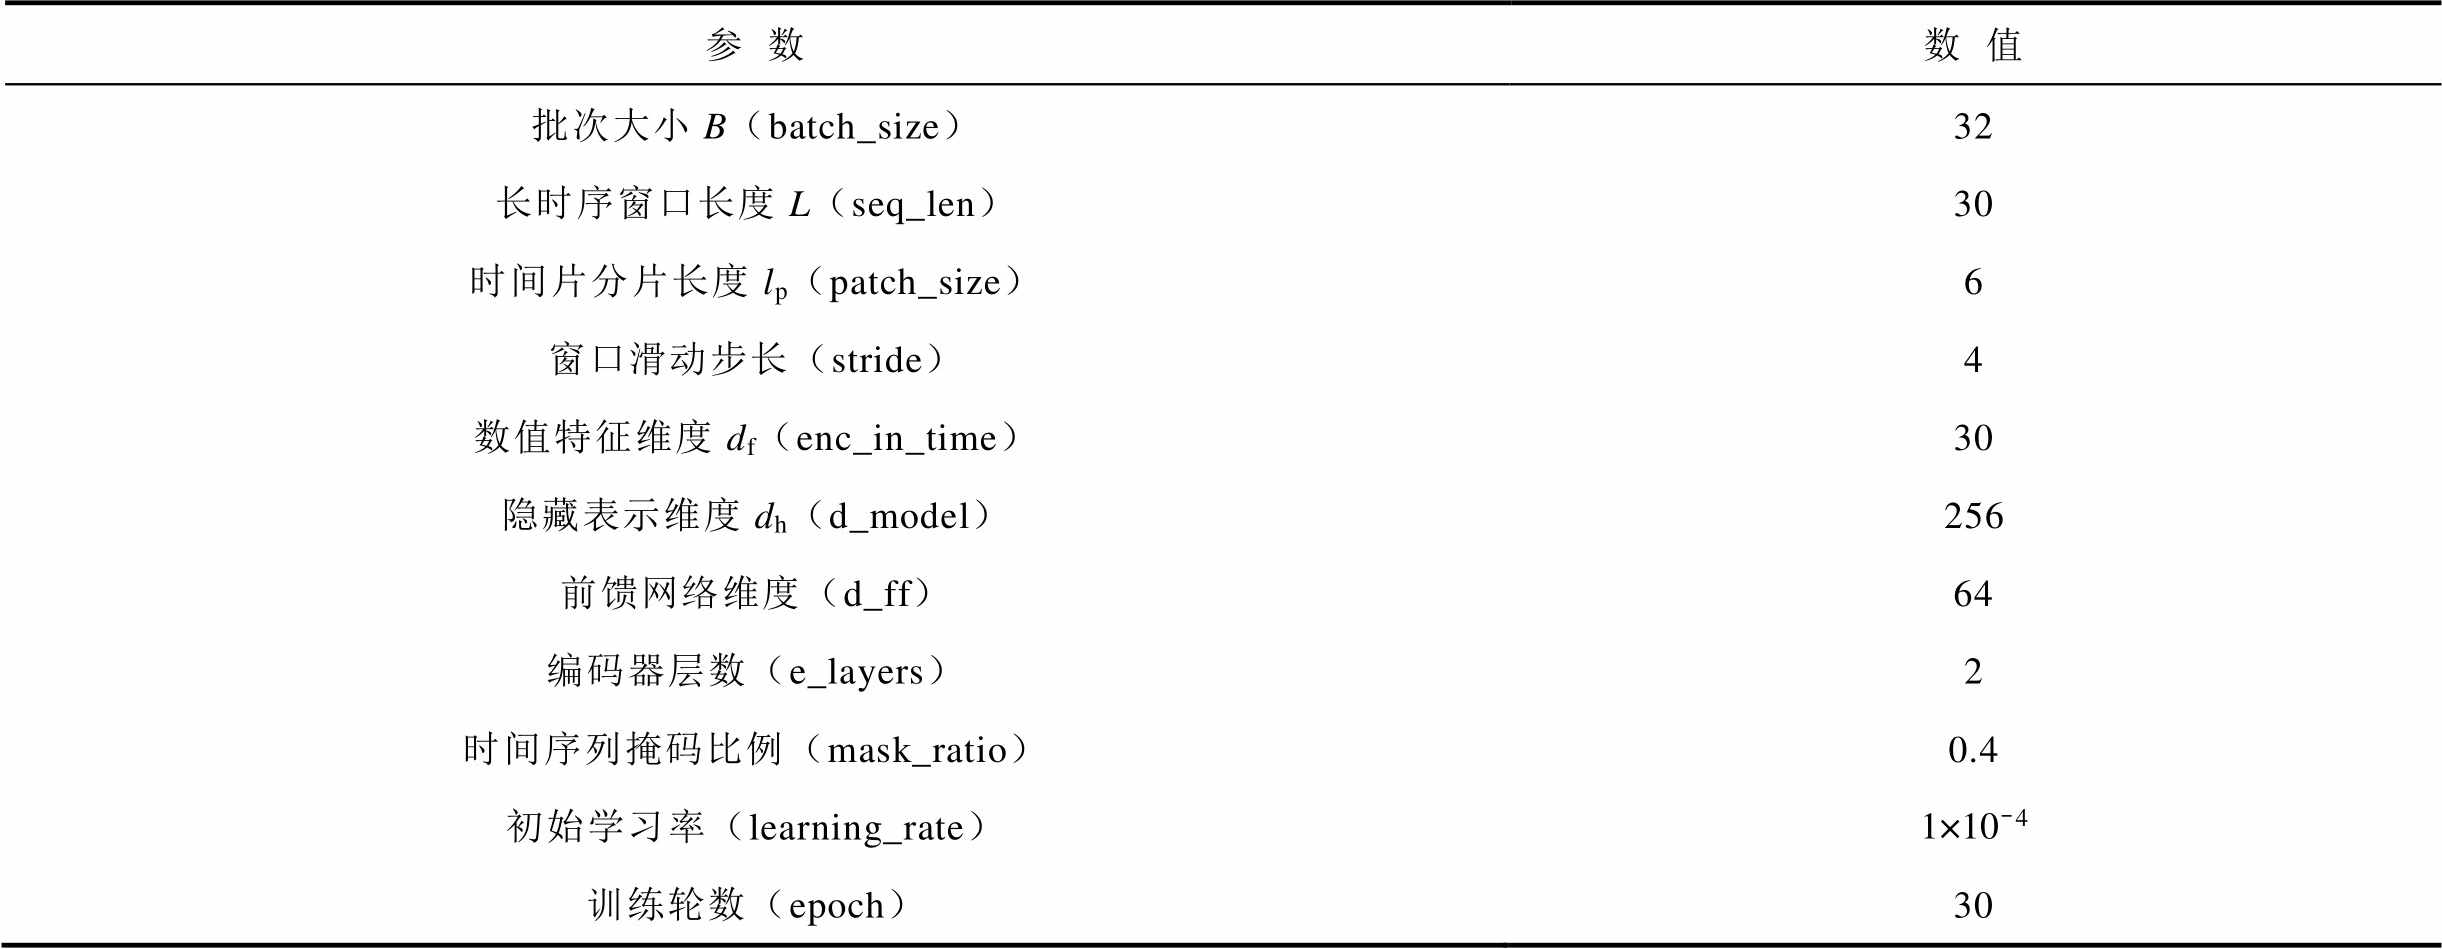
本文实验在Ubuntu 24.04.3 LTS服务器环境下完成。服务器配置为Intel Xeon Platinum 8488C处理器、755 GB内存和4张NVIDIA GeForce RTX 5090 GPU,单卡显存为32 GB。实验代码基于Python 3.10.11和PyTorch 2.9.0实现。模型的输入由长时序数值窗口和外生安全标识文本组成。数值特征在训练集上进行标准化处理,并将训练集得到的标准化参数统一应用于验证集和测试集,以避免数据泄露并保证实验设置的一致性。设置模型窗口长度为30,分片长度为6,滑动步长为4。设置隐藏维度为256,前馈网络维度为64,编码器层数为2,掩码比例为0.4,优化器采用Adam,初始学习率为1×10⁻⁴,批次大小为32,训练轮数为30。模型训练与结构超参数设置见表2。
风险判定阈值由模型在验证集上的表现确定。本文依据验证集上不同候选阈值对应的Aff-F结果,选择Aff-F最优的阈值作为最终判定阈值。该阈值综合考虑敏感数据违规流转、用户越权访问和长期累计导出等风险信息。
表2 模型训练与结构超参数设置
Tab.2 Training and architectural hyperparameter settings of the model
参数数值 批次大小B(batch_size)32 长时序窗口长度L(seq_len)30 时间片分片长度lp(patch_size)6 窗口滑动步长(stride)4 数值特征维度df(enc_in_time)30 隐藏表示维度dh(d_model)256 前馈网络维度(d_ff)64 编码器层数(e_layers)2 时间序列掩码比例(mask_ratio)0.4 初始学习率(learning_rate)1×10⁻⁴ 训练轮数(epoch)30
3.2.2 对比方法
为验证本文方法的有效性,本文选取循环神经网络(Recurrent Neural Network, RNN)、LSTM、双向长短期记忆网络(Bi-LSTM)、BiLC、无监督多变量时间序列异常检测模型(Transformer-based Anomaly Detection, TranAD)[30]和多模态交互时序模型(Multimodal Interactive Time Series model, MindTS)[31]作为对比模型。上述方法覆盖了基础循环神经网络、门控循环神经网络、双向时序建模方法、长时序异常检测方法、Transformer时序异常检测模型和多模态时间序列异常检测模型,能够全面反映现有时序模型在电力业务流转异常识别任务中的表现。所有对比方法采用相同的数据集划分、输入窗口长度和评价指标,保证实验结果的公平性。其中,RNN用于表征普通循环结构在该任务上的基准性能;LSTM通过门控机制建模长期依赖,适用于捕捉跨时间片的访问频次、数据规模和接收方变化;Bi-LSTM引入双向上下文信息,进一步增强连续异常区间的时序表达能力;BiLC作为长时序检测模型,用于对比长时间范围内异常行为建模能力;TranAD是一种面向多变量时间序列异常检测的Transformer模型,用于对比注意力机制在数值长时序异常检测中的表现;MindTS是一种面向多模态时间序列异常检测的方法,用于对比时间序列与文本语义信息联合建模能力。
3.2.3 评价指标
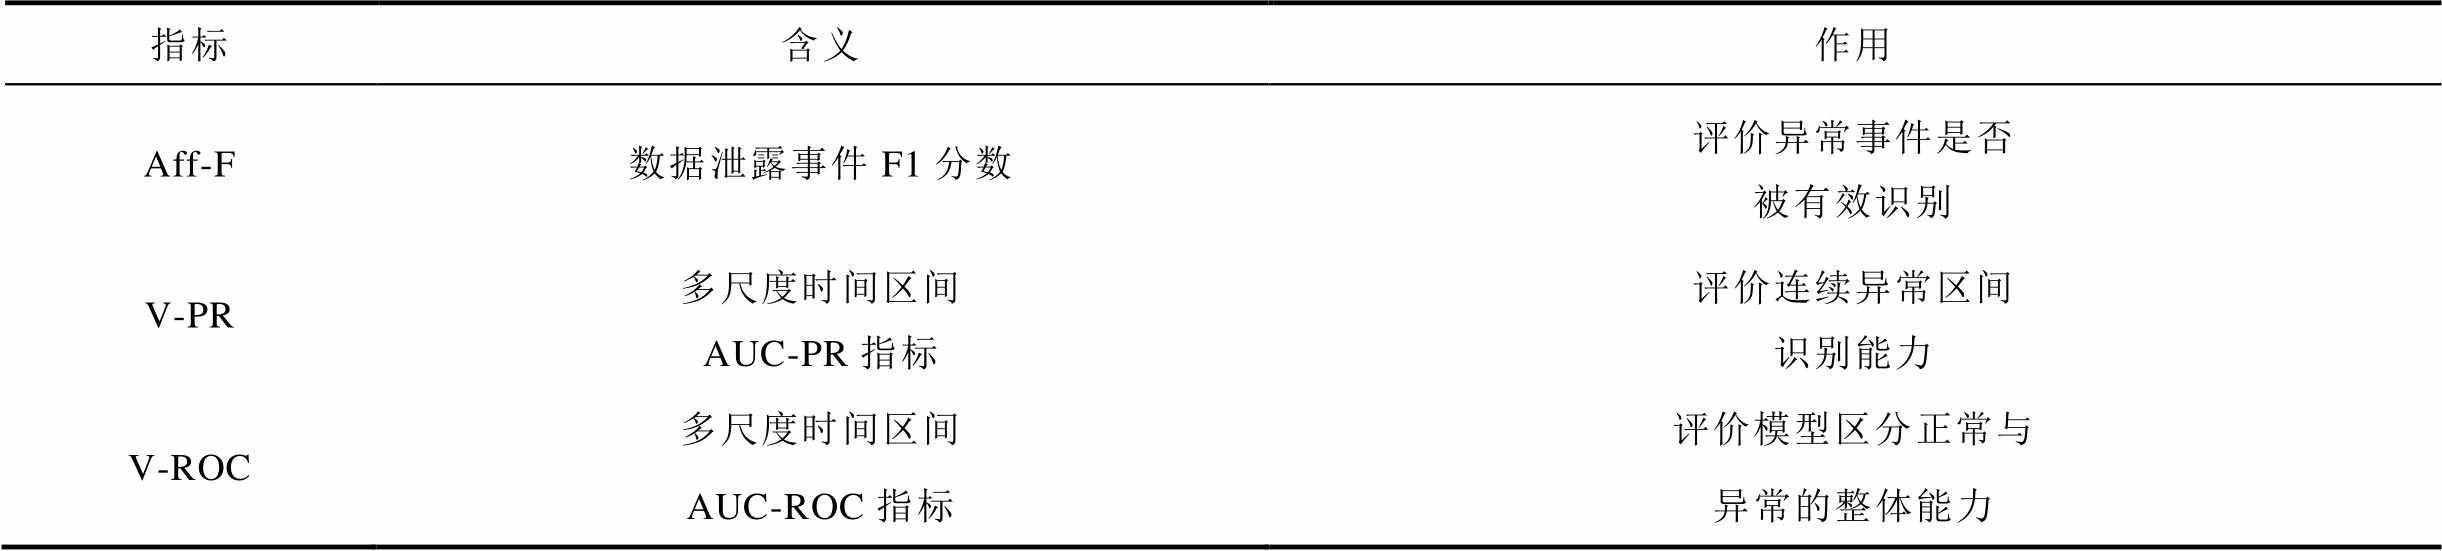
本文采用Aff-F、V-PR和V-ROC作为主要评价指标,评价指标说明见表3。与普通分类任务不同,时间序列异常检测更关注异常区间是否被有效识别,而不仅是单个时间点是否分类正确。对于电力数据非常规泄露场景,异常行为通常具有持续性和滞后性,模型预测结果与真实异常区间之间可能存在一定时间偏移。因此,仅采用传统的精度(Precision, P)、召回率(Recall, R)、F1分数或接受者操作特性(Receiver Operating Characteristic, ROC)曲线下面积(Area Under ROC Curve, AUC)指标,难以全面反映模型对连续异常事件的识别能力。
表3 评价指标说明
Tab.3 Description of evaluation metrics
指标含义作用 Aff-F数据泄露事件F1分数评价异常事件是否被有效识别 V-PR多尺度时间区间AUC-PR指标评价连续异常区间识别能力 V-ROC多尺度时间区间AUC-ROC指标评价模型区分正常与异常的整体能力
Aff-F是基于关联精度(Affiliated Precision)和关联召回率(Affiliated Recall)构造的事件级F1指标[32]。该指标通过建立预测异常区间与真实异常区间之间的局部归属关系,计算预测结果与真实异常事件在时间位置上的接近程度。与点级F1相比,Aff-F更适合评价连续异常事件是否被有效识别。V-PR和V-ROC是基于曲面下体积(Volume Under the Surface, VUS)构造的时间序列异常检测评价指标[33],可分别看作AUC-PR和AUC-ROC在时间序列异常检测场景下的扩展。该类指标在不同异常分数阈值和不同时间缓冲范围下构造评价曲面,并计算VUS,降低单一时间容忍范围对评价结果的影响。对于存在检测滞后、异常边界不确定和连续异常区间的非常规泄露检测任务,V-PR和V-ROC能够更稳定地反映模型整体检测性能。
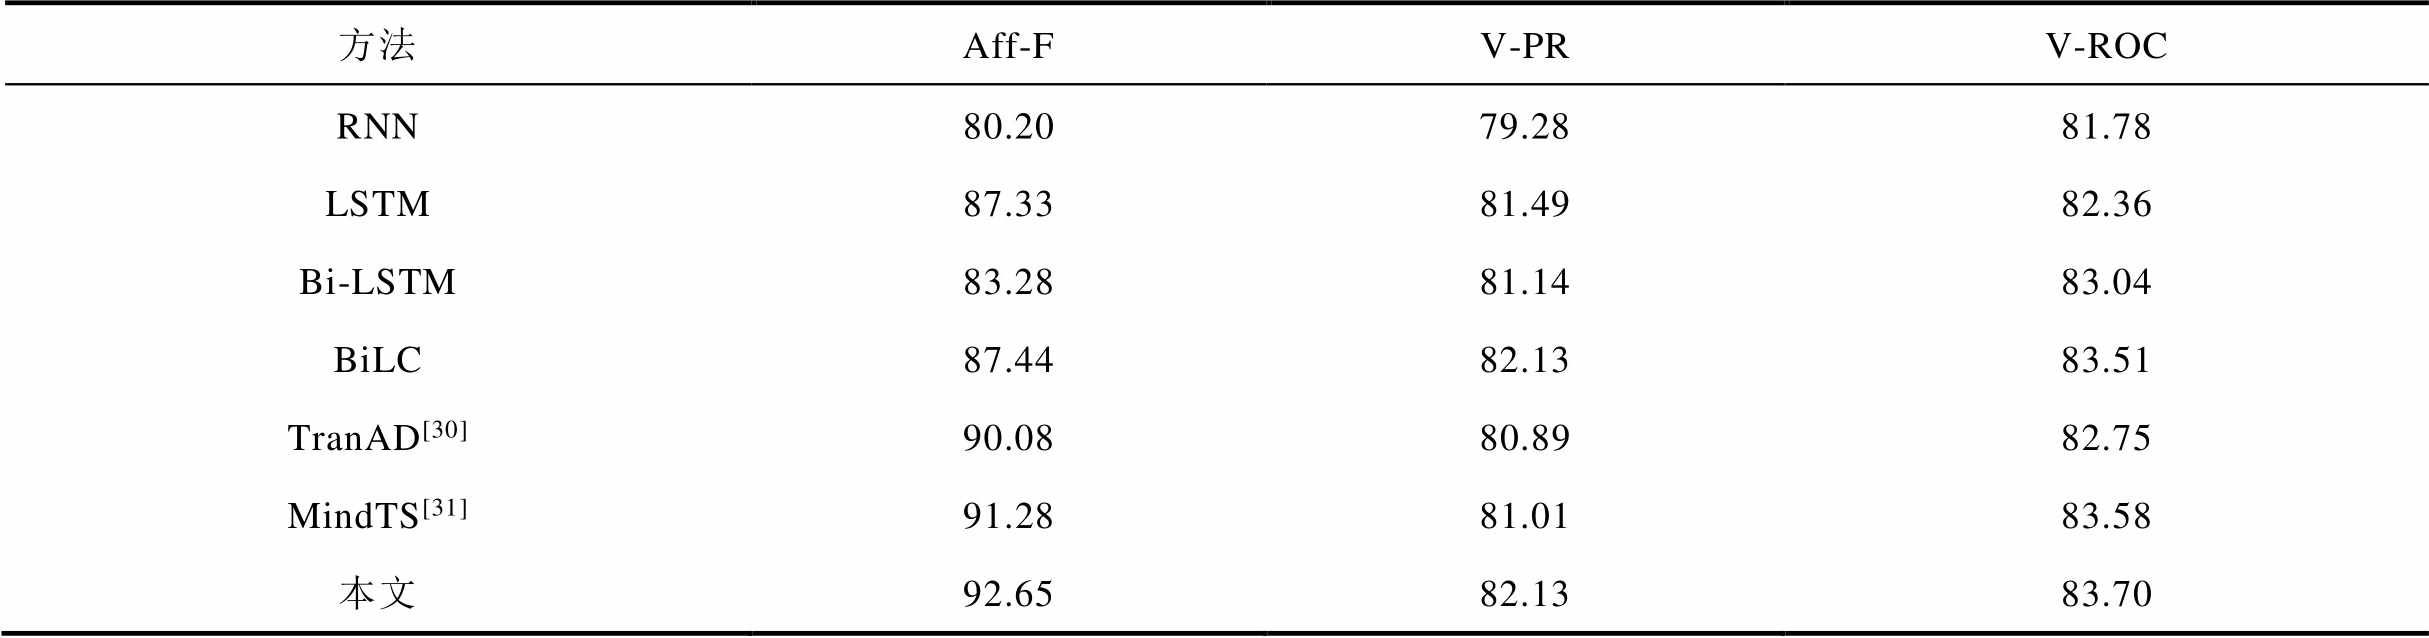
为验证本文方法在电力数据非常规泄露风险识别任务中的有效性,选取RNN、LSTM、Bi-LSTM、BiLC、TranAD[30]和MindTS[31]作为对比方法,在相同的PowerLeakage数据集、训练测试划分和评价指标下开展实验,从不同角度反映现有时序模型对电力业务流量异常的识别能力。本文采用Aff-F、V-PR和V-ROC作为评价指标,不同方法在PowerLeakage数据集上的性能对比见表4。
表4 不同方法在PowerLeakage数据集上的性能对比
Tab.4 Performance comparison of different methods on PowerLeakage (%)
方法Aff-FV-PRV-ROC RNN80.2079.2881.78 LSTM87.3381.4982.36 Bi-LSTM83.2881.1483.04 BiLC87.4482.1383.51 TranAD[30]90.0880.8982.75 MindTS[31]91.2881.0183.58 本文92.6582.1383.70
由表4可见,本文方法在Aff-F和V-ROC指标上分别达到92.65%和83.70%,均为最高结果;在V-PR指标上达到82.13%,与BiLC持平。与传统时序模型相比,本文方法可在长时序数值行为之外进一步利用安全标识和语义上下文信息。与Transformer时序异常检测模型TranAD相比,本文方法在Aff-F、V-PR和V-ROC上分别提升2.57、1.24和0.95个百分点。与多模态基线模型MindTS相比,本文方法分别提升1.37、1.12和0.12个百分点。相比之下,本文方法融合内生语义与外生语义,并通过稀疏语义融合、风险语义压缩和跨模态重构增强流量行为与安全标识之间的一致性建模,能更准确地识别非常规泄露风险。总体结果验证了本文方法在电力数据泄露风险识别任务中的有效性。
为分析本文方法中不同模块对检测性能的影响,开展消融实验。消融实验在相同数据集和评价指标下,分别去除外生语义文本、内生语义文本、稀疏内外生语义融合模块和风险语义压缩模块,并将稀疏注意力替换为普通注意力,与完整模型进行对比。通过观察不同模型变体的性能变化,进一步判断各模块对检测结果的贡献及其互补关系,明确模型性能提升的主要来源,验证内外生语义融合、风险语义压缩和稀疏注意力机制在电力数据非常规泄露风险识别中的有效性。消融实验设置和结果对比见表5。
由表5可以看出,完整模型在平均指标上取得最优结果,达到86.16%,说明各模块协同作用能够有效提升非常规泄露风险识别性能。去除稀疏内外生语义融合模块后,平均指标下降至82.79%,表明内生语义与外生语义之间的关联建模是影响检测性能的关键因素。去除外生语义文本后,平均指标下降至82.80%,Aff-F下降明显,表明安全标识所包含的数据属性、流转边界和合规约束能够有效补充流量特征中缺失的数据安全语义。相比之下,去除内生文本后模型性能下降较小,原因在于原始流量序列仍保留了部分趋势和周期信息,但内生语义仍有助于增强模型对长时序行为变化的表达能力。去除风险语义压缩模块后,模型平均性能下降,说明该模块能够抑制冗余语义干扰并保留与泄露风险相关的关键表示。将稀疏注意力替换为普通注意力后,虽然Aff-F有所提升,但V-ROC明显下降,表明普通注意力容易引入无关时间片和无关语义字段的干扰,而稀疏注意力更有利于捕获长时序、低频和分散的数据泄露行为。总体来看,消融实验验证了外生语义补充、稀疏语义融合、风险语义压缩和跨模态重构对提升电力数据非常规泄露风险识别性能的有效性。
表5 消融实验设置和结果对比
Tab.5 Settings and results comparison of ablation experiments (%)
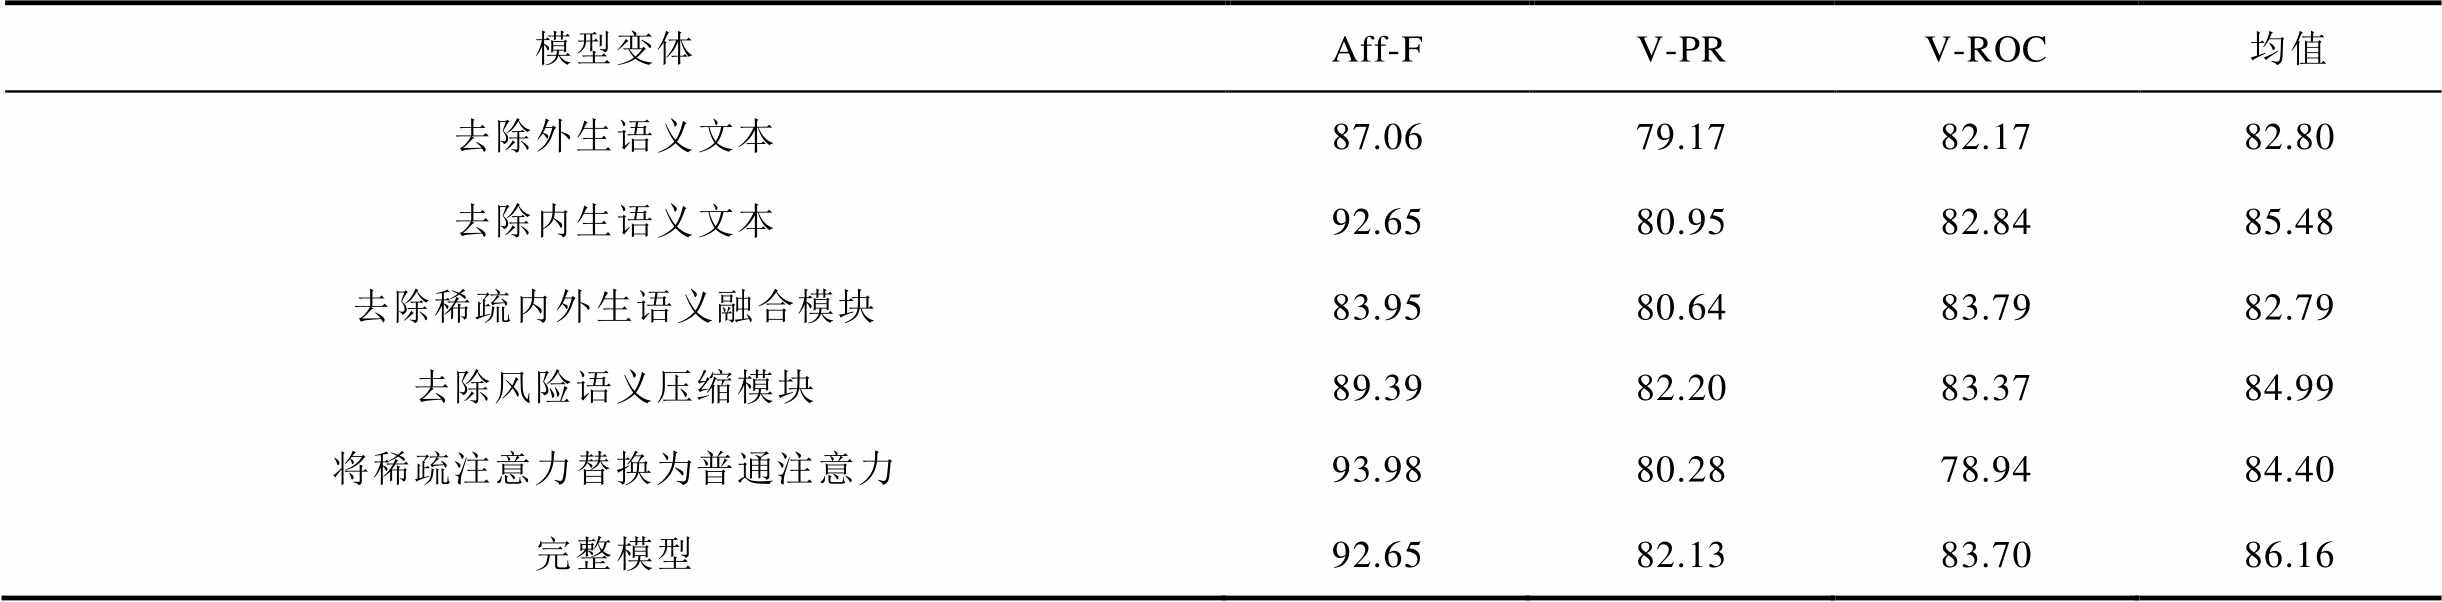
模型变体Aff-FV-PRV-ROC均值 去除外生语义文本87.0679.1782.1782.80 去除内生语义文本92.6580.9582.8485.48 去除稀疏内外生语义融合模块83.9580.6483.7982.79 去除风险语义压缩模块89.3982.2083.3784.99 将稀疏注意力替换为普通注意力93.9880.2878.9484.40 完整模型92.6582.1383.7086.16
本文方法通过静态标识、动态标识和关联日志构造外生语义,刻画电力数据流转过程中的数据属性、主体权限关系和流转合规约束。因此,本文方法在真实电力业务系统中的部署效果与安全标识覆盖程度、标识规则规范性和日志质量密切相关。
在数据完整性方面,系统应具备支撑外生语义构造的基本字段,包括数据分级、数据提供方、数据接收方、允许流转域、实际接收域、数据规模、时间戳、流转序号和签名状态等信息。其中,数据分级和允许流转域用于判断敏感数据是否超出规定范围流转,数据提供方和数据接收方用于刻画主体授权关系,时间戳和流转序号用于分析长时序累计导出行为,签名状态用于辅助判断标识可信度。若上述字段长期缺失,外生语义对风险识别的约束作用将减弱。
在标识规范性方面,不同电力业务系统之间可能存在字段命名、数据分级规则、主体编码和流转域编码不一致的问题。实际部署时,需要建立统一字段映射表和标识转换规则,将不同系统中的数据等级、主体身份、接收域和业务用途等字段映射到统一语义空间。对于跨系统、跨区域和跨主体的数据流转场景,还需要保证静态标识与动态标识之间的绑定关系可追踪,避免因标识规则不一致导致外生语义偏差。
在日志质量方面,流量记录、静态标识、动态标识和关联日志应具有统一或可换算的时间戳,并能够按照时间片完成对齐。对于部分标识字段缺失、更新不及时或日志记录不完整的情况,可采用缺失字段掩码或置信度降级机制进行处理。当模型输出高风险结果但关键标识字段缺失较多时,应将该类样本转入人工复核流程,以降低误报和漏报风险。
在安全标识覆盖较充分的场景下,本文方法能够利用外生语义增强对主体越权、跨域流转和累计导出等业务层风险的识别能力;在标识覆盖率较低、标识规则不一致或日志质量较差的场景下,外生语义约束会减弱,模型识别能力可能下降,甚至退化为主要依赖内生时序行为特征的检测模式。因此,本文方法更适用于已具备数据分类分级、标签标识、流转日志留存和审计追踪能力的电力业务系统。
本文面向电力业务系统中表面合法、过程隐蔽、低频分散和长时序累计的非常规泄露风险,围绕敏感数据违规流转、用户越权访问和长期累计导出三类典型场景,提出一种内外生语义协同的电力数据非常规泄露风险识别方法。该方法将时间片内的数据包聚合为时间片统计特征,并构成长时序窗口,刻画数据流转行为;基于静态标识、动态标识和静动态关联日志构造外生语义文本,补足单纯流量特征缺乏数据安全属性和流转约束表达的问题。在模型层面,本文设计稀疏内外生语义融合、风险语义压缩和跨模态重构机制,利用重构误差和归因向量实现非常规泄露风险识别。同时,本文构建了用于方法验证的PowerLeakage数据集,为后续相关研究提供了数据基础。后续工作将进一步结合真实电力业务系统流量和安全标识日志,完善数据集规模和场景覆盖范围,并重点研究标识字段缺失、标识规则不一致和日志质量不稳定条件下的鲁棒风险识别方法,提升所提方法在跨系统、跨区域和跨主体流转场景下的在线部署能力。
参考文献
[1] 国家能源局. 新型电力系统发展蓝皮书[R]. 北京: 国家能源局, 2023.
[2] 国家发展改革委, 国家能源局, 国家数据局. 加快构建新型电力系统行动方案(2024—2027年): 发改能源〔2024〕1128号[R]. 北京: 国家发展改革委, 国家能源局, 国家数据局, 2024.
[3] 丁正凯, 颜剑峰, 王蓓蓓. 电力数据资产价值化评估: 研究框架与展望[J]. 电工技术学报, 2026, 41(5): 1425-1449. Ding Zhengkai, Yan Jianfeng, Wang Beibei. The valuation of electricity power data assets: research framework and future prospects[J]. Transactions of China Electrotechnical Society, 2026, 41(5): 1425-1449.
[4] 郭庆来, 王博弘, 田年丰, 等. 能源互联网数据交易: 架构与关键技术[J]. 电工技术学报, 2020, 35(11): 2285-2295. Guo Qinglai, Wang Bohong, Tian Nianfeng, et al. Data transactions in energy Internet: architecture and key technologies[J]. Transactions of China Electro-technical Society, 2020, 35(11): 2285-2295.
[5] 黄彦钦, 余浩, 尹钧毅, 等. 电力物联网数据传输方案: 现状与基于5G技术的展望[J]. 电工技术学报, 2021, 36(17): 3581-3593. Huang Yanqin, Yu Hao, Yin Junyi, et al. Data transmission schemes of power Internet of Things: present and outlook based on 5G technology[J]. Transactions of China Electrotechnical Society, 2021, 36(17): 3581-3593.
[6] 国家市场监督管理总局, 国家标准化管理委员会.数据安全技术数据分类分级规则: GB/T 43697—2024[S]. 北京: 中国标准出版社, 2024.
[7] 全国网络安全标准化技术委员会秘书处. 网络安全标准实践指南—网络数据标签标识技术要求[R]. 北京: 全国网络安全标准化技术委员会, 2026.
[8] 张涛, 费稼轩, 王琦, 等. 电力信息物理系统跨域攻击协同防御架构及机制研究[J]. 电子学报, 2024, 52(4): 1205-1218. Zhang Tao, Fei Jiaxuan, Wang Qi, et al. Research of architecture and mechanism of coordinative defense methods for cross-domain attacks of cyber physical system[J]. Acta Electronica Sinica, 2024, 52(4): 1205-1218.
[9] Miao Weiwei, Zhao Xinjian, Zhang Yinzhao, et al. A deep learning-based method for preventing data leakage in electric power industrial Internet of Things business data interactions[J]. Sensors, 2024, 24(13): 4069.
[10] Jiang Chengzhi, Deng Song. Data leakage prevention system for smart grid[C]//1st International Conference on Big Data and Security (ICBDS 2019), Nanjing, China, 2019: 541-549.
[11] Deng Song, Yue Dong, Zhou Aihua, et al. Distributed content filtering algorithm based on data label and policy expression in active distribution networks[J]. Neurocomputing, 2017, 270: 159-169.
[12] Deng Song, Yuan Changan, Yang Jiquan, et al. Distributed mining for content filtering function based on simulated annealing and gene expression programming in active distribution network[J]. IEEE Access, 2017, 5: 2319-2328.
[13] Deng Song, Xie Xiangpeng, Yuan Changan, et al. Numerical sensitive data recognition based on hybrid gene expression programming for active distribution networks[J]. Applied Soft Computing, 2020, 91: 106213.
[14] Deng Song, Cai Qingyuan, Zhang Zi, et al. Data filter function incremental mining based on feature selection in an active distribution network[J]. IET Cyber-Physical Systems: Theory & Applications, 2020, 5(3): 301-309.
[15] 肖勇, 钱斌, 蔡梓文, 等. 电力物联网终端非法无线通信链路检测方法[J]. 电工技术学报, 2020, 35(11): 2319-2327. Xiao Yong, Qian Bin, Cai Ziwen, et al. Malicious wireless communication link detection of power Internet of thing devices[J]. Transactions of China Electrotechnical Society, 2020, 35(11): 2319-2327.
[16] 潘玺安, 艾欣, 胡俊杰, 等. 考虑网络安全约束的分布式智能电网边云协同优化调度方法[J]. 电工技术学报, 2024, 39(19): 6104-6118. Pan Xi’an, Ai Xin, Hu Junjie, et al. Network security constrained distributed smart grid edge-cloud collaborative optimization scheduling[J]. Transactions of China Electrotechnical Society, 2024, 39(19): 6104-6118.
[17] 崔沛然, 崔明建, 汪清, 等. 基于张量分解个性化联邦学习的网络-光伏爬坡协同攻击辨识[J]. 电工技术学报, 2025, 40(23): 7677-7693. Cui Peiran, Cui Mingjian, Wang Qing, et al. Cyber-ramping coordinated attack identification method for PV using a tensor decomposition based personalized federated learning[J]. Transactions of China Electro-technical Society, 2025, 40(23): 7677-7693.
[18] 李扬, 李智, 陈亮, 等. 发电机动态状态估计中的一种虚假数据注入攻击方法[J]. 电工技术学报, 2020, 35(7): 1476-1488. Li Yang, Li Zhi, Chen Liang, et al. A false data injection attack method for generator dynamic state estimation[J]. Transactions of China Electrotechnical Society, 2020, 35(7): 1476-1488.
[19] Berghout T, Benbouzid M, Muyeen S M. Machine learning for cybersecurity in smart grids: a comprehensive review-based study on methods, solutions, and prospects[J]. International Journal of Critical Infrastructure Protection, 2022, 38: 100547.
[20] Radoglou Grammatikis P, Sarigiannidis P, Efstatho-poulos G, et al. ARIES: a novel multivariate intrusion detection system for smart grid[J]. Sensors, 2020, 20(18): 5305.
[21] 王方雨, 刘文颖, 陈鑫鑫, 等. 基于“秩和”近似相等特性的同期线损异常数据辨识方法[J]. 电工技术学报, 2020, 35(22): 4771-4783. Wang Fangyu, Liu Wenying, Chen Xinxin, et al. Abnormal data identification of synchronous line loss based on the approximate equality of rank sum[J]. Transactions of China Electrotechnical Society, 2020, 35(22): 4771-4783.
[22] 申江卫, 岩川, 刘永刚, 等. 基于数据挖掘与大数据分析的电池故障诊断与异常检测[J]. 电工技术学报, 2024, 39(24): 7979-7994. Shen Jiangwei, Yan Chuan, Liu Yonggang, et al. Battery fault diagnosis and anomaly detection based on data mining and big data analysis[J]. Transactions of China Electrotechnical Society, 2024, 39(24): 7979-7994.
[23] 陈俊生, 李剑, 陈伟根, 等. 采用滑动窗口及多重加噪比堆栈降噪自编码的风电机组状态异常检测方法[J]. 电工技术学报, 2020, 35(2): 346-358. Chen Junsheng, Li Jian, Chen Weigen, et al. A method for detecting anomaly conditions of wind turbines using stacked denoising autoencoders with sliding window and multiple noise ratios[J]. Transactions of China Electrotechnical Society, 2020, 35(2): 346-358.
[24] 马然, 栗文义, 齐咏生. 风电机组健康状态预测中异常数据在线清洗[J]. 电工技术学报, 2021, 36(10): 2127-2139. Ma Ran, Li Wenyi, Qi Yongsheng. Online cleaning of abnormal data for the prediction of wind turbine health condition[J]. Transactions of China Electrotechnical Society, 2021, 36(10): 2127-2139.
[25] 马良玉, 程善珍. 基于支持向量数据描述和XGBoost的风电机组异常工况预警研究[J]. 电工技术学报, 2022, 37(13): 3241-3249. Ma Liangyu, Cheng Shanzhen. Abnormal state early warning of wind turbine generator based on support vector data description and XGBoost[J]. Transactions of China Electrotechnical Society, 2022, 37(13): 3241-3249.
[26] 李阳, 沈小军, 张扬帆, 等. 基于速度-关联约束的风电机组风速感知异常数据识别方法[J]. 电工技术学报, 2023, 38(7): 1793-1807. Li Yang, Shen Xiaojun, Zhang Yangfan, et al. Cleaning method of wind speed outliers for wind turbines based on velocity and correlation constraints [J]. Transactions of China Electrotechnical Society, 2023, 38(7): 1793-1807.
[27] 李阳, 沈小军, 杨伟新, 等. 基于运行数据的风电场风速传感器运行品质评价方法及应用[J]. 电工技术学报, 2024, 39(13): 4188-4203. Li Yang, Shen Xiaojun, Yang Weixin, et al. An operation quality evaluation method and its applications for wind speed sensors of wind farms based on operation data[J]. Transactions of China Electrotechnical Society, 2024, 39(13): 4188-4203.
[28] Elrawy M F, Hadjidemetriou L, Laoudias C, et al. Detecting and classifying man-in-the-middle attacks in the private area network of smart grids[J]. Sustainable Energy, Grids and Networks, 2023, 36: 101167.
[29] Gutiérrez Mlot E D, Saldana J, Rodríguez R J, et al. A dataset to train intrusion detection systems based on machine learning models for electrical substations[J]. Data in Brief, 2024, 57: 111153.
[30] Tuli S, Casale G, Jennings N R. TranAD: deep transformer networks for anomaly detection in multivariate time series data[J]. Proceedings of the VLDB Endowment, 2022, 15(6): 1201-1214.
[31] Hu Shiyan, Jin Jianxin, Shu Yang, et al. Towards multimodal time series anomaly detection with semantic alignment and condensed interaction[J/OL]. ArXiv, 2026: 2604 23972v1. (2026-03-23)[2026-07-08]. https://doi.org/10.48550/arXiv.2603.21612.
[32] Huet A, Navarro J M, Rossi D. Local evaluation of time series anomaly detection algorithms[C]// Proceedings of the 28th ACM SIGKDD Conference on Knowledge Discovery and Data Mining, Washington D.C., USA, 2022: 635-645.
[33] Paparrizos J, Boniol P, Palpanas T, et al. Volume under the surface: a new accuracy evaluation measure for time-series anomaly detection[J]. Proceedings of the VLDB Endowment, 2022, 15(11): 2774-2787.
Abstract With the continuous advancement of digital transformation in power grids, data interactions in power business systems have shown long-chain circulation characteristics across systems, regions, and entities. To address the difficulty of accurately identifying unconventional data leakage behaviors in power business systems, such as unauthorized circulation of sensitive data, over-privileged user access, and long-term cumulative data export, this paper proposes an endogenous-exogenous semantic collaborative method for power data leakage risk identification.
Firstly, power business traffic is aggregated by time slices and organized into long time-series windows, from which endogenous semantics are generated to describe behavioral features such as access frequency, data volume, receiver changes, and cumulative export volume. security labels and associated logs are used to construct exogenous semantics containing information such as data classification, permitted circulation domains, data providers, data receivers, and signature status. Sparse cross-attention associates circulation behavior with security-label semantics. The sparse relation mask is determined by predefined field mappings, temporal neighborhood relations, and top-k semantic similarity. These relations retain associations between traffic statistics and security-label fields while reducing interactions among weakly related time slices and semantic fields.
Secondly, risk semantic compression is applied to the fused representations. A learnable retention probability matrix and Bernoulli sampling preserve information related to subject authorization, circulation-path compliance, and long-term cumulative outflow. The compressed risk semantics are used to reconstruct masked numerical time-series windows. Reconstruction errors are converted into leakage risk scores, and the decision threshold is selected according to the Affiliated F1 score on validation set.
Thirdly, the PowerLeakage dataset is constructed from the ELECTRON-MITM-Attack Dataset and SANDI-2024. Based on publicly available power communication traffic data and in accordance with power data classification, grading, and security identification management requirements, the PowerLeakage dataset is constructed. While retaining the original traffic statistical characteristics, business scenario mappings, field-level security identifiers, subject authorization relationships, and time-slice-level risk labels are further generated to verify the proposed method's ability to identify unconventional power data leakage risks. The method is compared with recurrent neural network, long short-term memory, bidirectional long short-term memory, BiLC, TranAD, and MindTS under the same data split, window length, and evaluation metrics. The method obtains 92.65% for Aff-F, 82.13% for V-PR, and 83.70% for V-ROC. Ablation results show that removing exogenous semantic text reduces the average of the three metrics from 86.16 to 82.80, while removing sparse endogenous-exogenous semantic fusion reduces it to 82.79.
Finally, the results indicate that long time-series circulation behavior and security-label semantics provide complementary information for unconventional data leakage identification. Sparse semantic fusion, risk semantic compression, and cross-modal reconstruction associate circulation behavior with corresponding security constraints and quantify deviations related to subject authorization, circulation paths, and cumulative outflow.
keywords:Power data security, security labels, data leakage, long time-series traffic, sparse attention
DOI: 10.19595/j.cnki.1000-6753.tces.260839
中图分类号:TP309.2;TM769
国家电网有限公司总部科技项目资助(“标识驱动的电力敏感数据泄露感知与追踪溯源关键技术研究”52150025001H-146-ZN)。
收稿日期 2026-05-28
改稿日期 2026-07-08
费稼轩 男,1984年生,教授级高级工程师,研究方向为电力网络和数据安全、电力工控系统安全。E-mail:444965979@qq.com
张 涛 男,1976年生,教授级高级工程师,博士生导师,研究方向为电力网络和数据安全、电力工控系统安全。E-mail:zhangtao3@epri.sgcc.com.cn(通信作者)
(编辑 李 冰)